
多智能体系统运行所需的要素
本文信息来源:felicis
每个开发者头顶都悬着一个最大的问题是: 我们未来的 AI 技术栈会是什么样子?
软件操作过去需要数据库和需要人工输入的图形用户界面,但随着工作变得自主化,这种情况正在发生改变。
我们正在进入智能体基础设施的新时代,在这个时代中,基础原语不再是向量数据库或编排器,而是更具人性化的东西:收件箱和标准作业程序(SOP)。
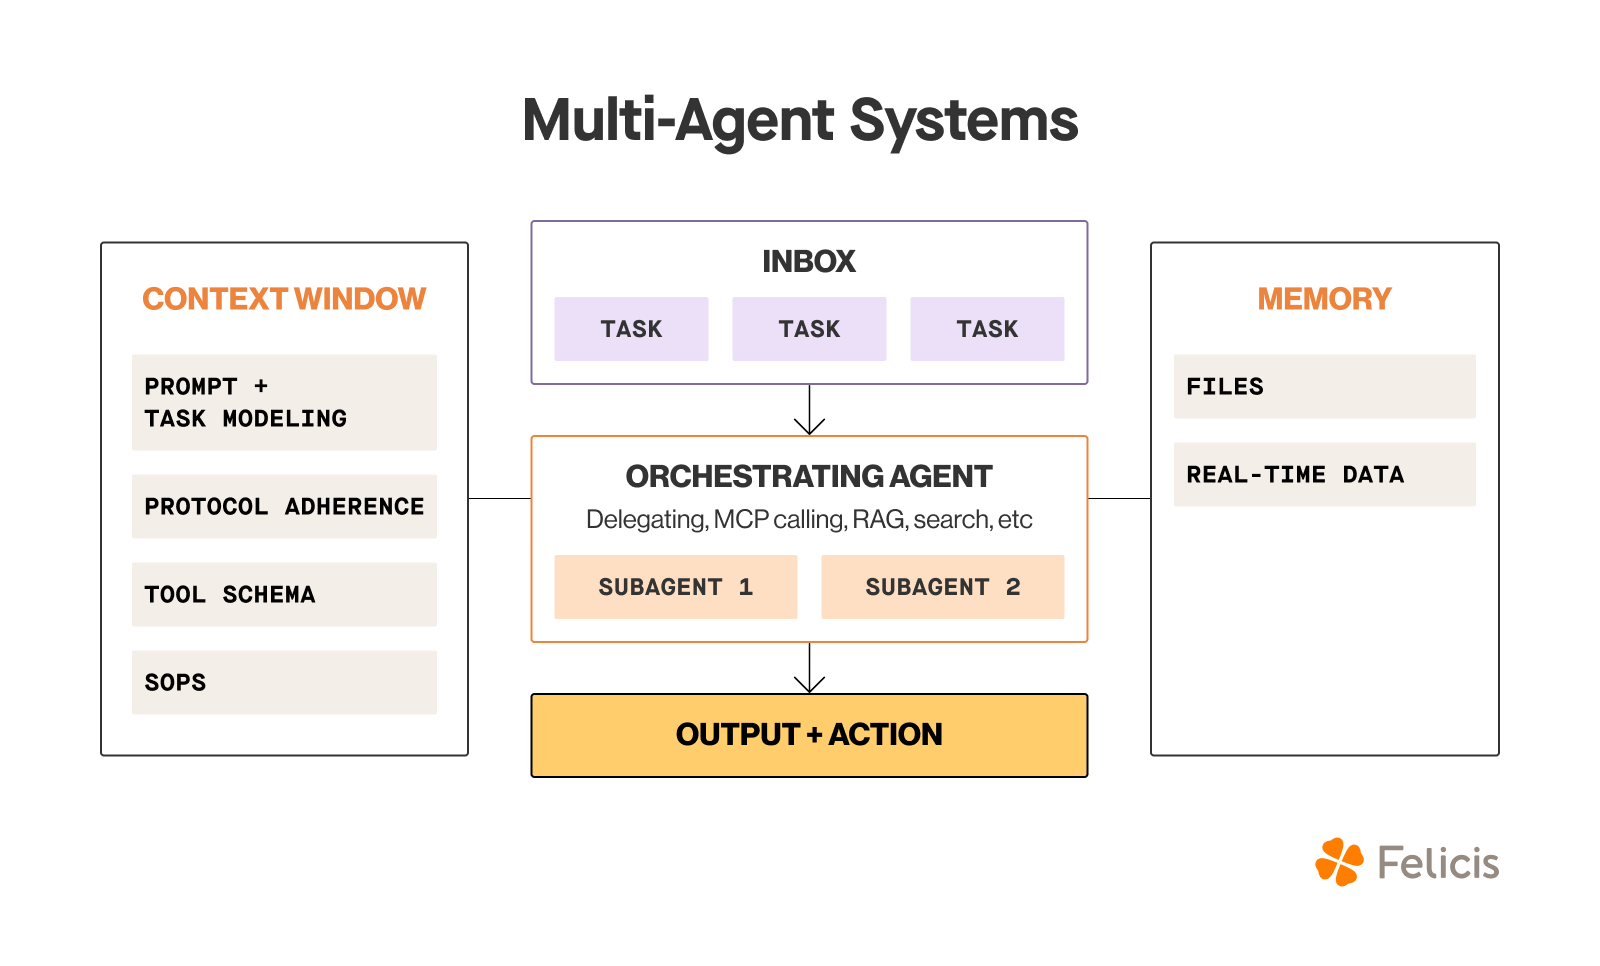
设想一下:每个自主智能体都有一个收件箱,就像我们一样。任务从多个来源流入——漏洞报告、Slack、API、人工请求。智能体进行分类、排序优先级并响应。它不需要每次都被告知该做什么。为什么?因为它有编码为可重用行为的 SOP。这些 SOP 就像智能行动的宏。它们不断演进、版本化并学习。
但这里有一个关键的推动因素:上下文工程。
上下文工程不仅仅是提示工程。它涉及在运行时动态地为 AI 提供正确的信息,比如数据和工具,以理想的结构呈现,从而充分装备模型来执行特定任务。我们不再只是用静态事实填充提示。上下文是动态的、结构化的、个性化的。这不仅仅是智能体知道什么,而是它如何以及何时知道。上下文工程意味着智能体需要执行的任务应该不断地重新排序。 可以将其视为认知的 DevOps。 工具和平台将会出现,帮助团队设计、存储、调用、测试和部署”上下文模块”,就像他们部署代码一样。
“上下文工程是一门精妙的艺术和科学,需要在上下文窗口中填充恰好适合下一步的信息。”
这是一个根本性的转变。上下文工程涉及在最终模型调用之前运行额外的步骤,比如从知识库检索、工具选择、任务建模和协议遵循。基础设施将不再专注于管道,而是帮助规划如何完成整体任务。不再是把 LLM 当作神谕,而是把 LLM 当作你友善的运维队友。
上下文工程旨在通过仅向模型提供最相关的上下文来实现平衡。LLMs 的上下文窗口有限,因此选择在该窗口中放入什么内容至关重要。相反,添加过多不相关或结构不良的信息可能会恶化模型的输出质量(这种现象被称为”迷失在中间”或随着提示变得过于庞大而经历”上下文腐化”)。上下文工程是关于最大化提示的有效信息密度。
在我们快速到来的未来中,智能体不会被视为聊天机器人。而且你不会只使用一个。通过上下文工程,智能体将成为编排子智能体队列的流程负责人。它们将有一个任务收件箱需要管理,一套遵循的规程手册,以及对什么重要、为什么重要的持续改进理解。规划智能体将访问收件箱,并为特定的子智能体提供适当的上下文。
需要明确的是,我们距离这种智能体现实还很遥远。采用仍面临重大障碍——数据仍然是智能体能力的主要瓶颈。 计算机使用基准测试仍然很低(OSWorld 上 38.1%,WebArena 上 58.1%,WebVoyager 上 87%)。像 OpenAI 和 Anthropic 这样的前沿实验室预计将大量投资来改进这些。像 Browserbase、Browser Use、Letta、n8n 等风险投资支持的初创公司正在推动智能体优先基础设施的边界。
然而,这个奖励足够巨大——OpenAI 预测到 2030 年,智能体的销售额将超越 ChatGPT。这也是合理的,当一个具备正确上下文工程的智能体能够更务实地运作时,开发者为什么还要花时间将几个提示词串联在一起呢?
我们知道基础要素正在改变。但我们可能没有预料到的是,自动化的未来看起来更像是人类,只是更快、不知疲倦且可编程。
如果你正在为这个由上下文工程驱动的世界构建产品,请让你的智能体联系我的智能体。