
本文信息来源:xange
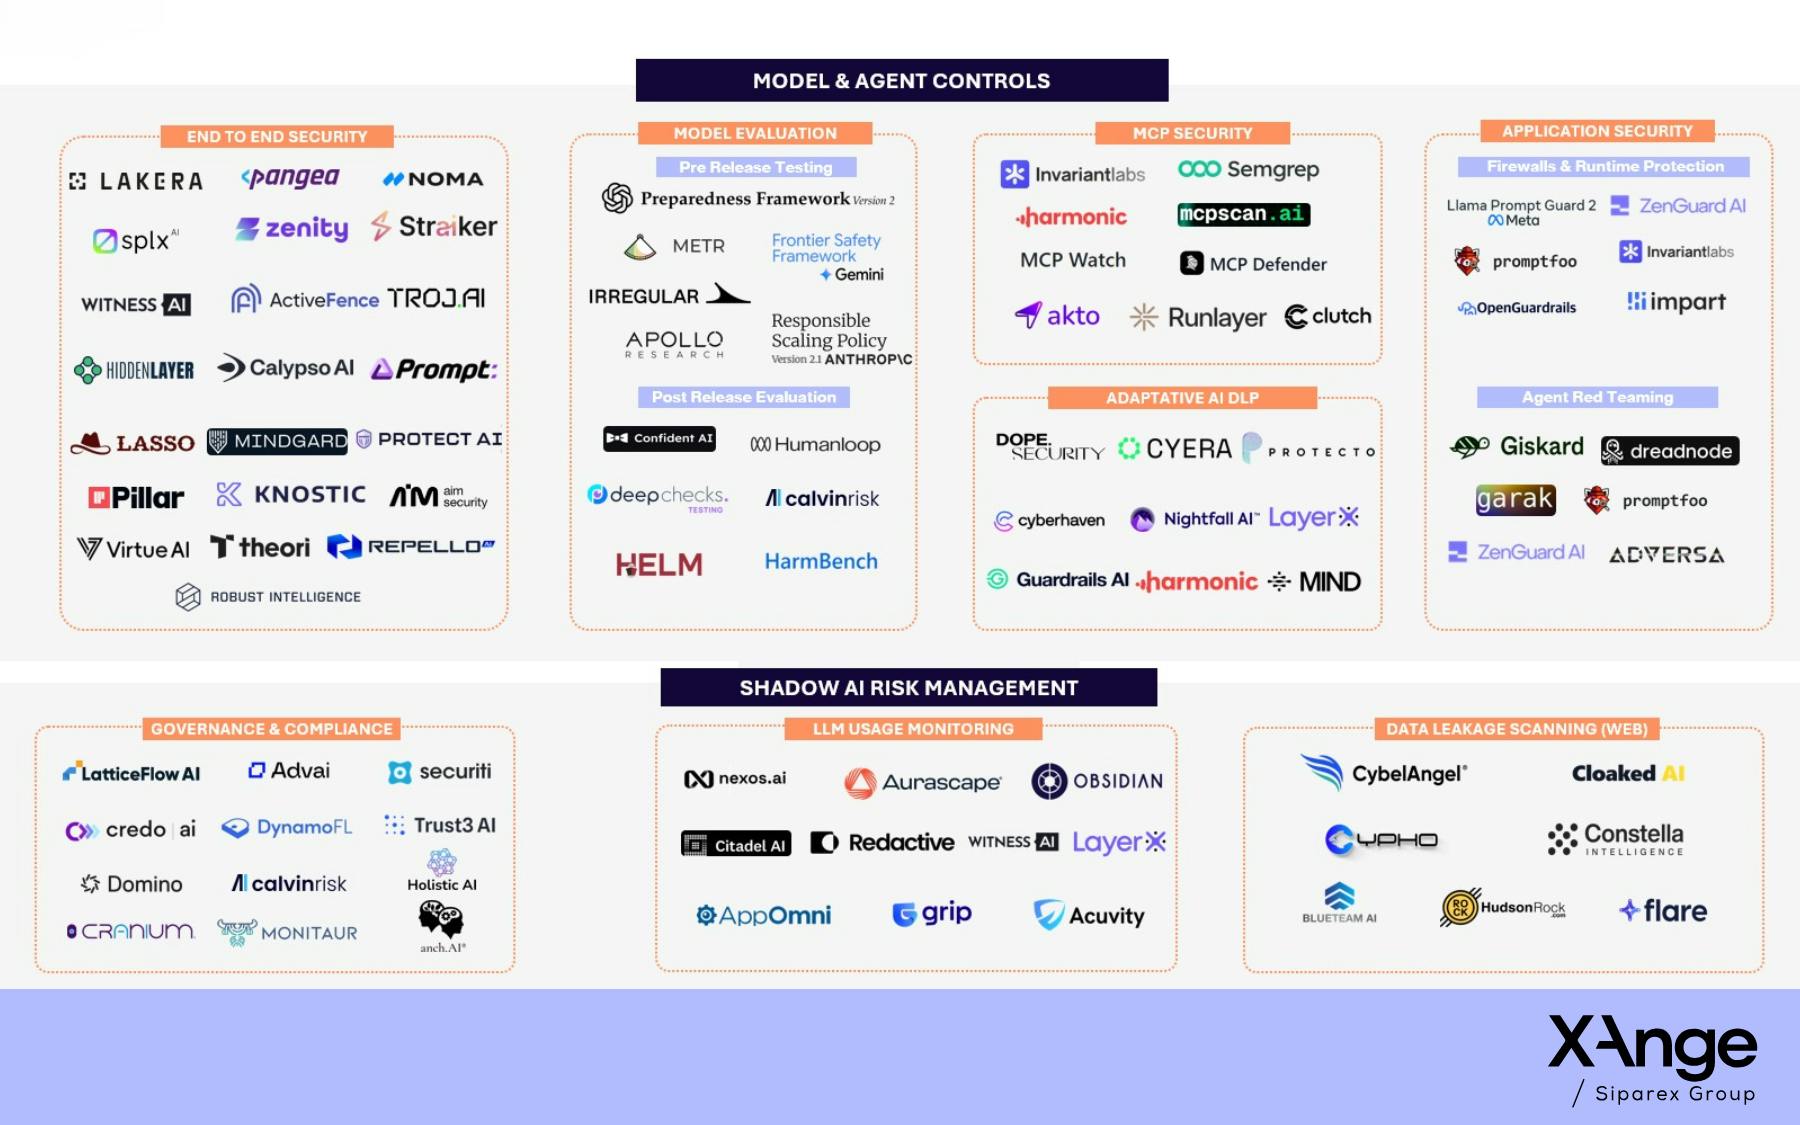
企业对 AI 的采用已从实验阶段转变为嵌入式行为。LLMs 现已遍布各类工作流程、产品和内部工具,其普及速度往往快于安全团队能够进行有效治理的速度。结果是,AI 系统的使用方式与其被保护的方式之间出现了不断扩大的差距。
这并非理论问题。大多数企业承认自己尚未为 AI 监管合规做好准备 :一项针对 200 多位全球 CISOs 的 2025 年调查显示,70% 的组织将 AI 驱动的数据泄露列为今年最主要的安全担忧。在攻击者一侧,AI 意味着攻击的规模化扩散。AI 驱动的数据泄露和 AI 生成的攻击,已经成为 CISOs 需要切实应对的现实事件。
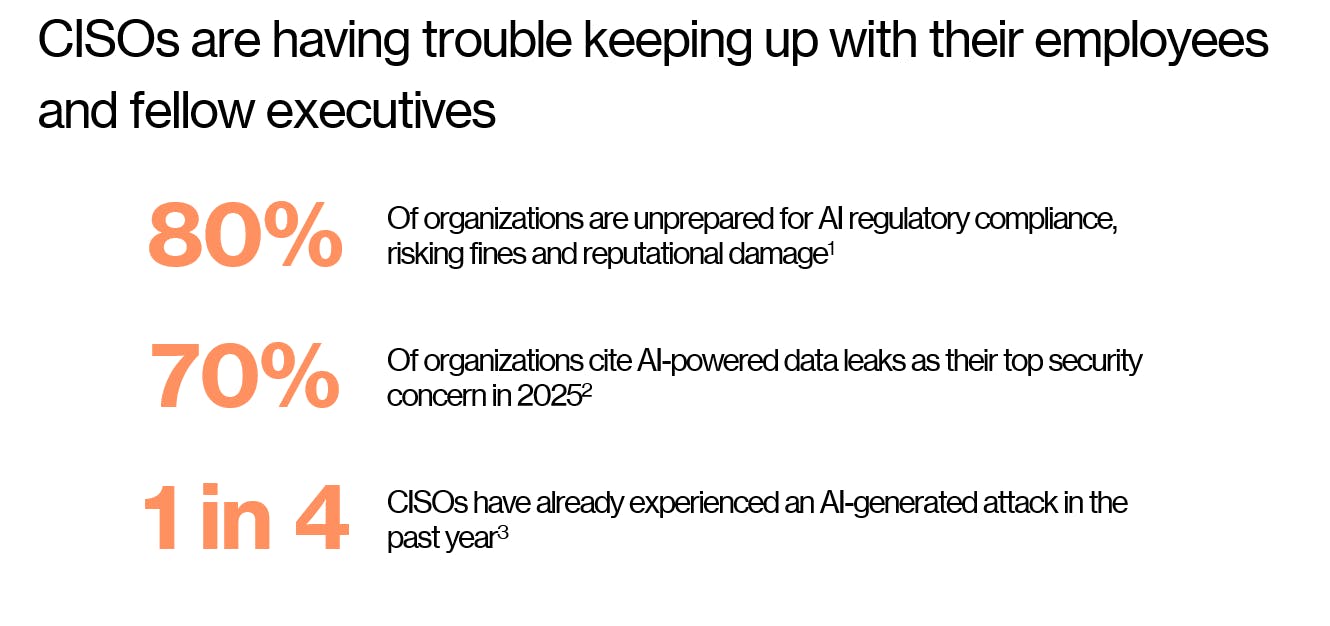
这是一次风险显著上升且风险形态全新的“完美风暴”,而传统安全工具从未被设计用来应对这种局面。
两类风险,一个共同的盲区
在实践中,AI 安全风险主要集中在两个向量上。
第一,未受监管的 AI 使用。 员工采用公共 LLMs、浏览器扩展和 copilot 的速度,快于 IT 部门批准它们的速度 。敏感数据被粘贴进 prompt,输出在下游被重复使用,却不存在任何集中化的可视性。影子 IT 演变成了影子 AI。
第二,即便是已获批准的 AI 系统也同样脆弱。由 LLM 驱动的应用和 agent 在 prompt injection、数据泄露、被投毒的依赖项、过度自治以及未经验证的输出方面具有独特的脆弱性。这些系统的失败方式不同于传统软件。它们以语言层面、概率层面失败,而且往往在造成损害之前几乎不可察觉。

在这些风险中,prompt injection 显得尤为具有结构性危险。 当一个 AI 系统既能摄取不可信内容、访问私有数据,又能对外通信时,就形成了一个“致命三要素”。在这种配置下,单一的恶意输入就可能劫持系统、提取机密数据,并在不触发传统安全告警的情况下将其外泄。大型科技公司的真实世界事件已经证明了这一套完整的攻击路径。
在 Google 发布其由 Gemini 驱动的 AI 编程工具 Antigravity 后的 24 小时内,一名安全研究人员演示了:只需一段恶意代码片段,一旦被标记为“trusted”,就可以重新编程该代理的行为并植入持久化后门。 该 AI 获得了对本地文件的持续访问权限,能够在重启和重新安装后依然存活,并可被用于数据外泄或部署勒索软件。整个过程无需任何基础设施层面的漏洞利用。此次失败直接源于代理式自治、过于宽泛的系统访问权限,以及对未经审查输入的错误信任。
模型提供商确实有一些解决方案,但仅靠它们无法解决问题
Anthropic、Meta 和 Open AI 等模型厂商正在作出回应。防护栏、红队测试流程、提示防护以及输出过滤器都在迅速改进。这些努力很重要,但仍然不足。
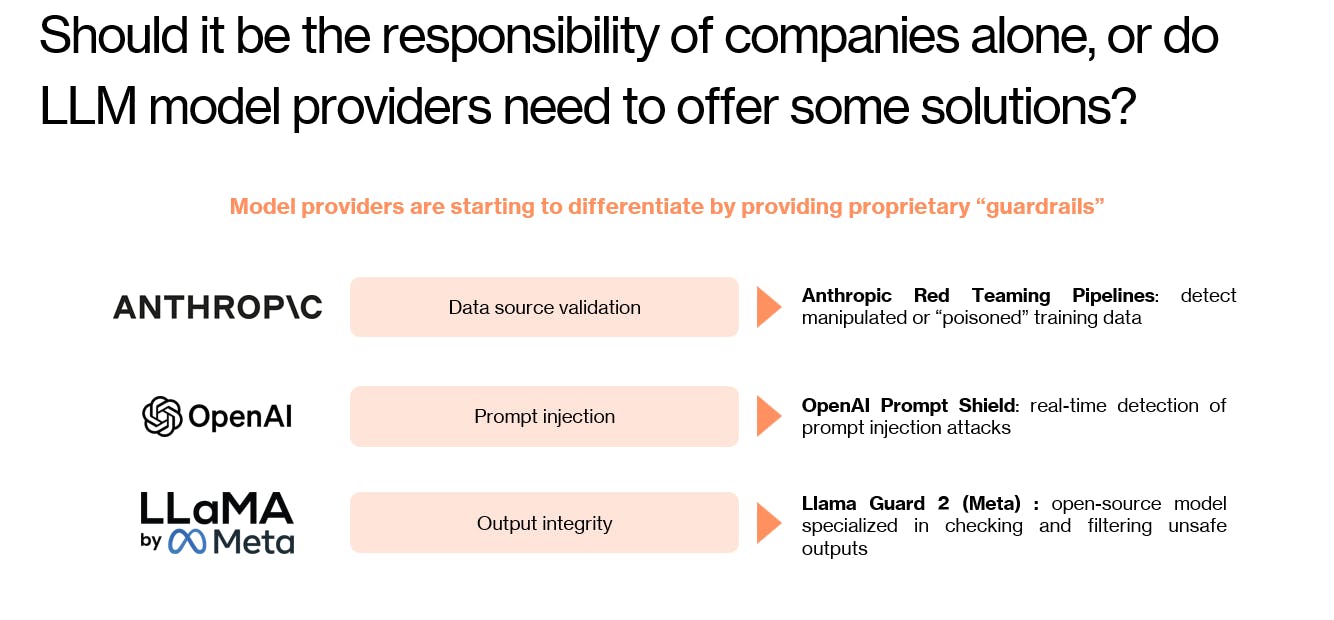
模型级安全只约束模型生成的内容,而不涉及其周边发生的事情。企业级 AI 系统运行在复杂的应用程序技术栈之中,包含定制的数据流、权限、API 以及业务逻辑。攻击具有强烈的上下文相关性,恶意提示往往与良性提示难以区分,尤其是在嵌入代码、文档或第三方内容时。
期望前沿模型能够完全理解并强制执行各个组织的安全政策并不现实,AI 安全也无法外包给模型层。
登场:AI 安全技术栈的兴起
这一缺口正在推动安全市场发生结构性转变。
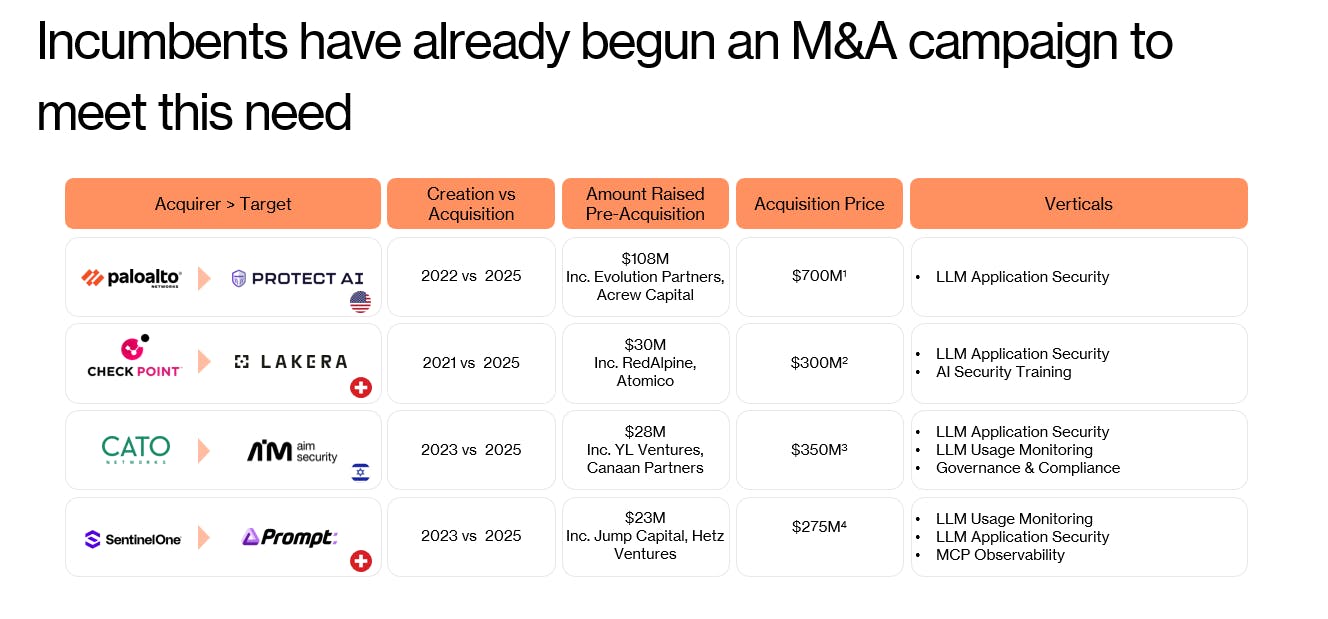
既有厂商已经意识到这一转变,并正在积极进行收购(参见:Palo Alto 今年以 7 亿美元收购 Protect AI),这表明 AI 应用安全和代理控制正在成为核心安全原语,而非小众的附加功能。
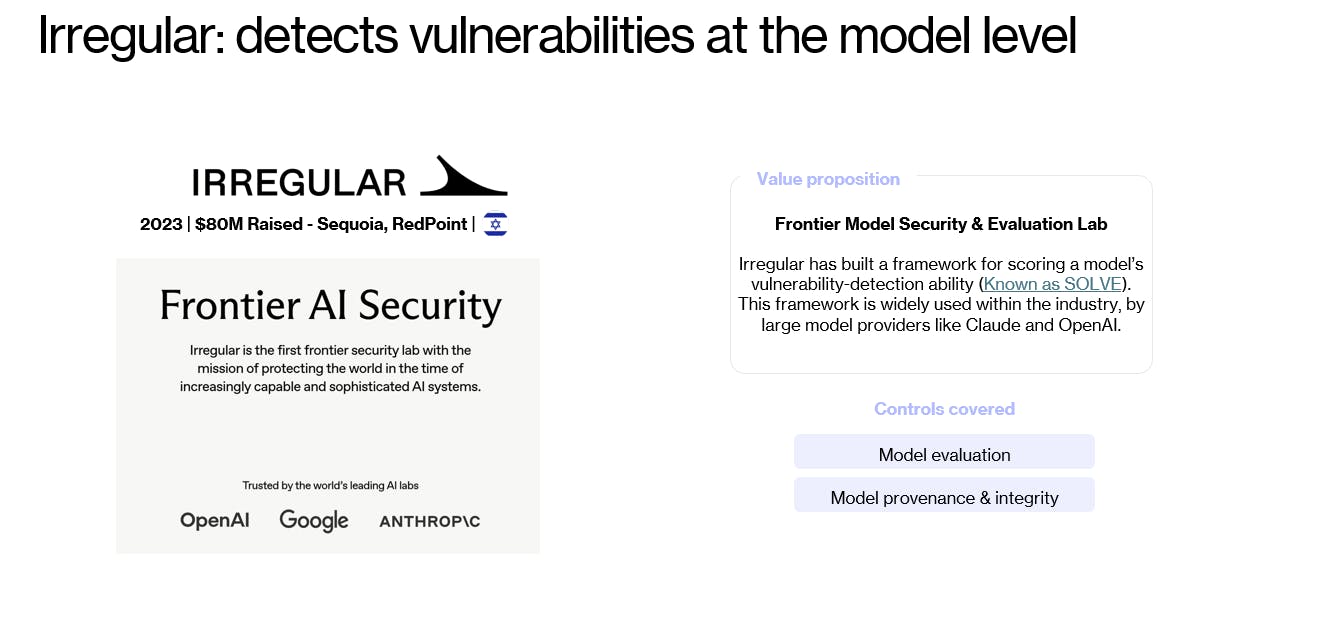
AI 安全的第一波浪潮聚焦于模型评估、溯源和红队测试。这些工具(如 Irregular)正在回答一个重要的首要问题:“这个模型在原则上是否安全?”
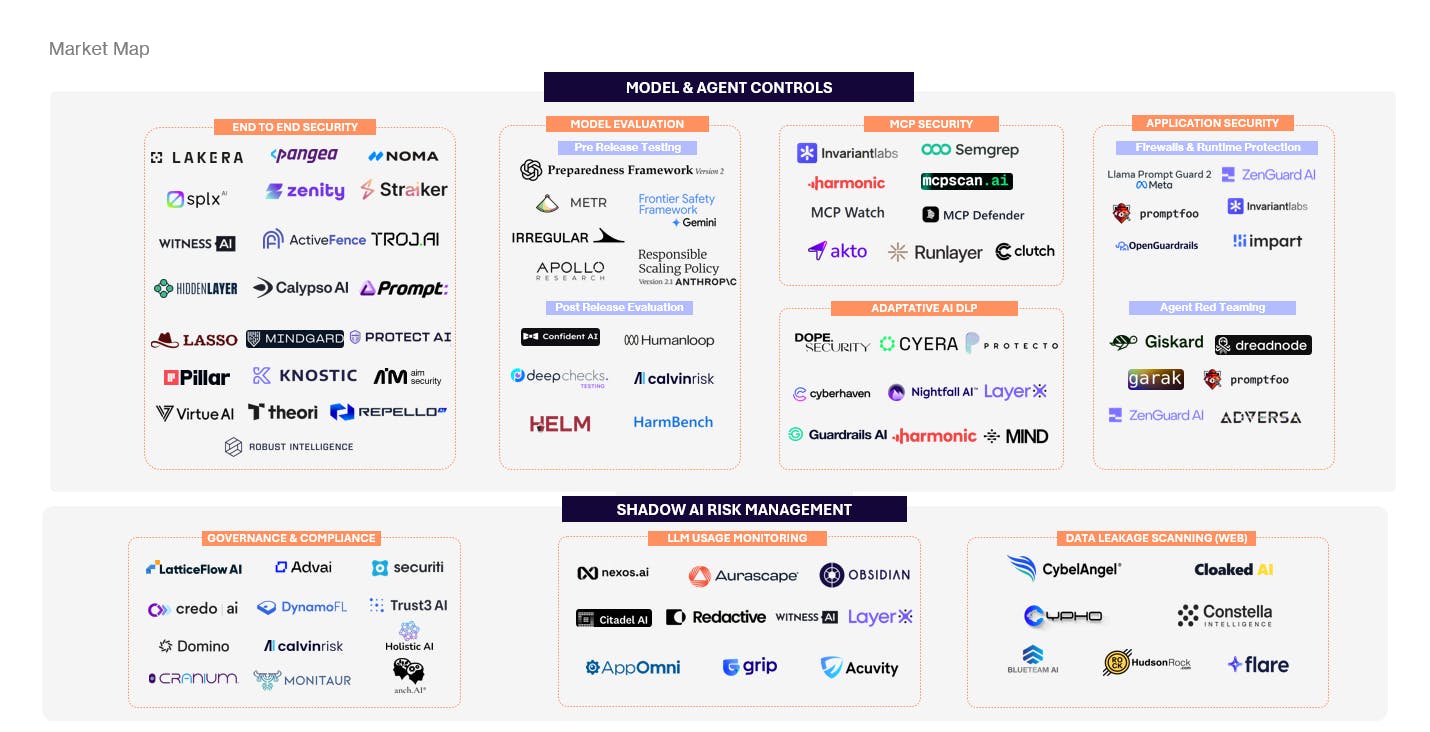
第二波正在兴起,重点聚焦于企业级与应用层控制。这类解决方案在 AI 实际运行的地方提供安全保障:在运行时、在工作流中、在智能体内以及在数据路径上。它们对智能体可访问的工具进行治理,对执行过程进行沙箱化,实时执行策略,监控使用情况,并在经批准与影子 AI 环境中检测数据泄露。
· 获得 Khosla 支持的 Runlayer 构建了一个专为 MCP 基础设施打造的安全平台,用于控制和验证代理工具调用、对执行进行沙箱化,并提供对代理活动的深度可见性,以在运行时防止未经授权或危险的行为
· Straiker’s 端到端代理防护平台对代理行为、工具使用和浏览器行为实施实时策略,重点在于在保持全流程可审计性的同时防止数据泄露
· Witness 采用企业级 AI 治理与控制方法——为安全团队提供对整个组织内 AI 使用情况的可见性,对公共和私有 LLMs 实施集中式策略,并管理合规与员工使用,以降低影子 AI 风险
CISO 与构建者应当内化的关键认知
对于安全领导者而言,结论十分明确:AI 将攻击面从基础设施和代码扩展到语言、自主性和决策层面。要控制风险,需要对 AI 使用情况的可见性、对代理行为的约束,以及在应用层进行执行,而不仅仅是在模型边界进行控制。
对于构建者而言,这是一次代际机遇。企业正积极寻找在不牺牲控制、合规或信任的前提下采用 AI 的方式。真正的赢家不会是那些承诺模型完美对齐的人,而是那些为组织提供工具,使其能够安全运行并不完美模型的人。
AI 时代的安全不再只是防止系统被攻破,而是防止系统被“说服”。
你是一位在 AI 安全领域创业的欧洲创始人吗?我们很乐意听听你的想法!
本文由 Timothée Bourgeois 参与撰写。