
本文信息来源:databricks

在这篇博客中,我们将深入探讨基于人类反馈的智能体学习(ALHF)——一种全新的机器学习范式,在这种范式中,智能体直接从最少的自然语言反馈中学习,而不仅仅依赖数值奖励或静态标签。这为企业应用中智能体的更快速、更直观的适应能力打开了大门,因为企业的期望往往具有专业化且难以形式化的特点。
ALHF 为 Databricks 的 Agent Bricks 产品提供支持。在我们的案例研究中,我们关注 Agent Bricks Knowledge Assistant (KA)——它通过专家反馈不断改进其回答。如图 1 所示,ALHF 在 Databricks DocsQA 上仅需 4 条反馈记录,就能显著提升整体回答质量。仅凭 32 条反馈记录,我们就能将回答质量提升到静态基线的四倍以上。我们的案例研究展示了 ALHF 的有效性,并为智能体研究开辟了一个极具吸引力的新方向。

可教 AI 智能体的前景
在与 Databricks 的企业客户合作过程中,我们发现的一个关键挑战是,许多企业 AI 用例依赖于高度专业化的内部业务逻辑、专有数据和内在预期,而这些在外部是未知的(参见我们的领域智能基准 了解更多)。因此,即使是最先进的系统,仍然需要大量调优才能达到企业用例的质量标准。
为了调整这些系统,现有方法依赖于明确的真实输出(收集成本高昂)或仅提供二进制/标量信号的奖励模型。为了解决这些挑战,我们提出了基于人类反馈的智能体学习(ALHF),这是一种学习范式,其中智能体通过结合少量来自专家的自然语言反馈来调整其行为。该范式为人机交互提供了一种自然且高效的途径,并使系统能够从丰富的期望信号中学习。
示例
假设我们创建了一个问答(QA)智能体,为一家托管数据库公司回答问题。以下是一个示例问题:

该代理建议使用函数 weekofyear(),该函数在多种 SQL 方言(MySQL、MariaDB 等)中均受支持。这个答案在适当使用时确实可以实现所需功能。然而,它在 PostgreSQL 中并不受支持,而 PostgreSQL 是我们用户群体偏好的 SQL 方言。我们的主题专家(SME)可以对该回答提供自然语言反馈,以传达上述期望,代理将据此进行调整:

ALHF 不仅会针对这个单一问题调整系统响应,还会在未来对反馈相关的问题进行调整 ,例如:

正如这个例子所示,ALHF 为开发者和 SME 提供了一种无摩擦且直观的方式,通过自然语言引导代理的行为,使其与他们的期望保持一致。
Agent Bricks 中的 ALHF
我们将以 Agent Bricks 产品的一个特定用例—— 知识助手 ——作为案例研究,来展示 ALHF 的强大能力.
知识助手(KA) 提供了一种声明式的方法,在您的文档之上创建聊天机器人,并提供带有引用的高质量、可靠的回答。KA 利用 ALHF 从自然语言反馈中持续学习专家的期望,并提升其回答的质量。
KA 首先会请求高层次的任务指令。一旦连接到相关的知识源,它就会开始回答问题。专家随后可以利用提升质量模式来审查回答并留下反馈,KA 会通过 ALHF 吸收这些反馈,从而优化未来的回答。
评估
为了展示 ALHF 在 KA 中的价值,我们使用 DocsQA ——一个包含 Databricks 文档相关问题及参考答案的数据集,对 KA 进行评估,该数据集是我们领域智能基准的一部分。对于该数据集,我们还定义了一套专家期望。针对 KA 生成的一小组候选回答,我们基于这些期望创建简短的自然语言反馈 (如上例所示),并将反馈提供给 KA 以优化其回答。然后,我们在多轮反馈中测量回答质量,以评估 KA 是否能够成功适应并满足专家期望。
请注意,虽然参考答案体现了事实正确性 ——即答案是否包含与问题相关且准确的信息——但它们在与专家期望保持一致方面不一定是理想的。正如我们在前面的示例中所示,初始回答对于许多 SQL 变体来说可能在事实层面是正确的,但如果专家期望的是针对 PostgreSQL 的特定回答,它仍可能有所不足。
考虑到这两个正确性的维度,我们使用两个 LLM 评审来评估回复的质量:
- 答案完整性: 响应与数据集中参考答案的契合程度。这作为事实正确性的基准衡量标准。
- 反馈 遵从性: 响应在多大程度上满足特定专家的期望。这衡量了智能体根据个性化标准调整输出的能力。
结果
图 2 展示了在 DocsQA 上,随着专家反馈轮次的增加,KA 的质量如何提升。我们报告的是保留测试集的结果。
- 答案完整性: 在没有反馈的情况下,KA 已经能够生成与领先竞争系统相媲美的高质量回答。通过最多 32 条反馈,KA 的答案完整性提升了 12 个百分点,明显优于竞争对手。
- 反馈遵循度: 反馈遵循度与答案完整性之间的区别很明显——在没有反馈的情况下,所有系统的遵循度得分都很低。但这正是 ALHF 的优势所在:在有反馈的情况下,KA 的遵循度得分从 11.7% 跃升至接近 80%,充分展示了 ALHF 的显著影响。

总体而言,ALHF 是一种有效的机制,可以优化和调整系统行为,以满足特定专家的期望。尤其是它的样本效率非常高:你不需要数百或数千个示例,只需少量反馈就能看到明显的提升。.
ALHF:技术挑战
这些令人印象深刻的结果之所以可能,是因为 KA 成功解决了 ALHF 的两个核心技术挑战。
学习何时应用反馈
当专家对一个问题提供反馈时,代理如何知道哪些未来的问题应该从同样的见解中受益?这就是范围界定的挑战——确定每条反馈的适用范围。换句话说,就是确定一条反馈与某个问题的相关性。
以我们的 PostgreSQL 示例为例。当专家说“答案应与 PostgreSQL 兼容”时,这条反馈不应只修正那一个回答,而应影响到所有未来与 SQL 相关的问题。但它不应影响无关的查询,比如“我应该用 matplotlib 还是 seaborn 来绘制这个图表?”
我们采用了一种代理记忆的方法,记录所有先前的反馈,并允许代理高效地为新问题检索相关反馈。这使得代理能够动态且全面地判断哪些见解与当前问题最相关。
调整合适的系统组件
第二个挑战是 分配 —— 确定系统的哪些部分需要根据反馈进行更改。KA 不是单一模型;它是一个多组件的流水线,负责生成搜索查询、检索文档并生成答案。有效的 ALHF 需要以正确的方式更新正确的组件。
KA 由一组由 LLM 驱动的组件构成,这些组件通过反馈进行参数化。每个组件都是一个模块,可以接收相关反馈并据此调整其行为。以之前的例子为例,SME 针对日期提取示例提供了如下反馈:

之后,用户提出了一个相关问题——“我如何在 SQL 中获取两个日期之间的差值?”。在没有收到任何新反馈的情况下,KA 会自动应用它从之前交互中学到的内容。它首先在检索阶段修改搜索查询,使其更贴合上下文:

然后,它会生成一个特定于 PostgreSQL 的响应:
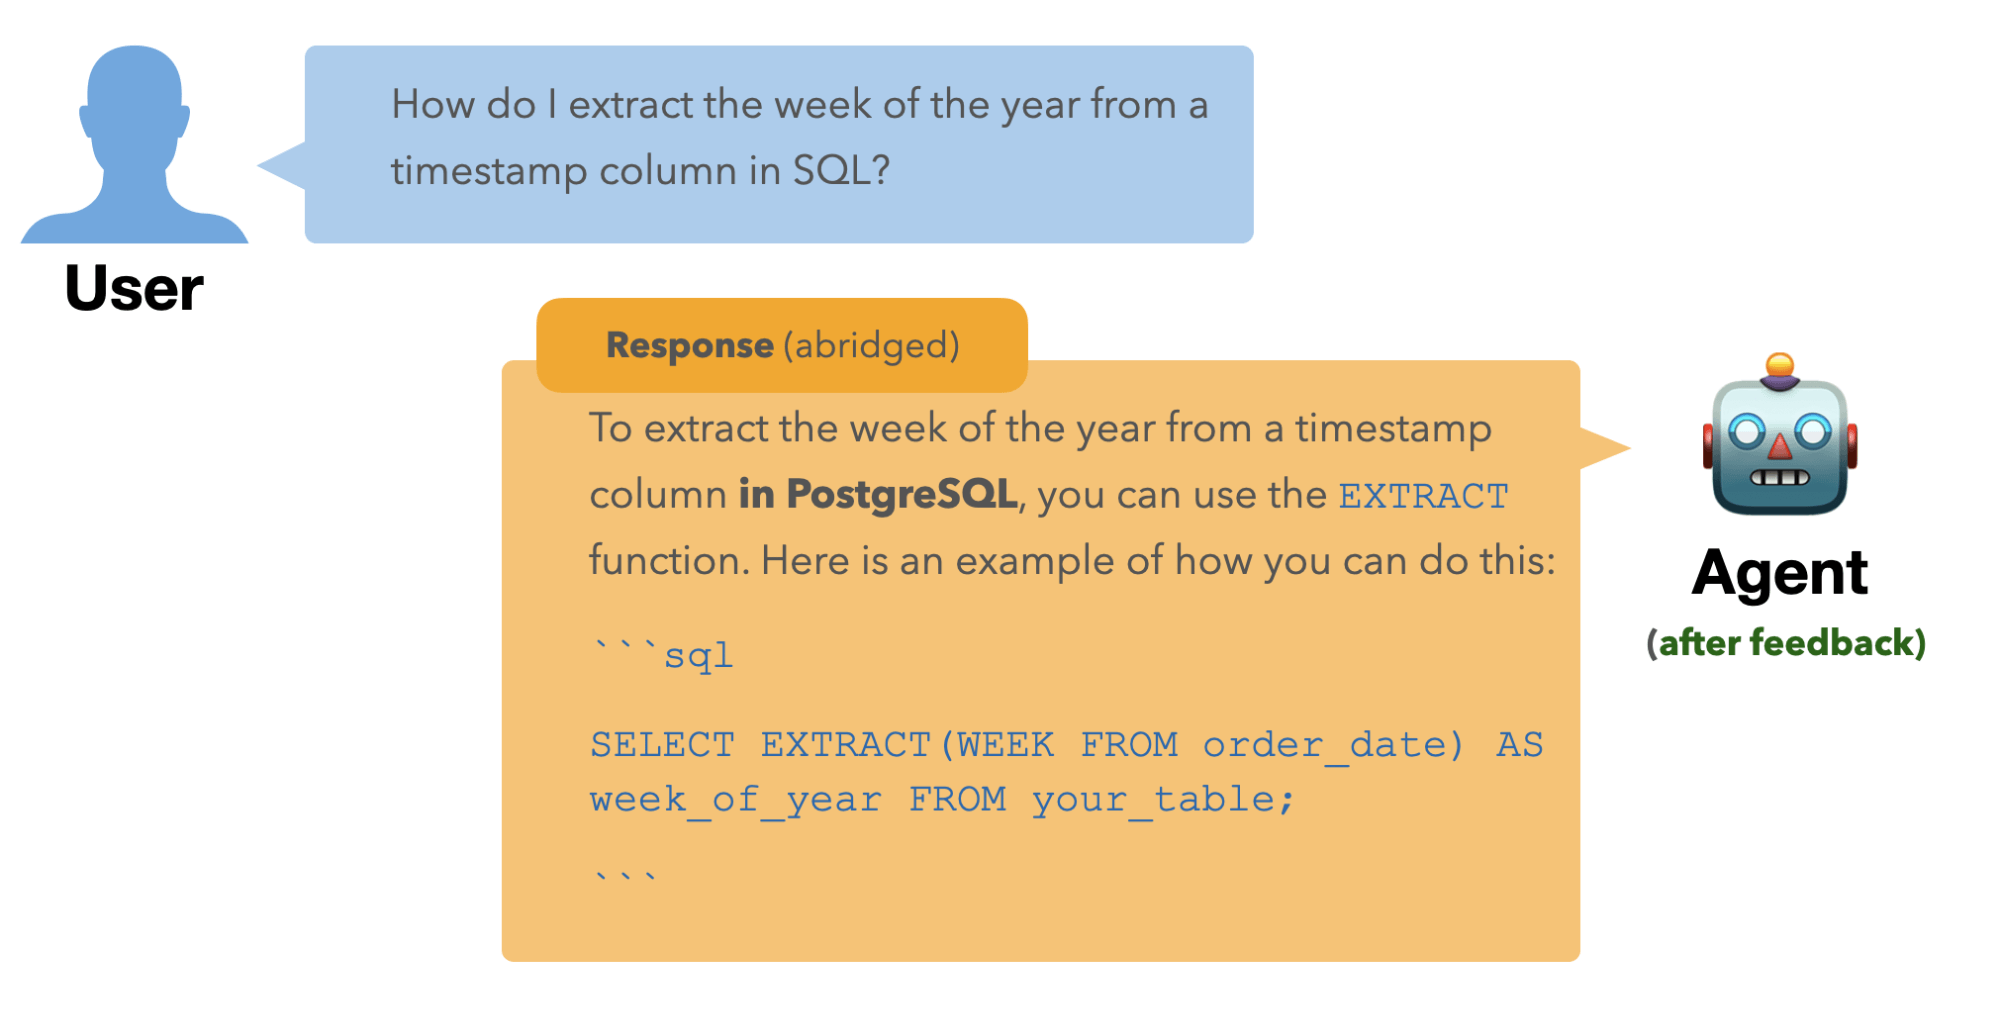
通过将反馈精确地路由到合适的检索和响应生成组件,ALHF 确保代理能够有效地从专家反馈中学习和泛化。
ALHF 对你的意义:深入了解 Agent Bricks
Agent Learning from Human Feedback (ALHF) 代表了让 AI 智能体真正理解并适应专家期望的重要进步。通过让自然语言反馈逐步塑造智能体的行为,ALHF 提供了一种灵活、直观且强大的机制,将 AI 系统引导至满足特定企业需求。我们与 Knowledge Assistant 的案例研究表明,即使在反馈极少的情况下,ALHF 也能显著提升响应质量和对专家期望的符合度。正如 Analytics8 的首席技术官、KA 客户 Patrick Vinton 所说:
“借助 Agent Bricks,Analytics8 在我们的用例中实现了答案准确率提升 40%,实施时间加快 800%,涵盖了从简单的人力资源助手到基于极其技术性、多模态白皮书和文档的复杂研究助手。上线后,我们还观察到答案质量持续提升。”
ALHF 现已成为 Agent Bricks 产品的内置功能,帮助 Databricks 客户部署高度定制化的企业级 AI 解决方案。我们鼓励所有有兴趣利用可教 AI 强大能力的客户联系他们的 Databricks 客户团队 ,并尝试 KA 及其他 Agent Bricks 的使用案例,以探索 ALHF 如何改变他们的生成式 AI 工作流程。
Veronica Lyu 和 Kartik Sreenivasan 贡献相同