

行业正放弃雇佣非洲和亚洲零工经济劳动者,以推动构建”更智能”模型

企业价值,按年和公司成立日期(十亿美元)
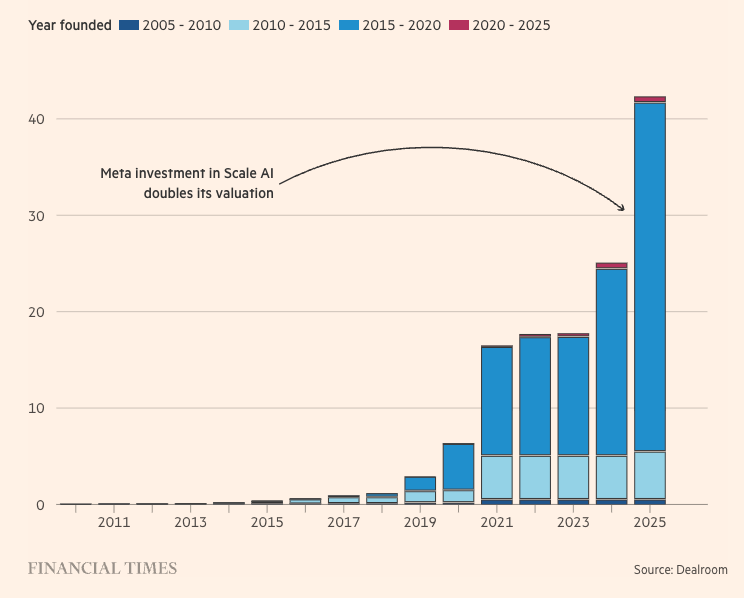
过去数据标注员只需处理简单任务,例如在图像上绘制方框识别物体、描述图像内容、筛选流畅表达方式,以及从常含暴力或图像化内容的数据集中剔除不良答案。
由于 AI 模型需要更多数据来提升性能,这些工作者曾被要求在数秒内处理任务,每天完成数百项任务以构建庞大的数据集。
梅戈尔斯卡娅表示,随着许多此类任务可实现自动化,相关需求已大幅下降。
肯尼亚数据标注员协会主席琼·金尤阿指出,他们现在承接的工作需要依赖本地化语言技能和专业知识。该协会还发现,部分工作开始要求人工标注员对 AI 生成内容进行最终质量检查。
随着 OpenAI、Anthropic 和谷歌等领先 AI 团队试图开发据称将超越人类智能的模型,行业正掀起新一轮注重数据集质量、聘请专家解决复杂问题的风潮。
“这些模型现在需要的是真实人类使用模型进行知识工作的数据,以及模型出错时获得的反馈,”数据标注公司 Turing AI 联合创始人兼首席执行官乔纳森·西达尔思表示。
为确保模型在从编程到物理和金融等广泛领域中表现良好,资金雄厚的人工智能公司现在愿意为更复杂的数据集和来自全球各地的专家付费。
西达尔思称,为吸引来自不同行业的人才,Turing 支付给专家的薪酬比他们现有工作高出 20-30%。他补充说,虽然数据预算仅占人工智能公司在计算能力上花费的数千亿美元的 10-15%左右,但这仍然是”一笔巨额资金”。
Toloka 公司梅戈尔斯卡娅表示,诸如”思维链”这类展示 AI 模型逐步解决问题过程的新功能,是通过让人类专家示范如何拆解问题而开发出来的。
经验丰富的软件工程师可能还需要根据其专业领域设计相关任务,然后通过编写代码、调试程序及检查安全漏洞来解决问题。
与此同时,验证一个物理学理论需要物理学家贡献如何构建模拟器来检验理论真伪的见解,软件工程师负责编写模拟器代码,以及数据科学家分析模拟结果。
“这样做的结果是,模型不仅会比物理学家更出色,还将超越那些在物理学、计算机科学和数据科学领域顶尖人才的叠加水平,”图灵公司的西达尔特表示。