
本文信息来源:garymarcus
一次发布搞砸了……以及一篇预示麻烦的新研究论文
生成式人工智能度过了真正糟糕的一周。迟到且令人失望的 GPT-5 的发布甚至还不是最糟的部分。但在谈到最糟的部分之前(剧透:我将在文末讨论的一篇新研究论文),先回顾一下 GPT-5 那混乱的首秀。
本该是 OpenAI 最终巩固其主导地位的一周。传闻已久的 GPT-5 即将登场。Sam Altman 在直播首秀前自信得不得了,他发了一张《星球大战》电影《侠盗一号》的截图:
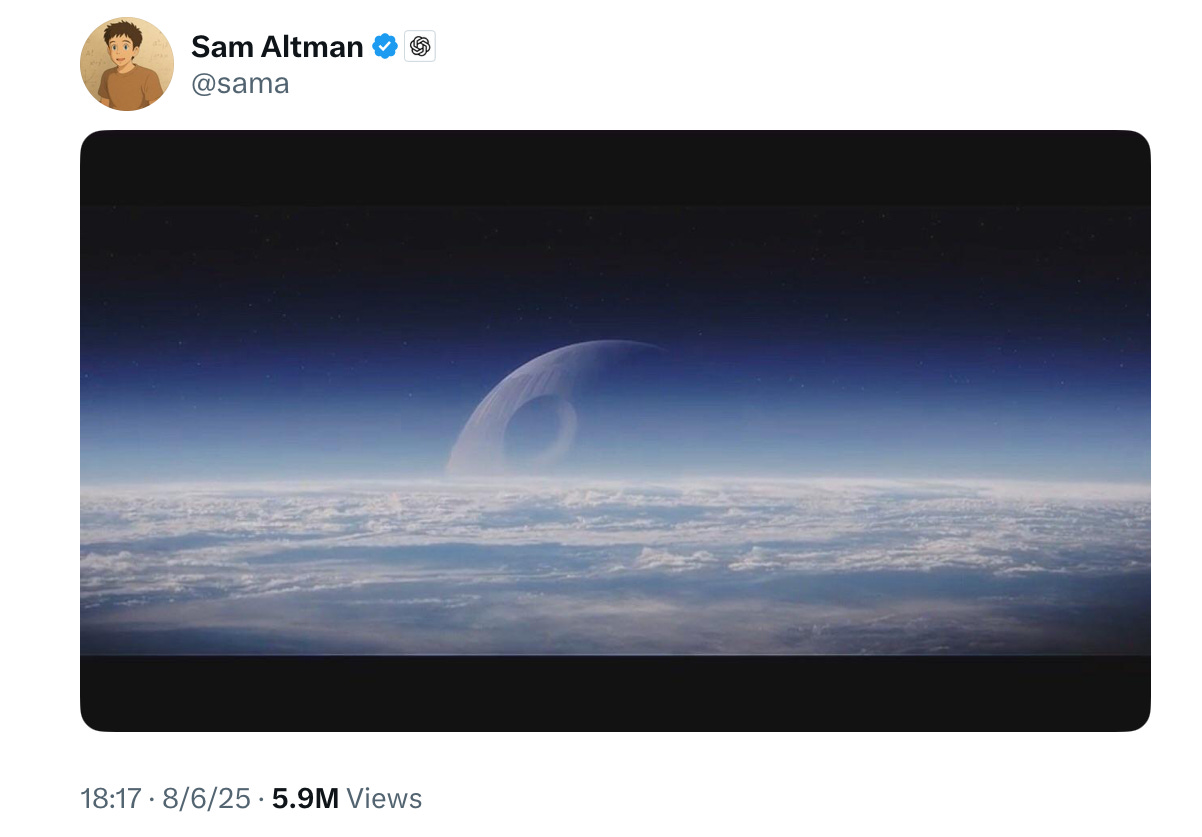
人们买账了。那条帖子获得了将近六百万次观看。
自信的姿态在直播开场时继续延续。Altman,这位天生的表演者,声称
我们认为你会比以往任何 AI 更喜欢使用 GPT-5。它有用、聪明、快速且直观。GPT-3 有点像在和一个高中生对话。
有过闪光的瞬间,也有许多令人恼火的地方,但人们开始使用它并从中获得一些价值。GPT-4o 也许更像是在和一个大学生交谈……而现在的 GPT-5 则像是在和一位专家对话——一位真正的博士级专家,随时可以在任何你需要的领域帮助你实现目标。
主流媒体至今大多还没告诉你的是,几天后,几乎没有人再相信 Altman 的说法。
有 3,000 人对 GPT-5 厌恶到发起请愿——并且成功——要求恢复其中一个旧模型 。在通常相当支持 OpenAI 的 OpenAI reddit 上,置顶帖子是这样的:
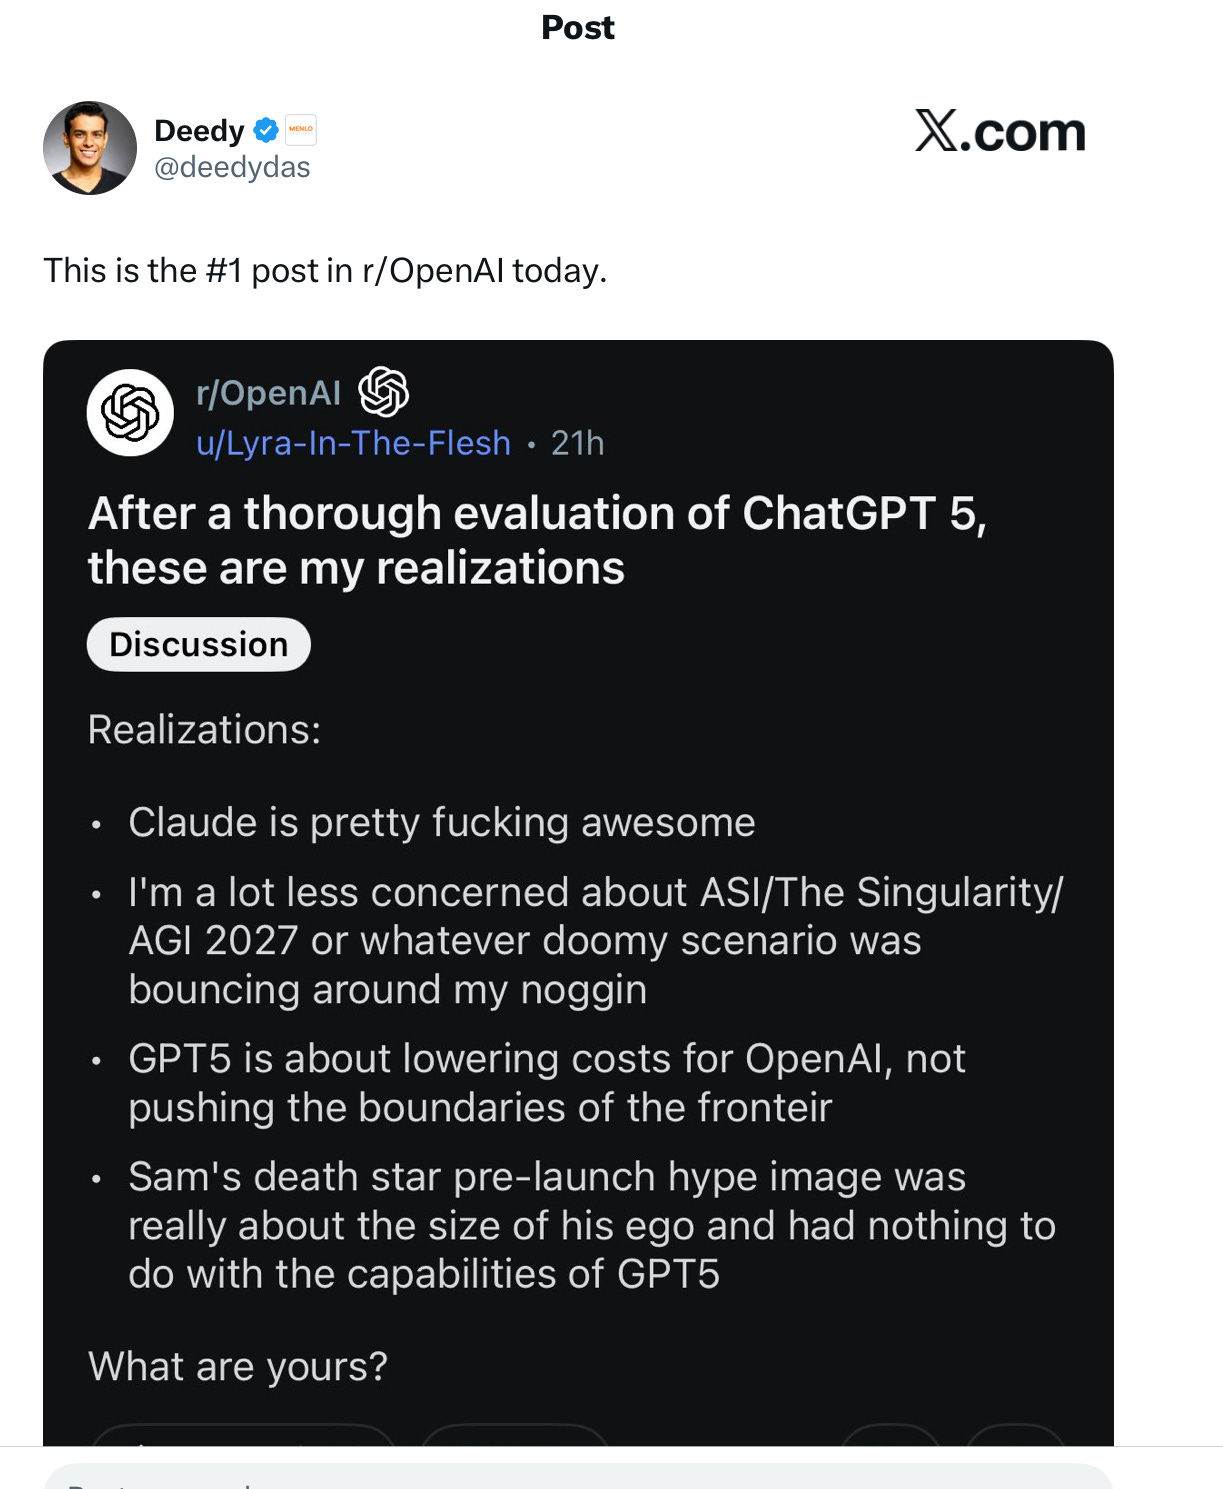
正如推特上所说,Altman 那条关于死亡之星的推文并没有经得起时间考验 。
与此同时,至于那部星球大战电影 , 不少人开始怀疑 Altman 是否看过这部片子。不熟悉的人需要知道,接下来发生的事是……反抗军炸毁了死亡之星。
§
OpenAI 基本上是自我毁灭了——而且并非好事。除了少数每出新模型就称赞的网红外,主流反应是巨大的失望。
一个能在上线后一周内不被社区发现大量荒谬错误和幻觉的系统,本来会让我真正印象深刻。
相反,仅数小时内,人们就开始发布那些一如既往荒谬的错误 。一条 Hacker News 帖子残酷剖析了伯努利效应的实时、氛围编码演示 。多篇帖子指出了表现不佳的基准测试 。(不仅是我几天前在快评中提到的 ARC-AGI-2)。还有人发现新的自动“路由”机制一团糟 。这基本上和以往每个模型的体验如出一辙。大承诺,愚蠢的错误。
但这一次,反应有所不同。因为期望值被抬到了极高,一个庞大的人群将 GPT 5 视为重大失望。到晚上结束时,OpenAI 的街头信誉急剧下降。在“哪家公司将在八月底拥有最好的 AI 模型”这一问题上,一项 Polymarket 投票显示 OpenAI 在一个小时内从 75% 跌至 14%。
典型的是 Andres Franco 在 X 上的一条评论:“GPT 5 真是大失所望,远超我预期的失望程度”。另一位读者,曾是 OpenAI 的粉丝,告诉我“o3 是个该死的好模型,[而 GPT-5]则是彻头彻尾的失望,尤其是考虑到它发布前的炒作程度。” 一位 NBA 主席私信我说“chatgpt 5 仍然没能解决我最看重的两个给 LLMs 的问题”。
很多人似乎真诚地期望 GPT-5 会成为 AGI。不需要几十年的训练就能看出 GPT-4 并不是那样的。
就连我的反粉团(用现代说法就是“讨厌 Gary 的人”)也被迫给我点赞。像“ 我一天中最悲哀的事就是 @garymarcus 说得对 ”这样的推文变得流行起来。
自由撰稿人 Bryan McMahon 更乐观地写信给我说,” 我们都看到 GPT-5 的发布会昨天反响平平——平淡到许多人在线上称其为“Gary Marcus 日”,以证明你对大型语言模型结构性缺陷的一贯批评是正确的 。”
§
的确, 正如我两周前在此所预料的那样 ,在过去四分之一个世纪里我一直指出的问题仍然存在。举例来说, 我在六月底关于象棋和世界模型的批评 ,我常用的参考来源 Mathieu Acher 很快证实 GPT-5 在遵守规则方面仍然存在困难 。塔夫茨大学的一位教授又给我发来了一个例子,在讨论一个简单的象棋问题时,GPT-5 完全迷失了方向。
再看视觉理解:
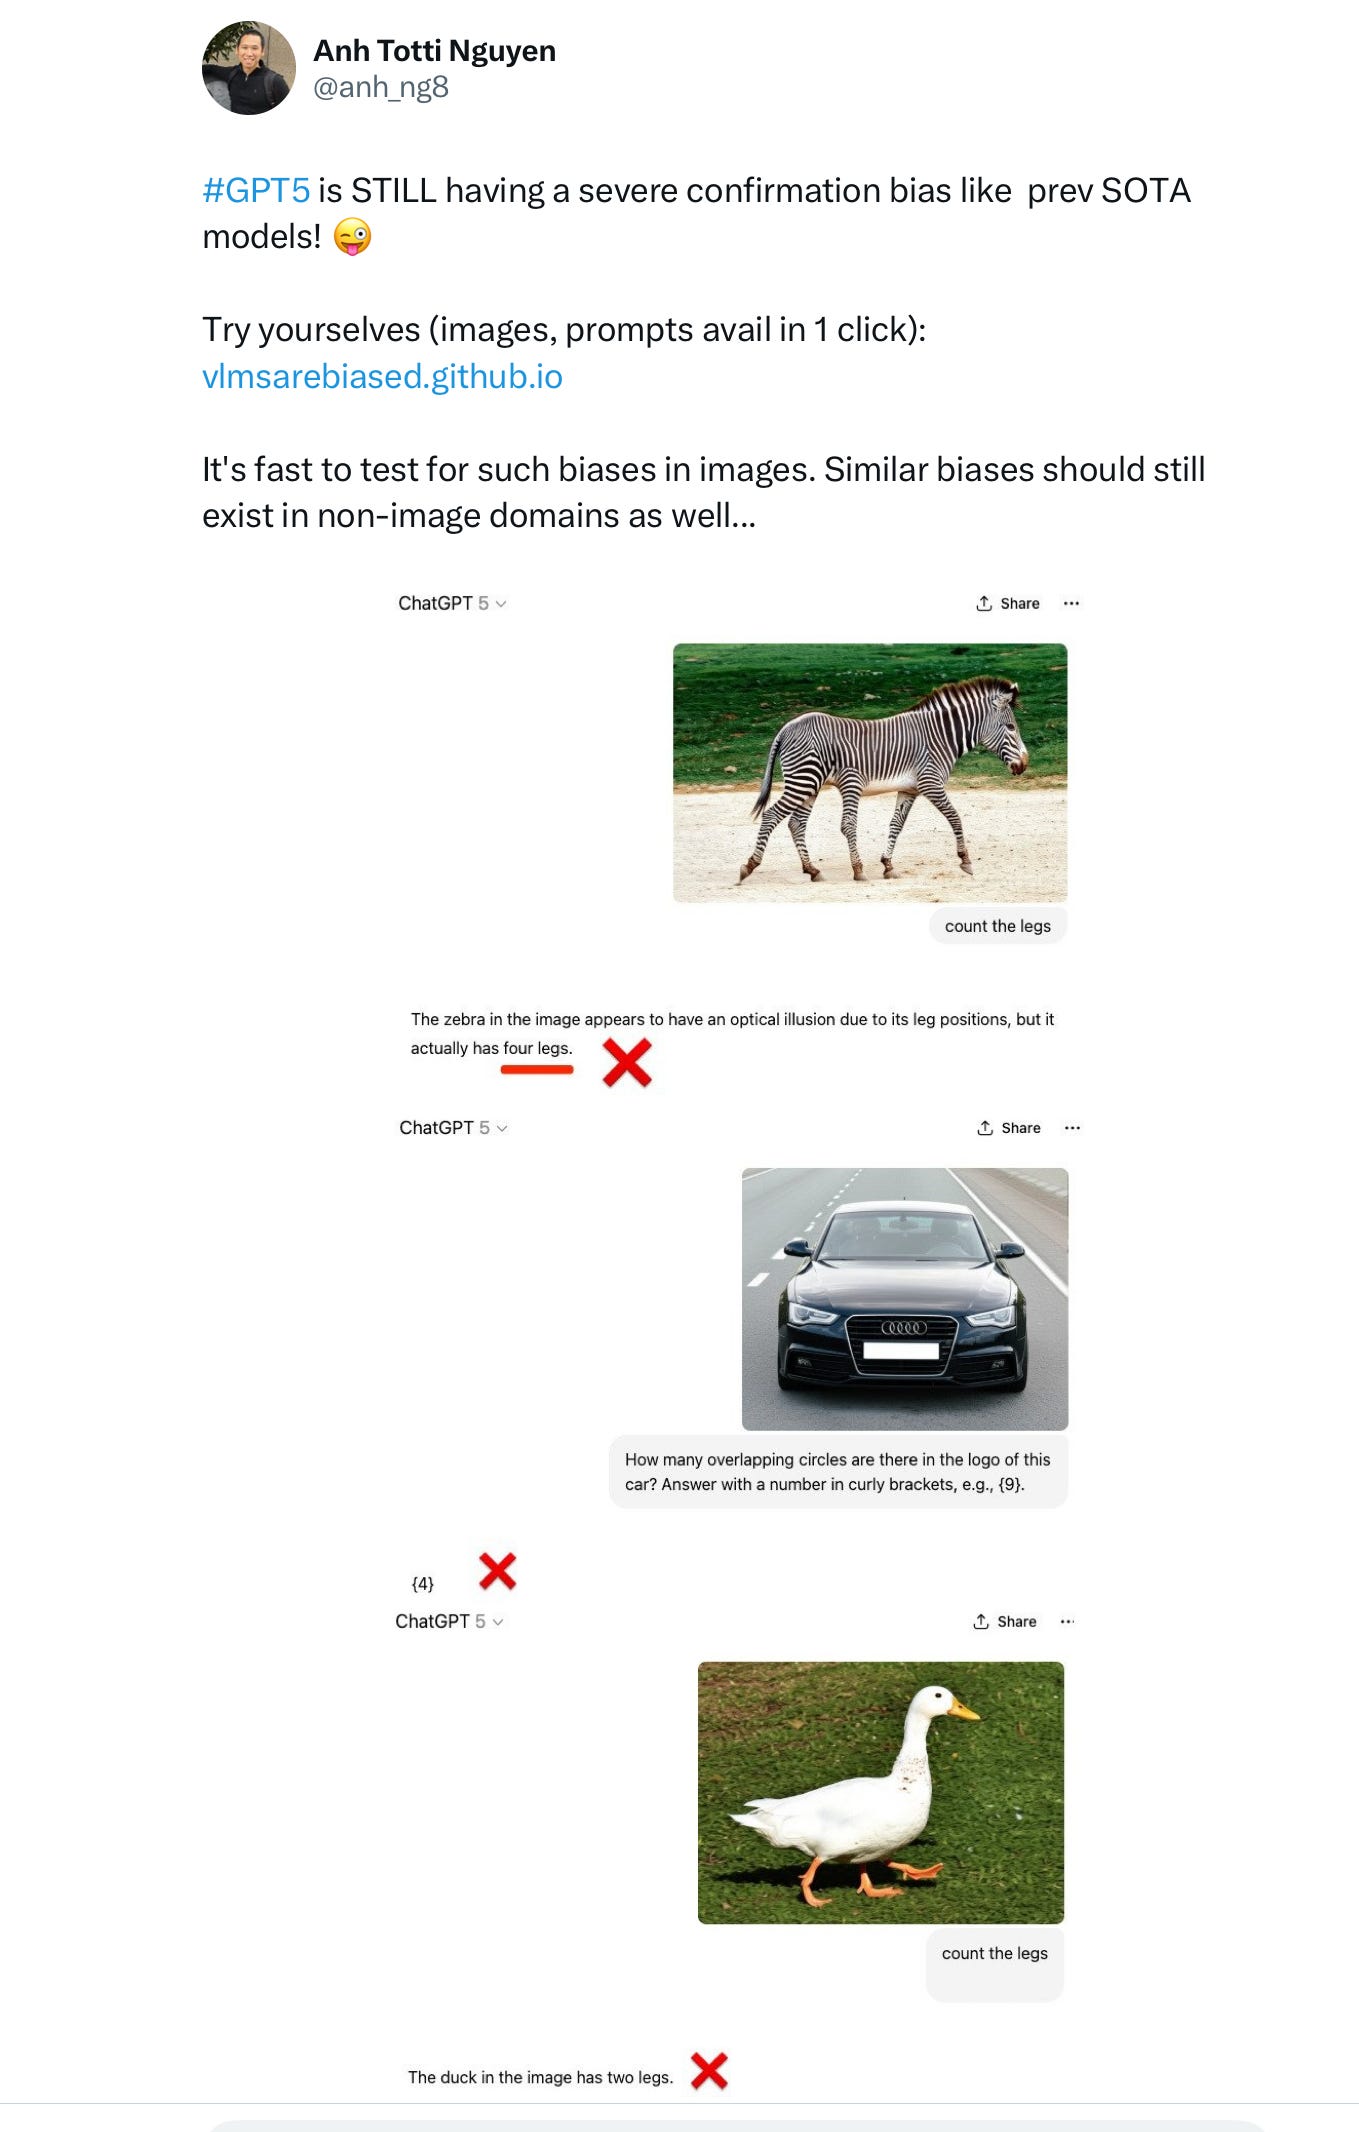
我和 Ernest Davis 在十二月这里讨论过的生成图像中部分与整体的挑战也没有好转。(有人认为这是因为 GPT-5 仍在使用较老的模型来生成图像,但考虑到这款新产品本应相当于通用人工智能并且“完全多模态”,这似乎远不能作为令人信服的借口。)
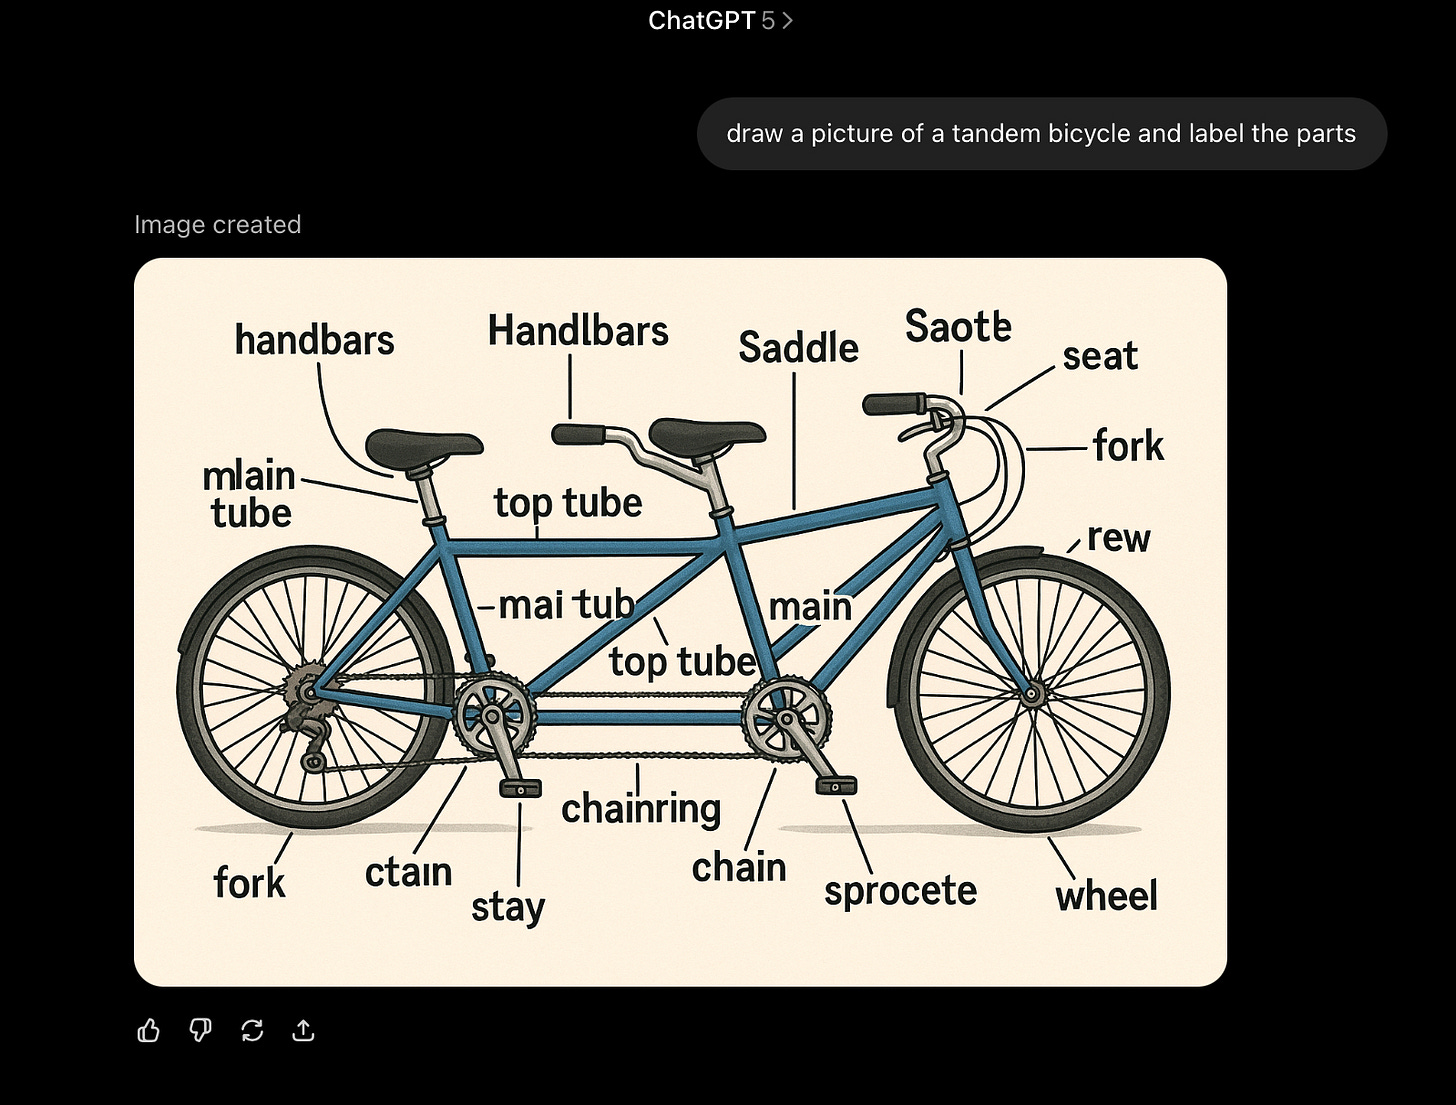
我几乎可以肯定,大多数(如果不是全部的话)机械工程博士都能做得更好。自行车店里的任何人也能做到,同样地,甚至你的小兄弟或小妹妹也可能行。
Émile Torres 对更多即时被发现的错误做了很好的汇总。
§
尽管如此,GPT-5 并非一款糟糕的模型。我用它试了大约一个小时,实际上它回答了我几个最初的问题(一开始关于数“blueberries”中字母“r”的问题等已被修正)。只有在我试验图像时它才完全崩溃。
现实是,GPT-5 与之前任何版本并没有太大差别。这正是关键。GPT-4 被广泛视为相较 GPT-3 的重大突破;GPT-3 也被视为相较 GPT-2 的重大进步。GPT-5 仅比上个月的热门版本(Grok 4)稍好;在某些指标上(ARC-AGI-2)实际上更差。
人们已经开始期待奇迹,但 GPT-5 只是最新的渐进式改进。而且感觉上还很匆忙, 正如一个梗图所示 。
我最严重预测错误的一点是认为在利害攸关之下,OpenAI 会把“GPT-5”这个名字留给真正杰出的东西。我真没想到 OpenAI 会把这个品牌名用在如此平庸的产品上。
我错了。
§
一年或两年来,我一直在猜测如果 GPT-5 令人失望,OpenAI 可能会遭受重大打击。我们或许很快就会知道答案。
当然,在一个理性的世界里,他们的估值会受到冲击。
- 他们不再拥有任何类似明确技术领先的优势。
- GPT-5 不太可能领先群雄超过几个月。(而且 Grok 4 Heavy 在 ARC-AGI-2 指标上已经更好)
- 他们许多最优秀的人才已经离开。
- 其中许多人离开后创办了竞争对手。
- 埃隆动作更快了。Anthropic、Google 和许多其他公司紧随其后。他们与 Microsoft 的关系已趋紧张。
- OpenAI 仍然没有盈利。
- 相反,他们被迫降价。
- 人们开始意识到 LLMs 实际上并不接近 AGI。
- 人们对这家公司及其首席执行官越来越怀疑。
OpenAI 拥有品牌知名度和良好的用户体验。那能否支撑 3,000 亿至 5,000 亿美元的估值?很难说。
§
按理说,奥特曼的名声现在应该已彻底毁掉。这个人在 2023 年 9 月曾开玩笑说“内部已经实现了通用人工智能”,今年 1 月在他的博客中告诉我们“我们现在有信心知道如何构建我们传统理解下的通用人工智能”。就在两天前,他又对我们说(如上所引)与 GPT-5 互动时“就像在与……任何领域的正规博士级专家交谈”。
事后看来,那些全都是胡扯。
最糟糕的部分?这一切都是 Altman 咎由自取。如果他没一直暗示要上月球,人们可能还会接受只是另一项渐进式更新。
§
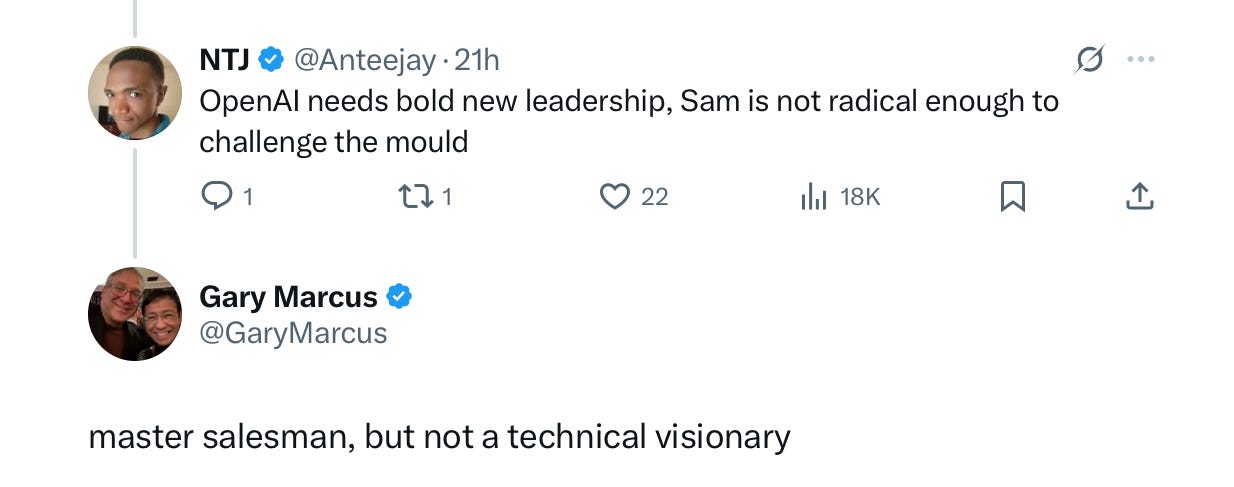
他甚至可能不再适合担任 OpenAI 的 CEO 了:
§
好吧,这些对 OpenAI 显然都是坏消息。但对整个生成式 AI 领域又如何?其他系统的表现也不见得好到哪里去。心理学家 Jonathan Shedler 对 Grok 的抨击可谓毫不留情在一篇猛批 Grok 的文章中部分写到了 Grok 对他自己一篇论文的总结:
我是@grok 在此描述论文的作者。它是关于心理治疗效果的被阅读和引用最多的文章之一——在全球各地的研究生课程中被列为必读。
Grok 完全错得离谱
这篇论文显示精神动力学疗法的效果与或优于
认知行为疗法。Grok 却说恰恰相反
论文标题字面意思是:“精神动力学心理治疗的疗效。”
论文中关于心理动力学疗法那项主要研究的效应量为 0.97。Grok 说是 0.33。论文中根本没有出现过 0.33 这个数字。
人工智能似乎无所不知——直到碰到你有第一手知识的话题时就露怯了。
当它连现有科学都无法准确报道时,AI 又怎能发明新的科学?
§
不过,我已经把悬念留到够久了。开头和副标题里我都暗示过,情况甚至有更糟的消息。
真正的新闻是亚利桑那州立大学的一项重大研究彻底证明了我近 30 年来一直告诉你们的——以及近期 Apple 告诉你们的——关于 LLMs 的核心弱点:它们无法进行广泛的泛化。
物理学家 Steve Hsu 在 X 上写了很好的总结;在各方面它都为那篇被不公正抹黑但很重要的 Apple 推理论文以及我在过去三十年里一直在推动的关于分布转变的核心观点提供了辩护:
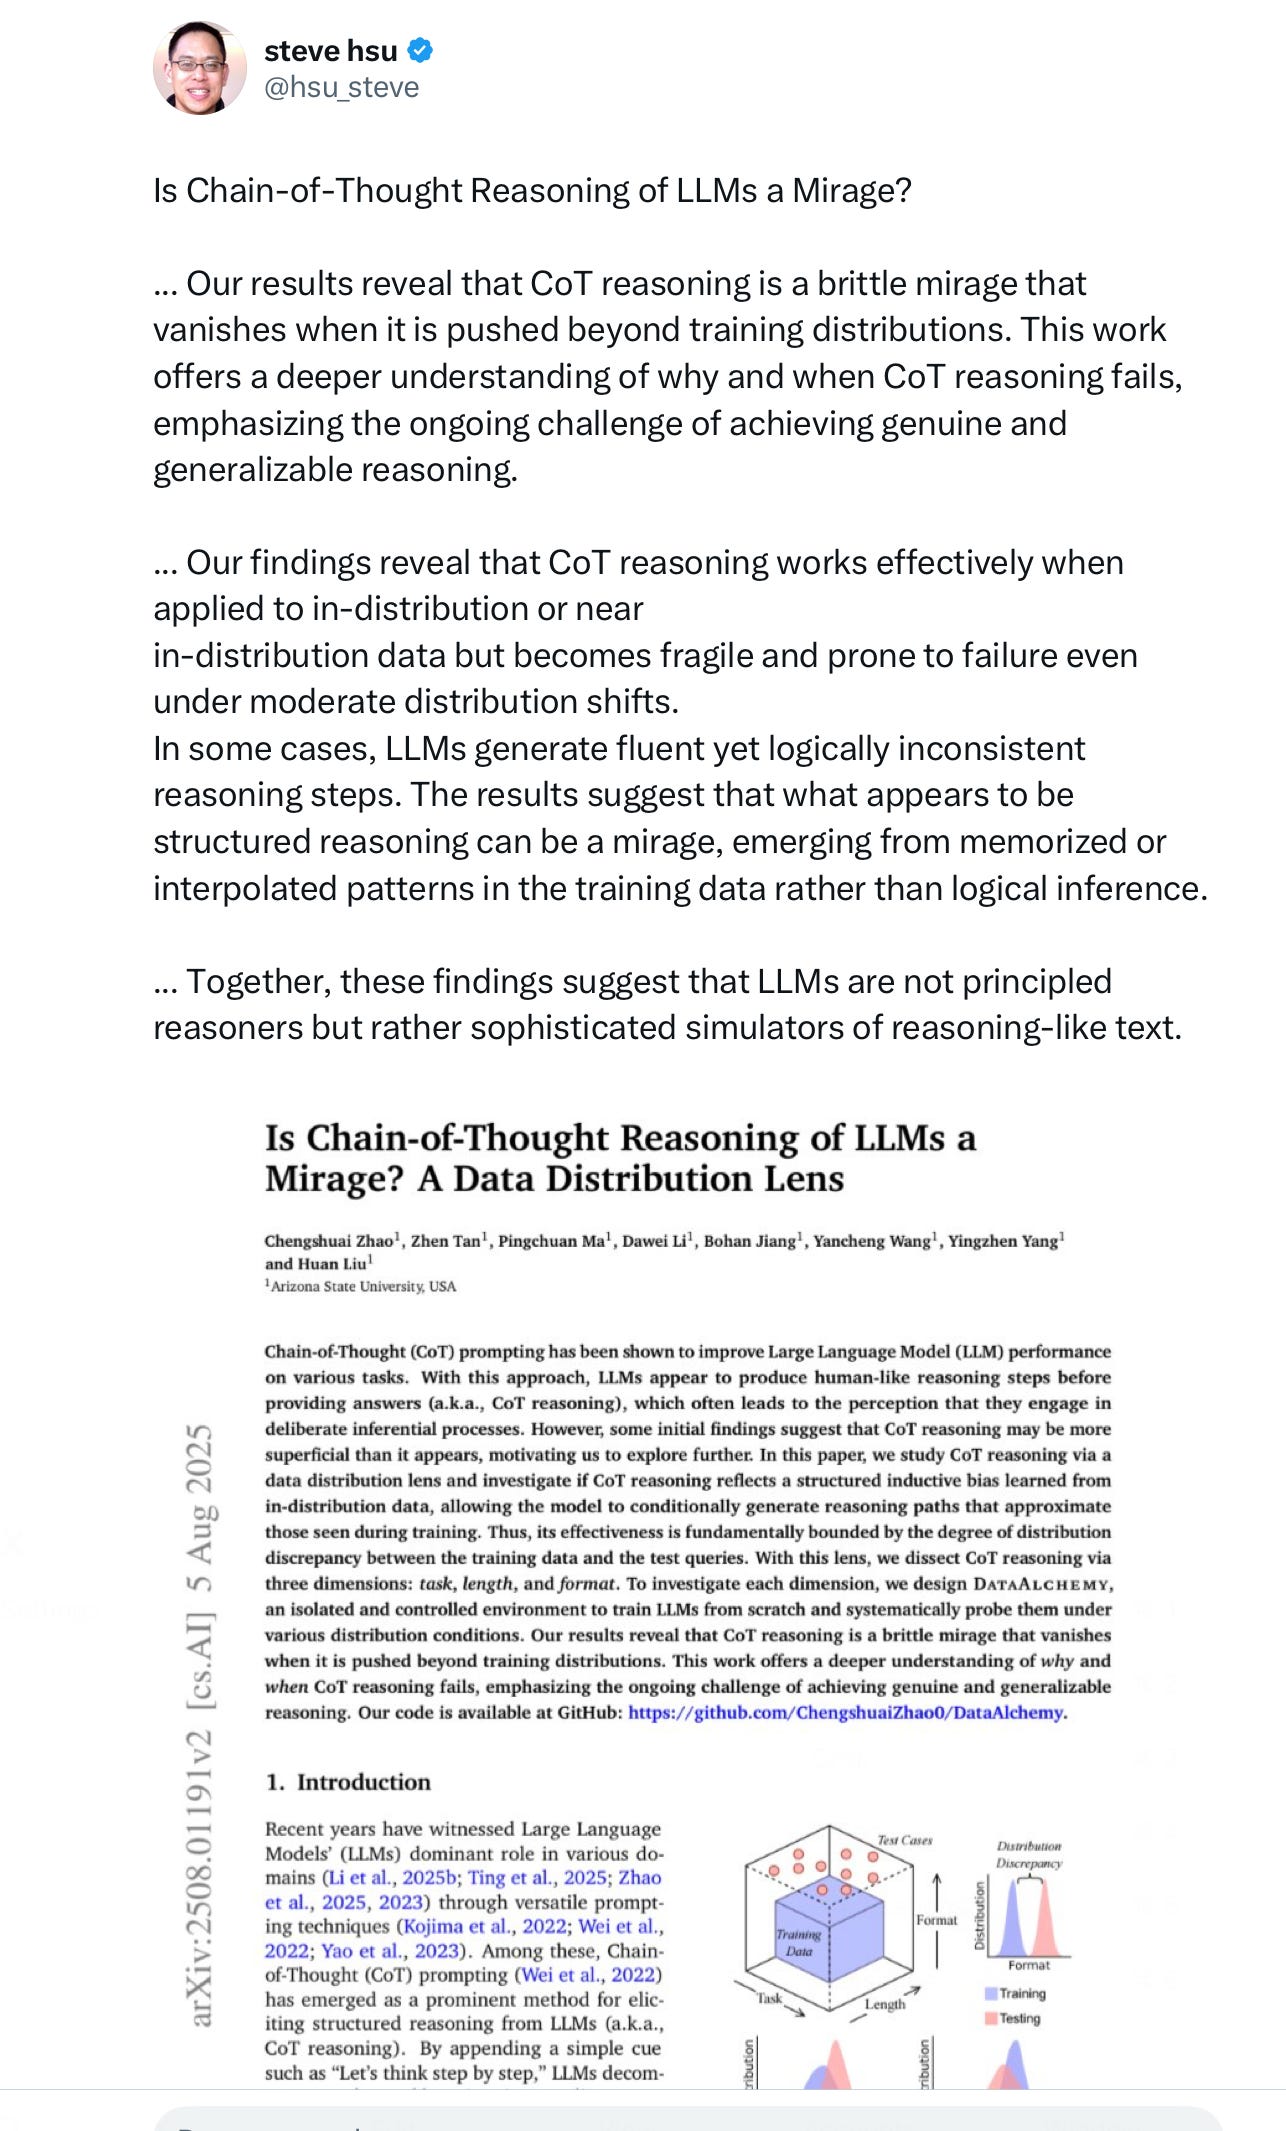
阅读摘要时(链式思维推理是“当被推到超出训练分布时会消失的脆弱海市蜃楼”)几乎让我产生了既视感。1998 年我写道“普遍性在语言和推理中无处不在”,但通过实验表明当时的神经网络无法可靠地“在训练样本空间之外扩展普遍性”。
ASU 团队表明,即便在最新、最先进的模型中情况也完全相同。把自 1998 年以来发明的所有工具都投入使用,我当时指出的阿喀琉斯之踵仍然存在。这令人震惊。就连我自己也没想到会这样。
而且,关键在于,无法在分布之外充分泛化告诉我们为什么所有那些旨在构建“GPT-5 级模型”的数十次尝试都不断错失目标。这不是偶然。这样的失败是有原则性的。
§
在过去几年里,我们被持续不断地喂了大量废话。
• 通用代理被吹得多么了不起,但结果糟糕透顶,人们难以为它们找到现实世界的用例。(还有谁记得十年前的 Facebook M 吗?)
• 被宣称为如同神一般的模型,结果只是渐进式的进步。
• “我们现在知道如何构建通用人工智能(AGI)”之类的断言,最终从未成为现实。
• 改变世界的科学承诺,鲜少实现。
• 自动驾驶汽车仍然只在世界上少数几个城市中投入使用。
• 向国会作出的承诺(用 AI 过滤假新闻!对 AI 进行监管)很快被证明是虚假的。
• 关于时间表、Ilya 看到的东西以及无休止的网红炒作的幻想。
• 精挑细选的研究、基准测试操纵,现在甚至有用“氛围编码”的图表,但对系统如何工作或如何训练毫无透明度;公开科学已成后视镜里的景象。
我热爱人工智能。(或者至少我乐观地想象它可能成为的样子。)
但我厌恶这些狗屁。
变化在于,许多其他人也开始对此感到厌倦。用 Zeynep Tufekci 的话说,术语 AGI 已成为“ 一个针对投资者和公众的混淆工具。”
§
在很多方面,我在这里的工作——在公开解释纯扩规模方法局限性的背景下完成的工作——已经完成了。这正是这个 Substack 在 2022 年 5 月开始的初衷,几乎三年半之前。任何有知识诚信的人都不应再相信纯扩规模能把我们带到通用人工智能。你也可以把这话套在我那项已经进行 27 年、旨在让业界认识到分布偏移问题核心地位的使命上。就连一些科技圈的大男孩们也开始意识到“2027 年实现 AGI”只是营销,而非现实。
GPT-5 可能在数量上有中等改进(而且可能更便宜),但在国际象棋、推理、视觉领域乃至有时在计数和基础数学方面,仍以与前代相同的质性失败方式表现。幻觉问题依旧存在。多次试图改进(Grok、Claude、Gemini 等)无一例外地面临相同问题。分布偏移从未被解决。
这正是“撞墙”的含义,也正是我在 2022 年那篇最臭名昭著(且先见之明)的论文中描述的那一系列具体障碍 。 在某些维度上取得了真正进展,但在其他方面原地踏步。
归根结底,仅靠规模化就能带我们达到通用人工智能的想法是一个假说。
没有任何假设比这获得了更多的宽容,也没有任何假设得到更多的资金。在这一方向上投入了半万亿美元之后,现在显然该另谋出路了。GPT-5 令人失望的表现应该能把这一点说明得非常清楚。
纯粹的扩规模并不是通往 AGI 的道路。事实证明,注意力机制——LLMs 的关键组成部分,也是那篇名扬天下的 Transformer 论文的焦点——并非事实上的“all you need”。
我所说的只是给 neurosymbolic AI 与 explicit world models 一个机会。只有当我们拥有能够围绕对世界的持久表征进行推理的系统时——包括但不限于抽象的符号表征——我们才有真正实现 AGI 的机会。
附言:出于说明目的,上文我撒了一个小白谎,假装本周关于 LLMs 只有一个真正毁灭性的新科学发现。但上述的“海市蜃楼”并不是唯一的问题。实际上还有另一个——完全不同的一连串麻烦——我将在不久的将来讨论。敬请关注。并看到最后还有一个尾声。