
当推理速度成为公司运营速度的上限
2026年,AI Agent从演示走向生产环境的速度比多数人预期的更快。一个编码Agent完成一次完整任务的时间,从30分钟压缩到2分钟,意味着开发者每天可测试的想法数量增加一个数量级。但这一提速的瓶颈不在模型本身,而在硬件:当模型参数膨胀到万亿级别,推理芯片需要在极短时间内从内存中搬运海量权重数据,而现有架构在内存容量与带宽之间始终存在一个无法同时满足的取舍。
这正是Volantis试图切入的位置。这家总部位于旧金山的半导体公司于2026年10月1日宣布完成8800万美元A轮融资,由Lachy Groom与Abstract Ventures联合领投,John Doerr、VXI Capital、Triatomic、Susa Ventures参投,天使投资人包括Dwarkesh Patel、Naveen Rao与Sholto Douglas。公司称,这笔资金将用于推进其首个系统A-1的开发与商业化,目标是在2027年向客户交付首批集成推理引擎。
Volantis的命题很直接:如果AI Agent的工作速度将决定公司的运营速度,那么当前硬件的内存墙就是横亘在模型规模与推理延迟之间的结构性障碍。据公司融资公告,CEO兼联合创始人Tapa Ghosh表示:”Today’s hardware forces a tradeoff between running the largest, most sophisticated models and running them fast. We started Volantis to eliminate that tradeoff.”公司称,A-1的设计目标是将内存容量与带宽同时提升近两个数量级,并运行超过20万亿参数的模型,每用户每秒最高输出10000 tokens。上述性能数字为公司设计目标,尚无独立第三方验证。
| 字段 | 内容 |
|---|---|
| 公司 | Volantis |
| 轮次 | A轮 |
| 金额 | 8800万美元 |
| 投资方 | Lachy Groom(联合领投)、Abstract Ventures(联合领投)、John Doerr、VXI Capital、Triatomic、Susa Ventures;天使投资人Dwarkesh Patel、Naveen Rao、Sholto Douglas |
| 总部 | 美国旧金山 |
| 创始人 | Tapa Ghosh(CEO、联合创始人) |
| 官网 | https://volantissemi.ai/ |
内存墙的物理构成与Volantis的切入方式
理解Volantis的技术逻辑,需要先拆解AI推理硬件中内存墙的具体构成。当前AI芯片的存储层次大致分为两级:片上SRAM提供极高的访问带宽,但容量受限于芯片面积和成本,通常只有几十兆字节量级;片外HBM提供更大的容量,但带宽远低于片上存储,且受限于电气互连的物理距离,单颗GPU周围能封装的内存芯片数量存在上限。
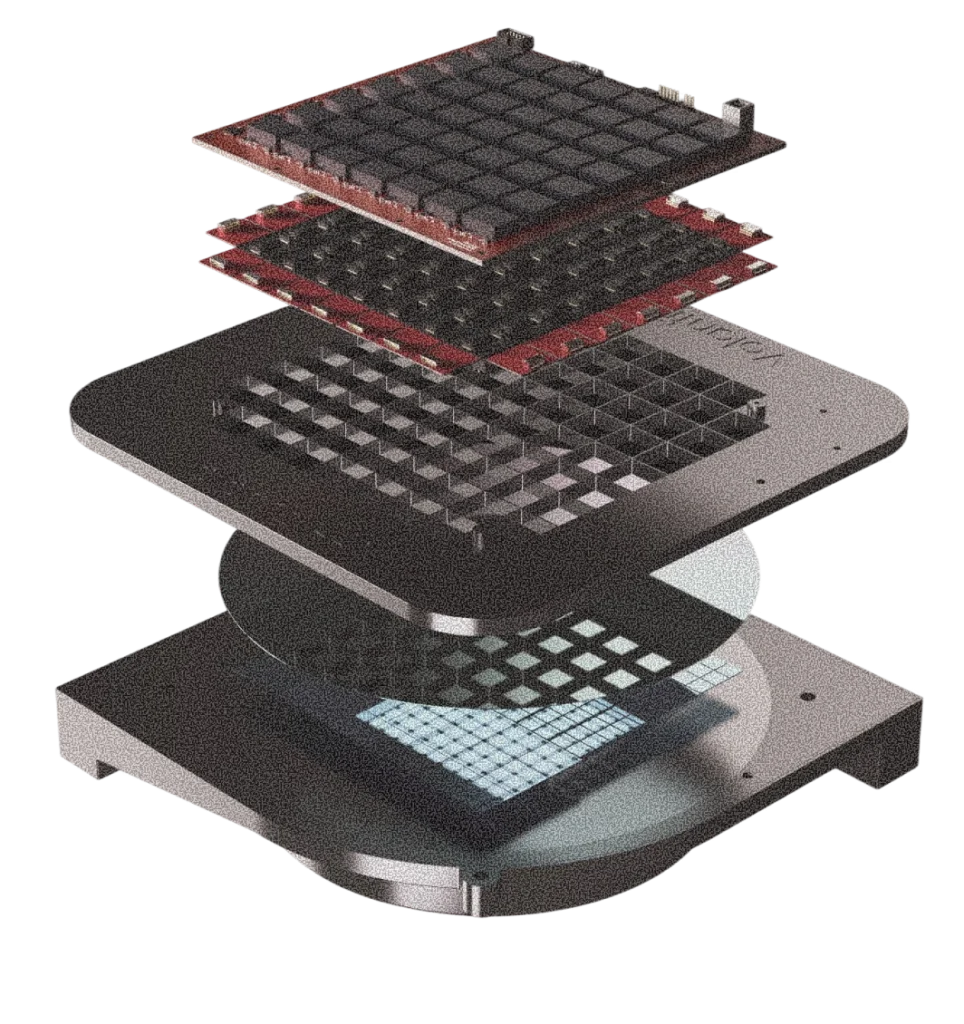
据Economic Times报道,Nvidia当前最好的产品每颗GPU只能容纳8颗HBM内存芯片,原因在于连接内存芯片的微型电线的传输距离有限。Volantis称,其正在开发的激光光传输方案可消除连接距离限制,使其能在GPU周围布置220颗内存芯片。这一数字来自公司向媒体披露的技术目标,尚无独立第三方验证。
Volantis的技术路线是将光子互连从传统的芯片到芯片场景,迁移到芯片到内存场景。公司称,芯片到内存连接所需传输的数据量是芯片到芯片连接的100倍以上,且距离更短,这意味着对能耗和成本的要求完全不同。这一判断构成了Volantis产品定义的基础:如果光子互连能在短距离、高密度、低功耗的条件下连接大量内存芯片,那么内存容量和带宽就可以同步扩展,而不是在现有取舍曲线上移动。
用砷化镓VCSEL绕开磷化铟,是一条供应链优先的路径
Volantis的光子方案有一个值得注意的细节:它使用自研的micro-VCSEL而非外部激光器,并依托现有砷化镓VCSEL供应链,避开磷化铟供应约束。公司称,端到端链路功耗低于1皮焦耳/比特,micro-VCSEL体积小、温度稳定性好、功耗低。该功耗数字为公司披露口径,尚无独立第三方验证。
这一选择的技术含义在于,VCSEL已经在消费电子领域大规模量产——据Economic Times报道,VCSEL为许多Apple设备的面部识别功能提供光源,Apple在过去十年中对该供应链进行了大量投资。这意味着Volantis试图利用一个已被验证的制造体系,而不是押注一个需要从零建立的磷化铟光子集成供应链。Ghosh在采访中表示:”Advanced packaging is always to be respected – it’s never trivial – but it’s not necessarily a new thing to do.”他进一步补充:”No one is going to win a Nobel Prize if our project works, but the good news is, they won’t need to.”
从产业链角度看,这一策略降低了供应链执行风险,但并未消除它。砷化镓VCSEL的现有产能主要服务于消费电子的短距离传感应用,其规格、可靠性要求和封装形式与AI芯片内存互连场景存在差异。Volantis能否在现有供应链基础上获得符合其功耗和密度要求的micro-VCSEL器件,仍是一个需要验证的假设。公司称光子技术已开发四年以上;在本次采集材料中未见公司披露具体的器件良率、可靠性数据或量产合作伙伴。
A-1的产品定义:用外部计算IP换取时间窗口
Volantis的首个系统A-1有一个容易被忽略的产品决策:公司称,A-1将外部授权、经硅验证的计算引擎IP与自研光子技术集成。这意味着Volantis并不自研计算芯片,而是将计算引擎的设计外包给已有硅验证的IP供应商,自己专注于光子互连和系统架构。
这一策略的逻辑是清晰的:自研计算芯片需要数年时间和数亿美元投入,而Volantis的核心差异化在于光子内存架构。通过授权成熟的计算IP,公司可以将工程资源集中在光子互连和系统集成上,缩短产品上市时间。但代价同样明显:外部授权的计算引擎IP意味着Volantis对计算引擎的迭代节奏、功耗优化和与光子互连的协同设计缺乏完全控制。如果计算引擎IP的更新速度跟不上模型架构的变化,或者与光子内存架构的接口效率无法达到设计目标,A-1的性能承诺将面临折扣。
据Unite.AI报道,公司列出的A-1规格包括10TB内存容量、240TB/s内存带宽、20kW功耗、10TB/s off-wafer IO带宽(片外IO带宽)和15U形态,设计目标是适配现有数据中心机架。这些数字仅出现在Unite.AI的报道中,其他来源未复述,公司也未在融资公告中披露。上述规格为公司披露口径,尚无独立第三方验证。
投资逻辑:押注推理成本曲线的下一次断裂
以下投资方背景来自公开报道,非本次融资公告内容。据Economic Times报道,Lachy Groom被描述为Stripe veteran,Naveen Rao被描述为AI chip veteran,Sholto Douglas被描述为Anthropic researcher;上述人物履历来自该报道,尚未经独立核实。该报道还称,John Doerr曾”backed Google and Amazon.com in their early days”;天使投资人包括AI podcaster Dwarkesh Patel。
8800万美元的A轮融资在半导体领域并不算大。与自研AI芯片的典型资金需求相比,这一金额更接近一个系统集成商的早期融资规模。这与Volantis不自研计算芯片的策略一致:公司不需要为计算芯片的流片和量产筹集数亿美元,而是将资金集中在光子互连的开发和系统集成上。
公司称,本轮融资使其累计融资额达到9700万美元。若累计融资仅包含本轮与已披露的900万美元种子轮,则A轮前累计融资约900万美元;该推算未考虑其他未披露融资。据公开报道,Volantis曾获得900万美元种子轮融资,投资方包括Alex Wang、Trevor Blackwell等。这一背景信息仅用于说明公司的融资历史,不构成本次A轮的事实。
竞争格局:光子内存架构与HBM/3D DRAM的路径差异
Volantis的竞争对手并非某一家具体的创业公司,而是整个AI硬件产业对内存带宽问题的既有解决路径。Nvidia和AMD当前的做法是将HBM内存芯片尽可能靠近计算芯片封装,通过先进封装技术缩短互连距离、提高带宽。如前所述,Nvidia当前产品每颗GPU仅能容纳8颗HBM内存芯片。Volantis的方案是绕过这一电气互连距离限制,用激光光传输连接220颗内存芯片。
另一条路径是3D DRAM,即将DRAM堆叠在逻辑芯片上方,通过垂直互连缩短距离。但Volantis认为,3D DRAM仍处于同一取舍曲线上——它改善了容量和带宽的平衡,但没有从根本上改变电气互连的物理限制。这一判断来自公司口径,其准确性取决于光子互连能否在成本、功耗和可靠性上真正超越电气互连的演进速度。
光子互连在数据中心的应用并非新事物,但主要集中在芯片到芯片的长距离连接,如共封装光学和可插拔光模块。Volantis的差异化在于将光子互连用于芯片到内存的短距离连接,这一场景对密度、功耗和成本的要求远高于芯片到芯片连接。如果公司关于”芯片到内存连接所需传输的数据量是芯片到芯片连接的100倍以上,且距离更短”的判断成立,那么现有光子互连技术无法直接迁移到芯片到内存场景,需要重新设计光源、调制器和封装方案。
2027年交付:时间表背后的验证路径与未解问题
Volantis计划2027年向客户交付首批集成推理引擎。A-1仍处于开发阶段,公司尚未披露任何原型系统实测数据,因此从融资到交付的一年窗口内需完成光子链路验证与系统集成两个阶段。
从已披露的信息看,Volantis的验证路径可能分为几个阶段:首先是光子互连链路的性能验证,包括端到端功耗、误码率、温度稳定性和量产一致性;其次是系统级集成验证,即将外部授权的计算引擎IP与光子内存架构整合,验证内存容量和带宽的实际扩展能力;最后是客户部署验证,即在真实工作负载下测试推理速度、每token成本和系统可靠性。公司尚未披露目前处于哪个阶段,也未公布任何基准测试结果或客户试点计划。
资金用途方面,公司称本轮融资将支持A-1及其光子内存架构的开发与商业化,包括扩充工程团队、推动系统走向客户部署。公司未披露投后估值,也未披露资金的具体分配比例,因此无法判断这笔资金能支撑公司走到哪个验证节点。
一个值得关注的未解问题是:Volantis的商业模式究竟是销售完整系统,还是授权光子互连技术给现有芯片厂商?公司称其正在构建AI推理系统新品类,计划向客户交付集成推理引擎,这暗示其商业模式更接近系统销售而非IP授权。但系统销售意味着Volantis需要承担完整的制造、供应链和客户支持责任,这对一家A轮公司而言是巨大的运营挑战。如果Volantis选择与现有服务器厂商或云服务商合作,以参考设计或模块形式交付,其商业模式的复杂度会降低,但市场影响力也会相应受限。
另一个未解问题是A-1的定价。公司称其设计目标包括降低每token推理成本,但未披露任何定价信息或成本结构。在AI推理市场,每token成本是客户决策的核心变量之一。如果A-1的初始成本高于现有HBM系统,即使其性能更高,客户也可能因为迁移成本而犹豫。Volantis需要在2027年交付前证明其系统在总拥有成本上具有竞争力,而不仅仅是性能指标上的领先。
从已披露的20万亿参数模型和每用户每秒10000 tokens的设计目标看,A-1瞄准的是超大规模模型的推理场景,而非通用推理市场。这一市场定位意味着目标客户数量有限,但单客户价值极高。如果A-1能在这一场景中验证其性能优势,Volantis有可能在特定细分市场中建立壁垒;但如果验证失败,其市场空间将受到严重限制。
验证边界与可复核指标
本文涉及的“首个、唯一、最大、领先”、订单、出货、性能等表述,如无另行说明,均是公司、创始人或投资方在现有公开材料中的披露口径;RecodeX未在本次采集材料中找到独立审计或第三方测试结论,因而不将其视为已经独立确认的事实。文中的产业协同、竞争位置和商业路径属于基于已披露产品与融资用途的编辑分析,不代表相关结果已经实现。
- 技术侧应核验第三方测试条件、样本规模、良率、稳定性及与可比方案一致口径的结果;
- 商业侧应核验去重后的付费客户、可执行合同、收入确认、复购率以及订单转化;
- 资本与产业协同应以工商股权、关联交易、联合开发、采购或量产文件为准。
RecodeX 极客视:Volantis在2027年交付前必须回答的具体问题包括:其一,micro-VCSEL在芯片到内存短距离场景下的量产良率和端到端链路功耗能否达到公司披露的低于1皮焦耳/比特;其二,外部授权的计算引擎IP与光子内存架构之间的接口效率能否支撑240TB/s聚合带宽的实际利用率;其三,A-1在20万亿参数模型推理场景下的系统级每token成本是否低于现有HBM方案;其四,公司能否在未披露原型实测数据的情况下获得首批可执行客户合同;其五,8800万美元A轮资金能否支撑公司走完从光子链路验证到系统集成交付的完整路径。这些问题的答案,将决定Volantis的光子内存架构是成为推理成本曲线的下一次断裂,还是停留在融资公告中的设计目标。
信息来源
本文在采集与核验阶段引用了以下公开来源,按站点去重列出;来源内容归原发布方所有,其口径不代表 RecodeX 的核实结论。