
原文:Local AI Models: The Catalyst for the Great Reset
作者:Sameer Singh
来源:SandHill.io #304 推荐阅读 · 投资主题与论点
说明:本文为中文编译稿,非全文翻译,完整内容请阅读原文。
算力危机已经从内存短缺变成插电 GPU 的全面稀缺,合同往往要锁 3 到 5 年,多数创业公司承担不起。作者认为云计算那套「一次交互的边际成本近乎为零」的前提已经结束,出路是去中心化的本地模型:它会结束对「应用层」的执念,并成为下一个技术周期的催化剂。
今天的本地模型
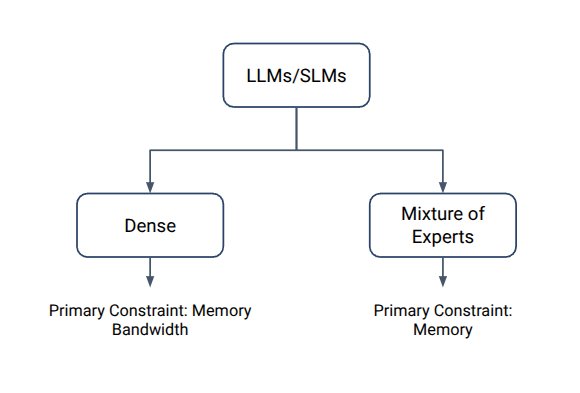
周期末端,人们会本能地否定本地硬件上的模型。先看架构。稠密模型(dense model)每个 token 激活全部参数,主要卡在内存带宽;混合专家(mixture of experts, MoE)只激活一个子集,例如 Qwen 3.6 35B-A3B 总参数 350 亿、每 token 只激活 30 亿,因此更适合消费级硬件。无论哪种,权重加上上下文和 KV 缓存都必须放进内存,总参数量决定内存容量。

能力已经够用,硬件并不贵

作者按「重量级」列出领先的开源权重模型(几乎都来自中国实验室),并给出可对照的闭源模型。表上的四档大致是:中端笔记本(约 750–2000 美元、32GB)跑 Qwen 3.6 35B-A3B,对标 Claude Sonnet 4.5;高端笔记本跑稠密的 Qwen 3.8 27B,对标 Opus 4.6;128GB 的 Strix Halo、DGX Spark 或 Mac Studio 跑 Qwen 3.8 Flash Next;约 1–1.5 万美元的 256GB 机器跑 GLM 5.3 Flash 或 DeepSeek v4 Flash,对标 Opus 4.8 一级。

正文里的账更直白:2026 年初,本地模型已能处理约 89% 的一般对话与推理;近前沿的 Flash 模型可以在 1–1.2 万美元的迷你 PC 上跑完工作,完整版 GLM 5.3 大约需要 2 万美元级硬件(例如高端 Mac Studio)。对照之下,Uber 给员工的年度 token 预算大约每个工具 1.8 万美元;每月 200 美元的 Claude 或 Codex 订阅,烧掉的 token 成本可以到 8000 美元。
小模型追赶更快。作者 2026 年 6 月用一台总价 560 英镑的笔记本(Ryzen 7 AI 350、Radeon 860M、32GB 统一内存)本地跑 Qwen 3.6 35B-A3B 做 vibe coding。现代笔记本上的模型大约落后前沿 12 个月;花 5000–1 万美元买迷你 PC,差距收到 6 个月以内,且没有用量费、会话上限,隐私也可以留在本地。2026 年 2 月,DGX Spark 或 128GB Strix Halo 上最好的模型还对不齐 2025 年 2 月的 Sonnet 3.7;到 8 月,同一台机器上的 Qwen 3.8 Flash Next 已接近 2026 年 4 月的 Opus 4.7。
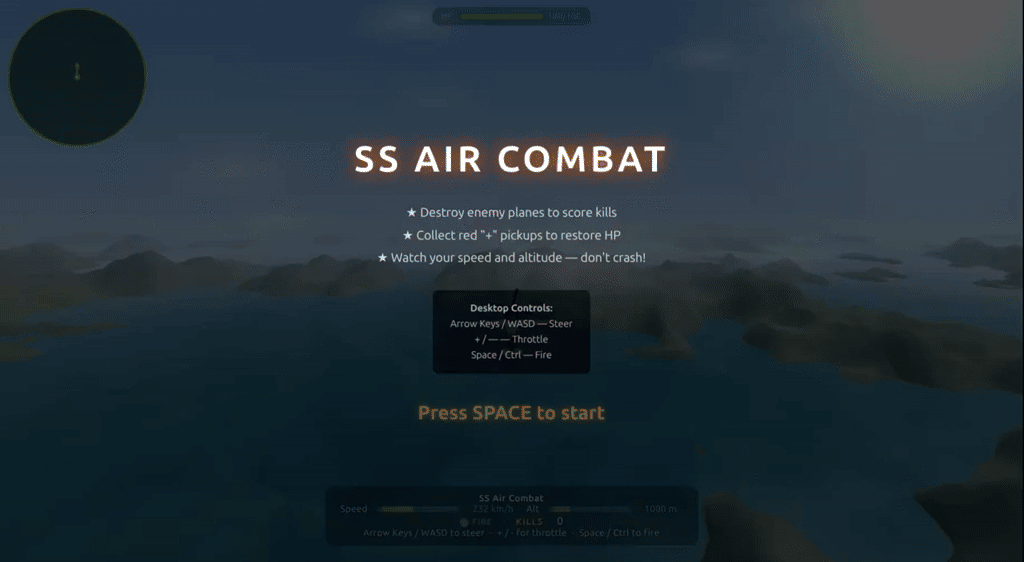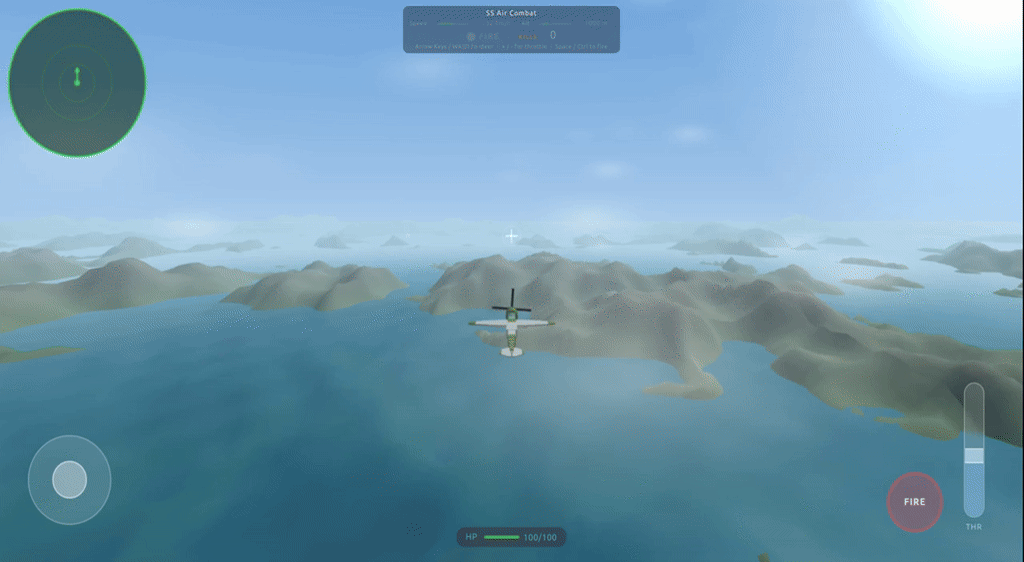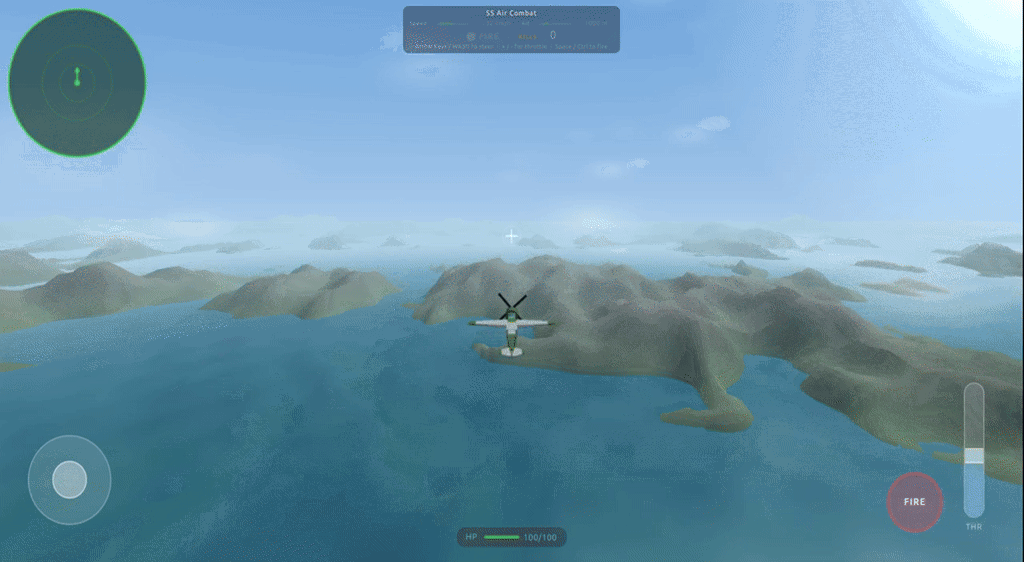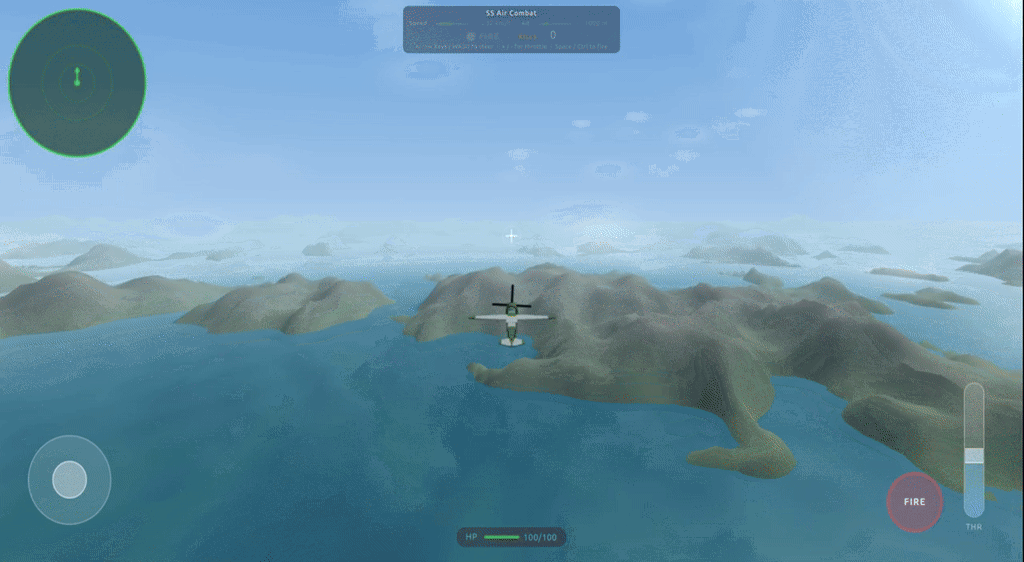
视频: 观看
作者用这台笔记本上的 Qwen 3.6 35B-A3B 完整做出一个空战小游戏。
免费模型靠什么活
今天开源权重的收入几乎只有 API 或与数据中心推理商分成。2026 年 9 月起出现另一条路:硬件厂开始预装模型。HP 在 ZBook Ultra G3a 16 上预装 Perplexity 的 Portable Computer,主打本地代理,跑的是对标 Opus 4.6 的 Qwen 3.8 27B 和 Nvidia 的 Nemotron 3.5 Lightning。设备厂支付授权费、芯片厂自己授权或垂直整合,都说得通。Nvidia 以 60 亿美元对 Poolside 做了许可加人的交易;AMD 收购 Taalas,后者把特定模型硬布线到芯片上,只能跑一个模型,但速度大约每秒 2 万 token,比云端快几个数量级。
总收入会远低于卖 token,这正是要点:设备厂靠换机周期卖硬件,用户得到没有用量上限的模型。训练频率和膨胀的资本开支必须降下来,作者认为这不可避免。
大重置的起点
作者把眼下称作 Great Reset:长达 55 年的计算周期在 AI 后期泡沫里结束,下一个周期转向物理世界,由本地 AI、机器人和 3D 打印支撑。从云到本地的成本切换是催化剂。

即便预算有限,本地模型已能覆盖多数用户的大部分任务;重度用户只需把极端情况交给按量计费的云。本地部署默认受算力约束,也少了超大前沿模型在数据中心里的意外安全问题。
转向已经开始。美国第二大所 Latham & Watkins 购买 Nvidia 硬件,完全改用自建托管模型。Bending Spoons 首席执行官称,99% 的 AI 请求已路由到自托管开源权重。阿里 Qwen 3.8 27B 在 2026 年 8 月中发布后的第一个周末下载量达 300 万;作为对照,Meta 的 Muse 用了 5 天才大约 73 万次下载。真正的阻力是心理:旧周期的假设要等危机继续恶化才会松动。

裂缝已经可见。4 月 Claude Code 更快触顶会话限额;6 月微软把 GitHub Copilot 订阅推进按量计费;9 月 OpenAI 暂停 200 美元 Pro 的新注册。新产能又因社区反对和融资困难延期或取消。图中高盛与 Aterio 的情景是:2027 年美国数据中心供需缺口 13–19 GW,2028 年需求 130 GW、预期投运仅 93–103 GW,缺口扩到 27–37 GW。作者预期收入和估值会被大幅下修,资本开支回落压低内存和算力价格,再反过来加速换机和本地化。
「应用层」会死,物理产品会出生
作者不认为 AI 是一次平台迁移。「用 AI 做应用」带来软件业不熟悉的高边际算力成本:消费产品毛利为负,企业则被账单吓到。本地部署把边际成本换成一笔不高的硬件开支。
一旦本地成为主导架构,用户的硬件和模型能力会分化,AI 应用的可触达市场会急剧缩小,只剩面向最低公分母的壳和工具;高边际成本的品类会被零边际成本的本地部署替换。传统应用层不受这轮硬件碎片化影响,但开发者同样受不了云模型的成本。Desert Ant Labs、Cactus Compute 这类可在用户设备上跑的微型专用模型,以及能在 4GB 内存上本地运行的开源分类器 Laya(对标 Jev),是给他们的效率出路。
若模型必须本地运行才划算,就很难只在屏幕上做全新应用。作者的结论是:AI 从来不是平台迁移,而是下一个周期的廉价投入;新的「应用层」是带本地 AI 的硬件,机器人是那个应用层。