原文:The First Version of Your AI Eval is You
作者:Ben Yoskovitz
来源:SandHill.io #304 推荐阅读 · 运营指南、案例与最佳实践
说明:本文为中文编译稿,非全文翻译,完整内容请阅读原文。
Highline Beta 创始合伙人 Ben Yoskovitz 以自己的合成用户研究产品 Candor 为例,说明 AI 产品可以「跑通」却仍然很差。评估(eval)最终可以自动化,但第一版不该是框架或「让模型当裁判」,而是人自己把输出读一遍,先回答「好」到底长什么样。规则用代码强制执行,判断才留给评估。
AI 产品可以出错,同时系统并没有坏
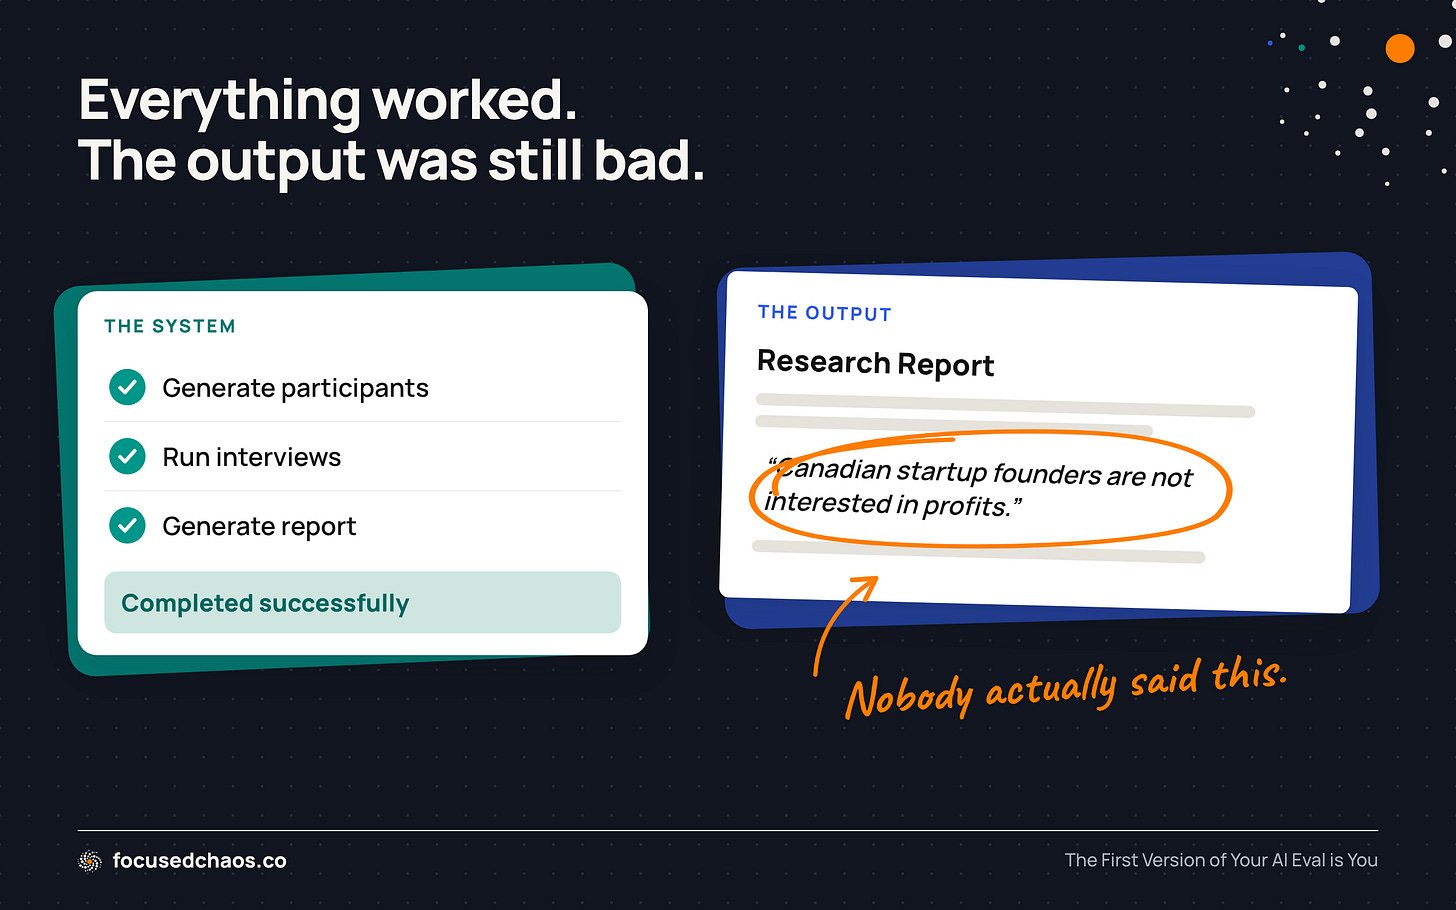
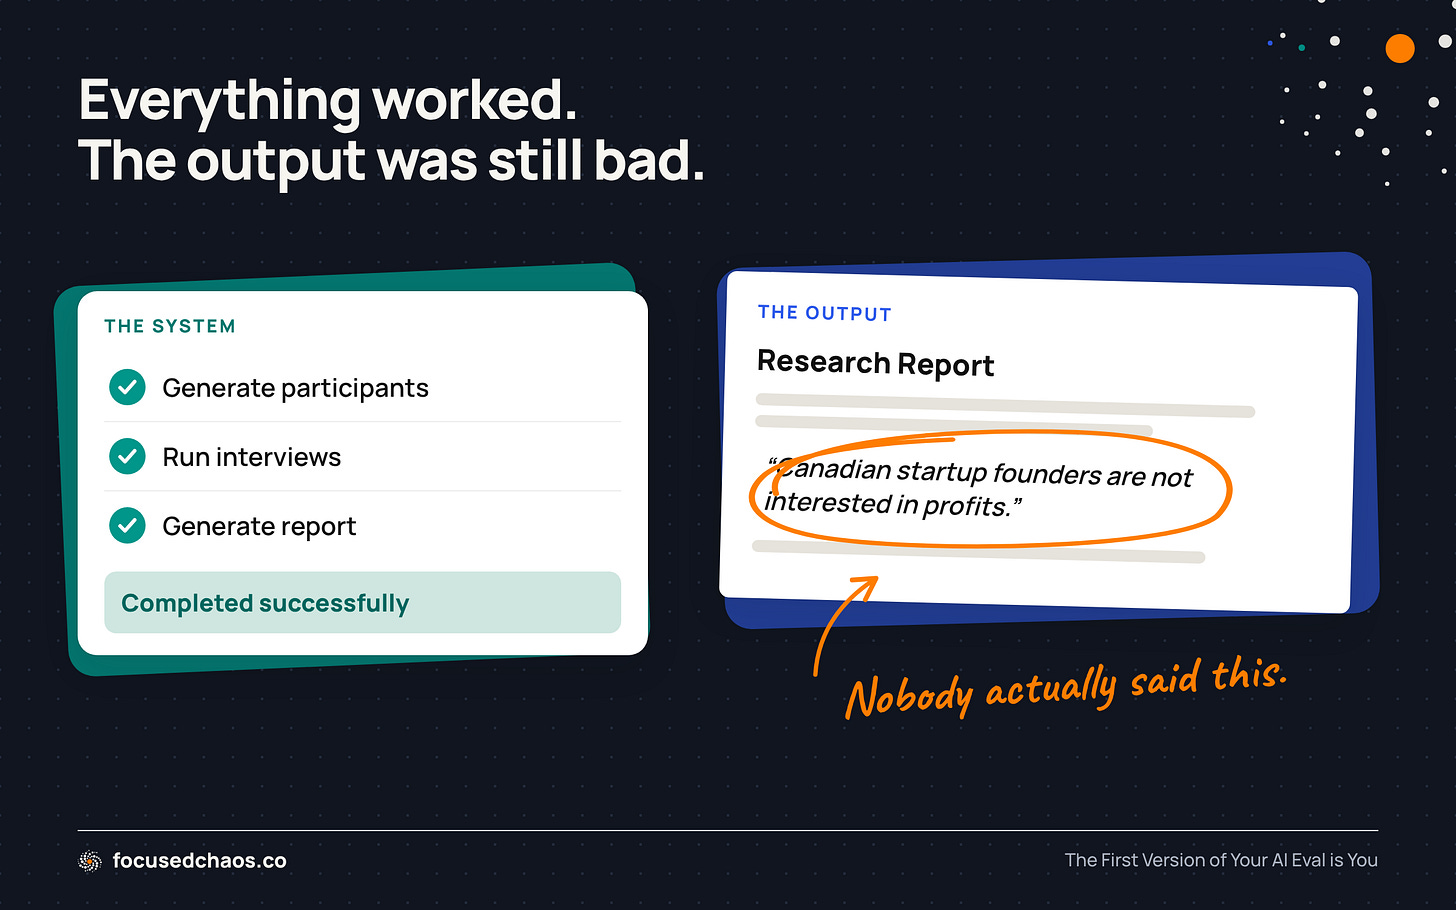
传统软件测试的核心是:按钮有没有触发、表单有没有存上、接口有没有返回预期结果。AI 多了一层:流程成功,输出仍可能是错的。
Candor 让研究者定义想了解的人群,再生成合成用户、访谈他们,并写出研究报告,重度依赖大语言模型。一次「成功」的运行会做出 15–24 个合成用户、完成访谈、交出一份像样的报告,没有报错、没有崩溃。真正要问的是:用户像不像、是否符合研究者要的人群;访谈员有没有听进去并追问,还是照着脚本往下犁;报告有没有夸大,或者放进一句根本没人说过的引语。
这些不像传统 bug。合成用户可以说得头头是道却仍然不真实,报告可以读起来很美却没有依据,访谈员可以问出得体的问题,访谈质量却很一般。不盯着看,一切正常,直到客户发现——更常见的是客户什么都不说,只是不再用。
评估的第一版是你本人
业界谈评估,很快就会滑向自动化:用哪个模型当裁判、评分量表、数据集、通过率、每次改动如何自动跑。这些都有用,但作者当时答不上来。他还没有产品输出的量表,不知道哪件事最要紧,也不知道会撞上哪一类失败。所以他从手工开始。
他引了同行的判断:Hamel Husain 与 Shreya Shankar 把亲自阅读输出、做错误分析(error analysis)视为评估里最重要的活动;Teresa Torres 对产品团队持同样看法。Candor 的做法很笨:跑一次研究或抽查真实客户研究,看输出,找问题(Claude Code 能帮忙定位,关键部分仍要自己读),归纳模式,定义「更好」是什么,改一版,再测。
已经找到的问题包括:合成用户档案里出现说不通的事实;访谈员偶尔重复已经谈过的内容,对不冷不热或含糊的回答处理得不够好;报告引语需要对照原始访谈做更硬的核验。引语后来被收成一条规则:报告保存前,每一句引语都要能在转录稿里对上,没人说过就不能当成引语。规则一旦发现问题就很显然,难的是先发现问题。
作者把顺序写成:人的判断,然后量表,然后自动化评估。他不相信跳过第一步还能信任最后一步。
不是每件事都需要一次评估
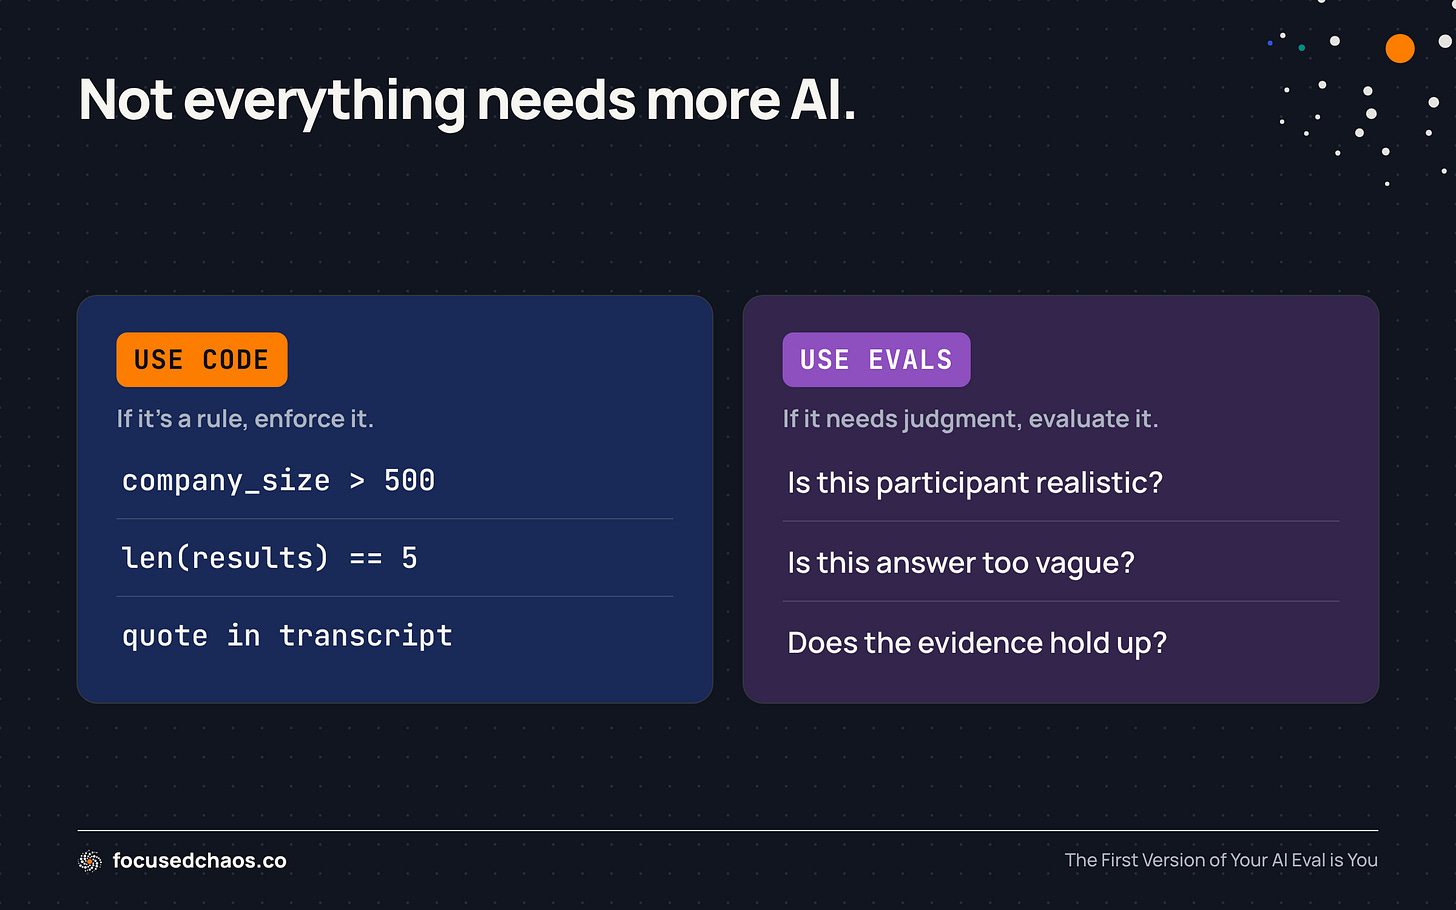
有些问题的答案不是再加一个基于大模型的评估,而是代码。研究者如果要求「公司员工超过 500 人」,这是硬条件,不该指望模型「大部分时候做对」。年龄区间、职级和其他显式标准也一样。模型可以造人,代码负责确认这个人满足条件。作者的区分是:如果它是规则,就不要好声好气地求 AI 遵守,直接强制执行。
格式固定、必须落在某个区间、必须匹配枚举值、必须恰好五项、有明确资格条件、可以用确定性方法核验——这些往往不需要评估,只需要一道检查。留给 AI 的,是真正要判断的事:参与者是否真实、回答是否含糊、追问是否好、证据是否支撑结论。多丢一个提示词去解决一切很诱人;有时正确的 AI 用量,是更少的 AI。
评估失败,有时是在要求你改体验
输出也不全是模型的责任。Candor 有清楚的「垃圾进、垃圾出」:人们用 AI 把大概只需要 50 个词的框填成 700 个词。把锅推给用户没用——总填错的字段,多半是字段、示例或校验有问题。随后的改动是体验而不是模型:字段下给更清楚的例子,可疑输入(例如读起来像研究简报的「概念描述」)先警告,未完成的设置先存下来。作者由此把评估对象从「一个模型」改成「一个里面有 AI 的产品」:用户、界面、输入、检索、模型、提示词和外围代码一起决定结果。只问该改哪条提示词,太窄。
先定义「更好」,再动手改
他写代码时会先定义「完成」,因为 Claude Code 很乐意宣布胜利。同一习惯现在用在 AI 行为上:改之前先定基线、要改善什么、怎么量、好多少才算数、成本和延迟换不换,然后再测。实验便宜之后,「多搜几次」「换新模型」「让另一个 AI 检查前一个」都说得通,产品却可能只是更慢、更贵、更复杂。
为搜索结果做了一次盲测
Candor 的合成人群部分依赖网络研究。研究弱,参与者就弱,下游全部继承这个问题。使用量上来之后,作者看到两个现象:合成用户太少,而且彼此太像。他怀疑 Perplexity 会比当时用的 Tavily 更适合做网页搜索,于是用同一批查询对比两边,初步分析没有结论。
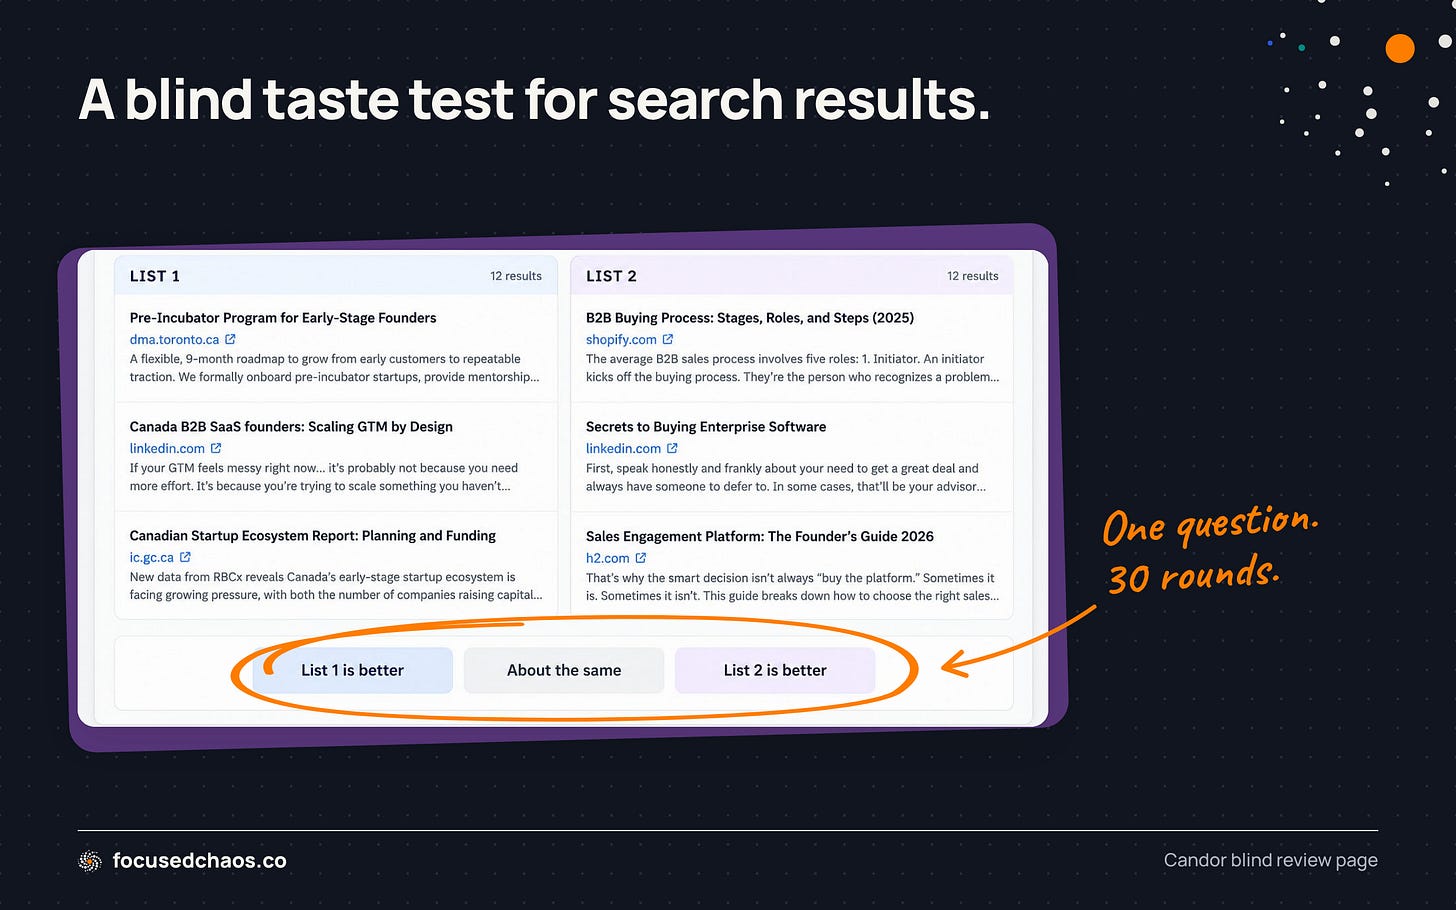
接着他让 Claude Code 做了一个盲测页:一页一个研究简报、两列搜索结果,不标明来源,左右随机。他只回答一个问题:哪一列更有助于为这个人群构建真实的合成用户。大约做了 30 轮正面对比。Perplexity 在一些区域性、尤其是针对单一国家的搜索上更强,但在寻找对合成用户仍然重要的更宽趋势时更差。这又引出下一串问题:是查询本身写坏了,还是该多搜、少搜,或每条查询只问一件事。整次实验花费 7.54 美元。早期必须有人亲手立下质量杠,先定义「更好」,再让系统替你评估;几美元加上一点时间,避免了一次盲目切换。
越是热门新模型,越需要评估
同一逻辑用在 TypeSafe 的新模型 Jev 上。它不被设计成像 ChatGPT 或 Claude 那样生成长文本;TypeSafe 称之为「系统一」(System One)模型:你给一个决策(是否、选项、打分),它返回结构化的概率答案。这正好对上 Candor 幕后的许多小决定:回答是否含糊、参与者是否已经讲过这个话题、受众研究是否已经够用。新架构又快,直觉是到处都用。作者选择先测。
他们取出测试环境里 261 条真实回答,让一个更强的模型逐条打分,当作答案键(answer key),再把 Jev 和 Candor 现有做法比较。
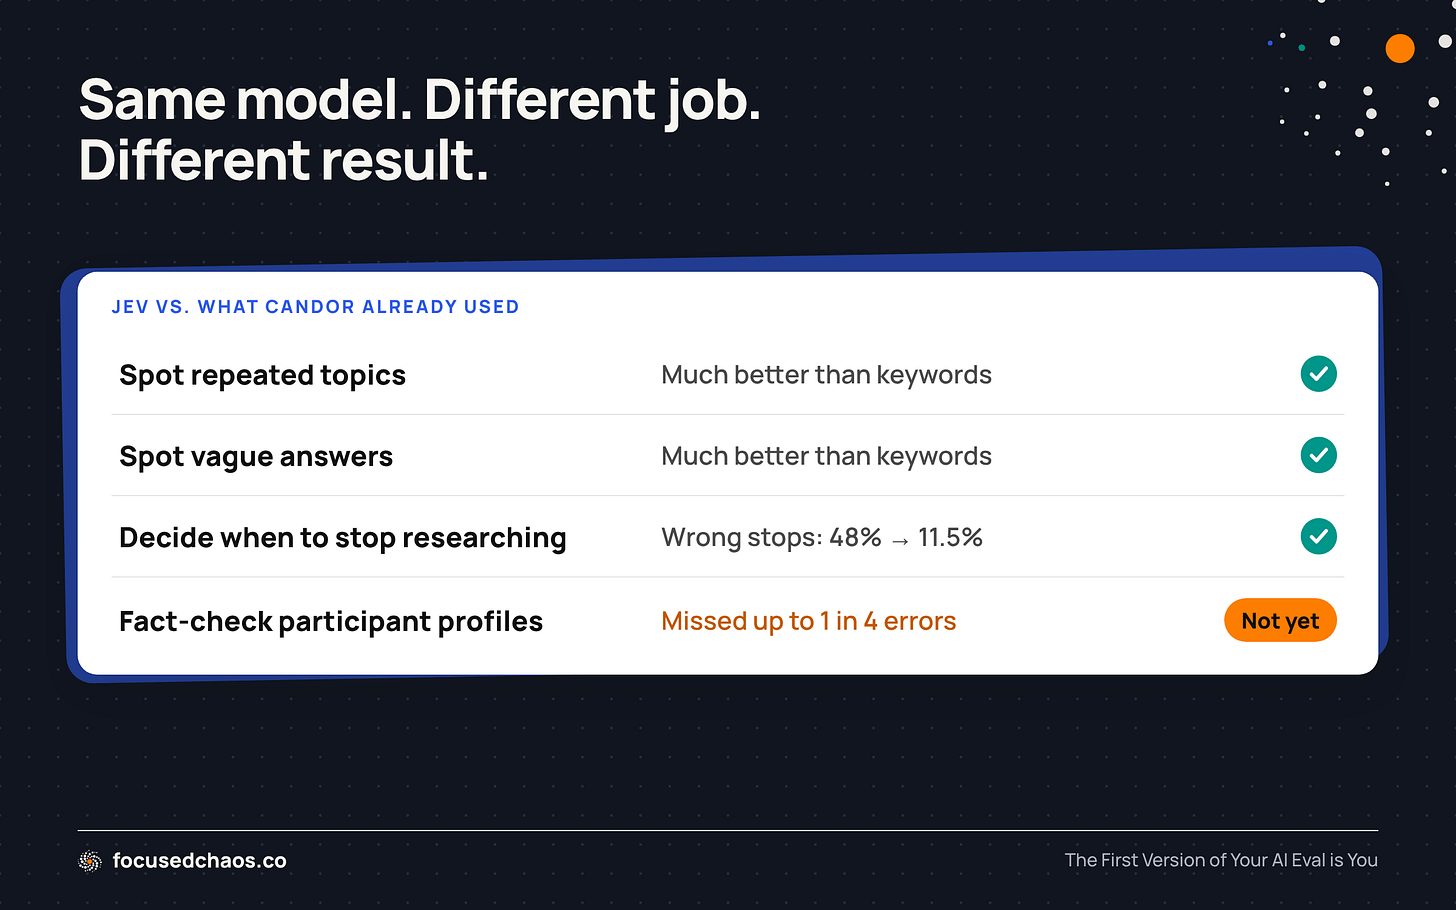
- 判断参与者是否已经说过某件事:旧的关键词规则在触发的 26 次里只对了 1 次。
- 识别含糊回答:关键词方法在 60 次里抓住 6 次。Jev 看的是意思而不是词面,两项都明显更好。
- 决定受众研究是否已经够、可以停:在 490 个重放案例里,现有小模型错误叫停的比例是 48%,Jev 是 11.5%。
- 事实核查参与者档案:Jev 还不够好。按不同测试,它会漏掉大约六分之一到四分之一的真实错误,因此这一项先不用。
同一个模型、同一个产品、不同的活,结果不同。「Jev 是不是更好」是错的问题。更好是相对哪项任务、哪批数据、哪个基线、什么成本,以及要好到什么程度才敢进生产。新,不是使用的理由;「X 上人人都在谈」也不是。
评估也会告诉你什么不该上线
过去几周他测了十几个没进 Candor 的想法:别的搜索供应商、别的查询写法、负责小决定的别的模型、额外核验。有的成了,很多没有。评估除了让 AI 更可靠,也负责告诉你什么不要上线。
建造成本塌掉之后这一点更值钱。工程产能曾经是强制函数:想做十件,只够做两件。仅最近几周他就向 Candor 合并了 200 多次改动——按几年前单干的速度,这个数字可能是零。发出 200 次不等于产品好了 200 次,编码工具也不会在乎。更难的问题从「能不能做、多快能做」变成「怎么知道它真的让产品变好了」。眼下那仍意味着大量亲手读合成访谈。配图把电影台词改成产品问题:AI 忙着证明自己做得到,却没问该不该做。