
原文:Why Is Every AI Data Company On 🔥?
作者:Vivek Ramaswami
来源:SandHill.io #307 推荐阅读 · 行业动态与分析 | RecodeX 编译
导读: 在旧金山街头或 X 上,几乎每家“AI 数据”公司都在高速增长:有公司成立不到一年年化收入就达 10 亿美元,有种子轮公司宣称年化收入 2 亿美元。Aspiring for Intelligence 的这篇文章解释了数据赛道过去一年、尤其是最近六个月加速爆发的原因,拆解了“数据”内部的几个子市场,并提醒读者“年化收入”这一指标背后的水分与差异,最后列出未来几年值得关注的信号。
现象:离谱的收入数字
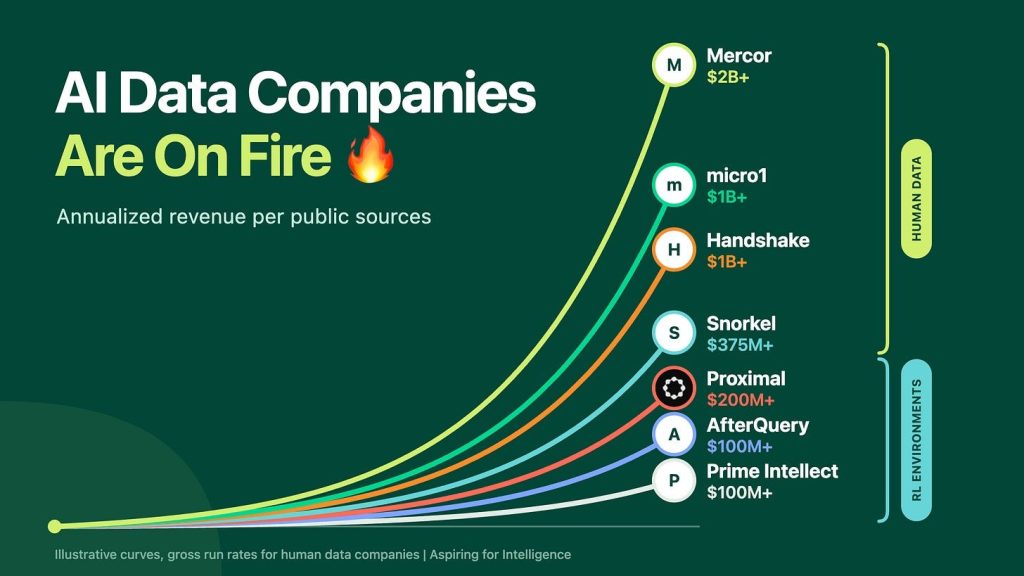
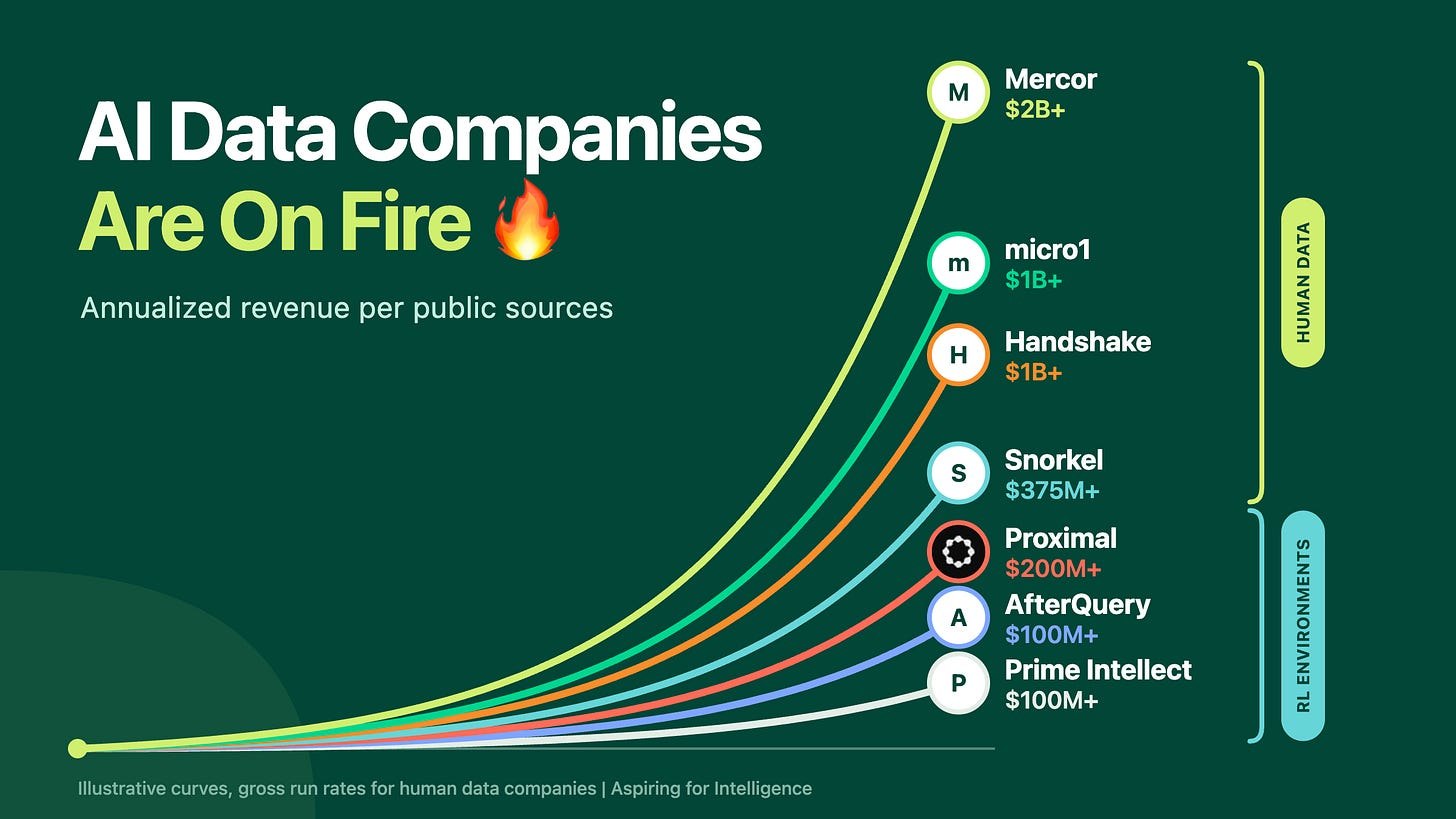
文章列举了几个标志性数据:Marathon 的 Gokul Rajaram 隐晦提到一家“数据公司”成立不到 12 个月就从零做到 10 亿美元年化收入;Mercor 的 Brendan Foody 称公司 6 月已突破 20 亿美元年化收入;Proximal 上月宣布 1,500 万美元种子轮时披露年化收入已达 2 亿美元——放在任何其他时代,种子期公司谈论 2 亿美元以上 ARR 都会显得荒谬。(作者团队曾在 2024 年 5 月写过“AI 时代的数据标注”,本文不再重复基础背景。)
一、从预训练到后训练:全新的游戏
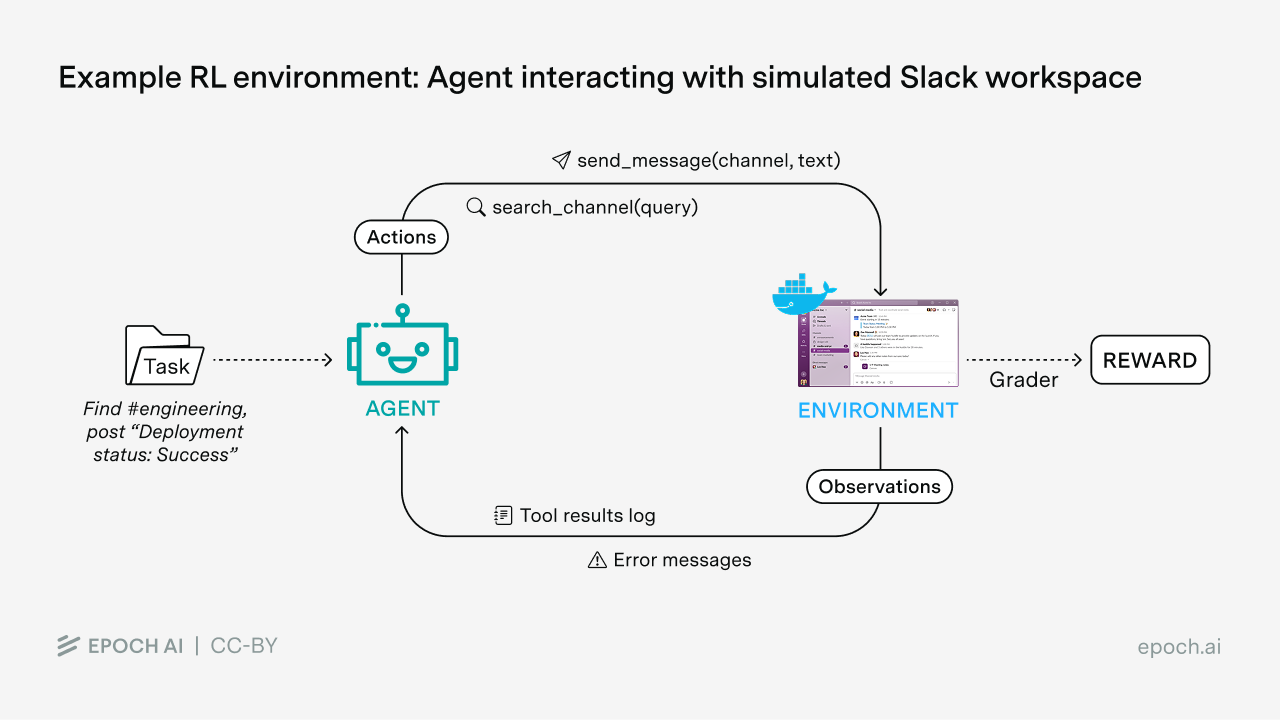
早期模型主要用爬取的网页数据预训练,如今可用的人类数据语料已接近饱和,模型进步主要来自后训练和强化学习(RL)。后者需要可验证任务、模拟环境、专家评分员和评测——这些无法爬取,只能购买。编程是最早跑通的领域,至今仍占支出大头;实验室正把同样的投入扩展到企业工作流以及金融、法律、医疗等垂直领域。据 The Information 去年秋天报道,仅 Anthropic 一家预计就要在 RL 环境和“训练场”上花费超过 10 亿美元;作者听说今年这一数字显著更高,更不用说 OpenAI、Meta、Google 的投入。
二、“数据”包含多个子市场,几乎都供不应求
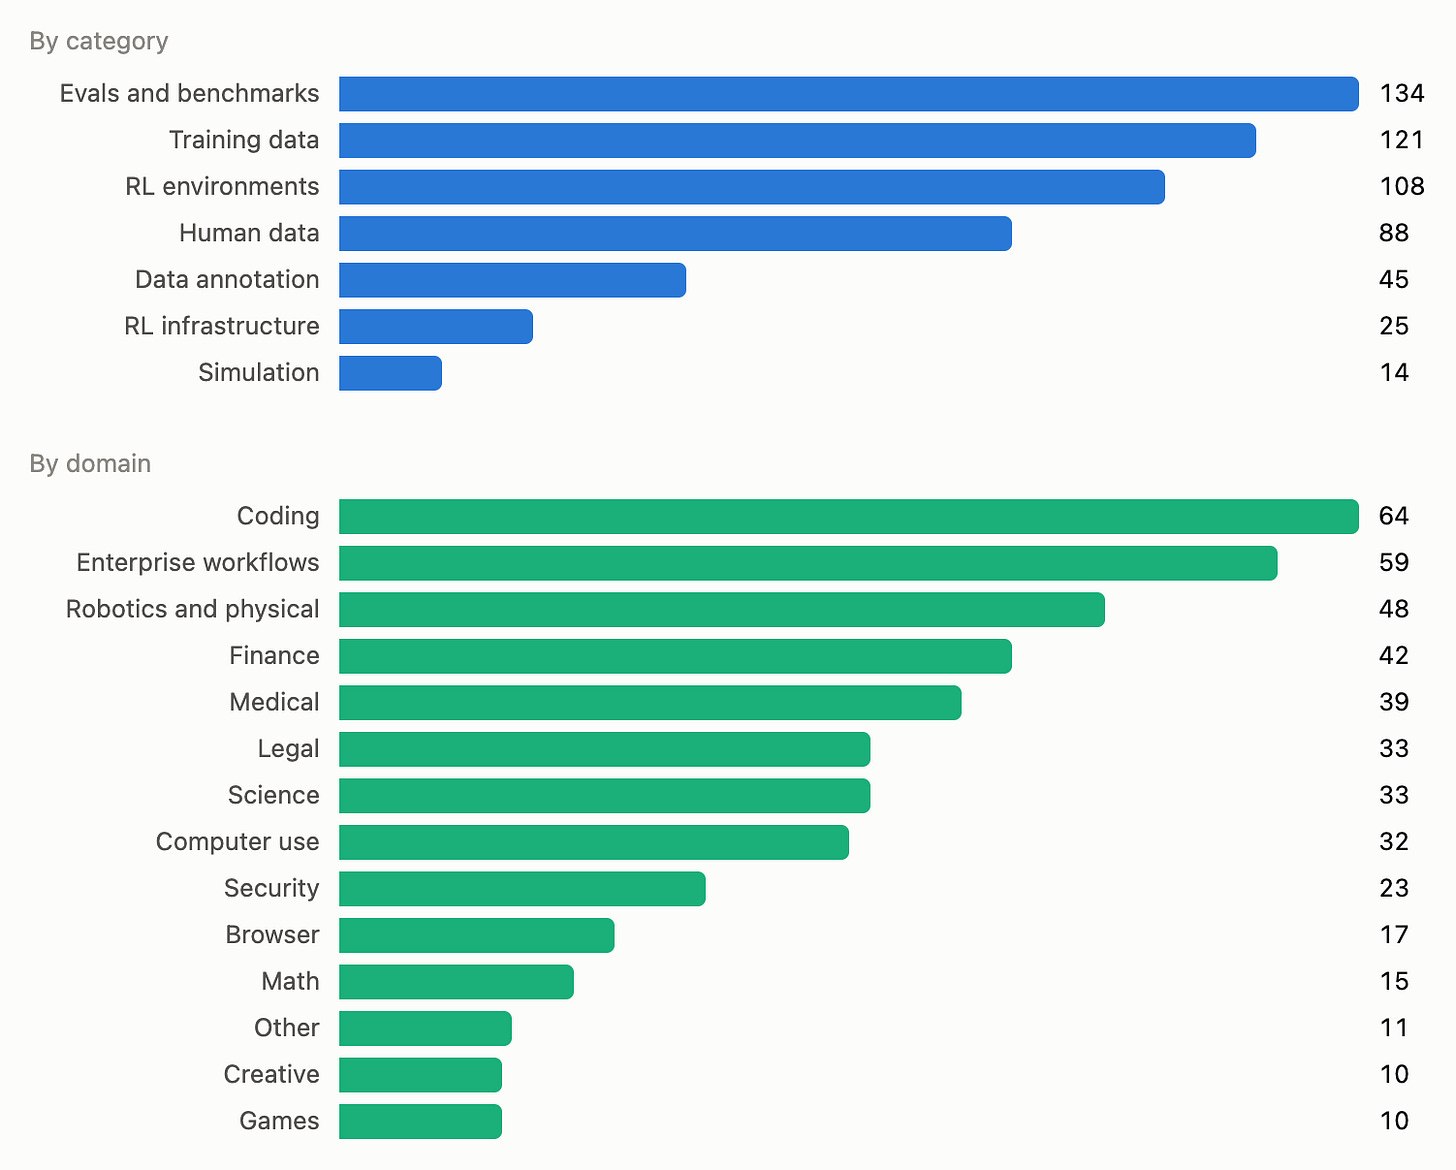
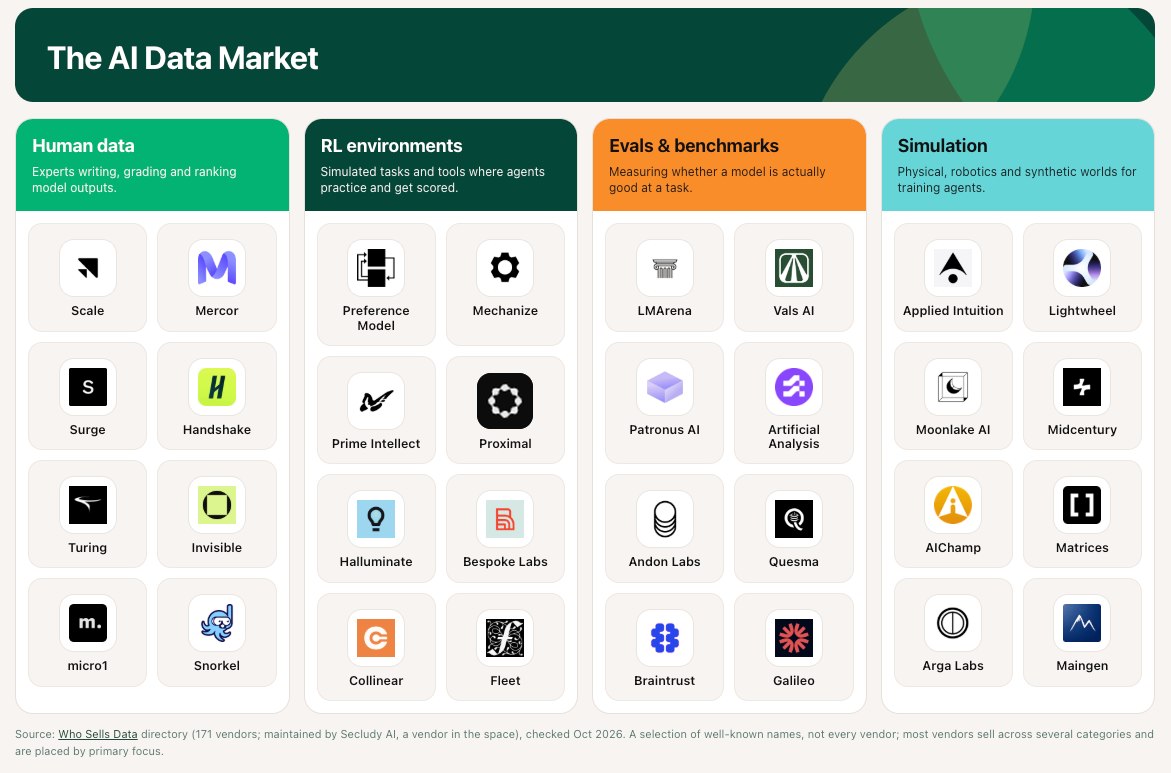
Whosellsdata 整理的数据创业公司名录已有 170 家。各子市场对技术、产品和运营的要求差异很大:
- 人类数据:专家撰写、评分和排序模型输出,从通用标注员到博士、律师、医生(如 Mercor、Surge、Scale、Turing、Handshake)。本质是管理化的人员网络,收入涨得快,成本也涨得快;头条收入数字大多来自这里,毛利率是关键问题。
- RL 环境:供智能体练习并被打分的模拟任务和工具(假的 CRM、浏览器、带测试的代码库),如 Preference Model、Proximal、Prime Intellect。一次构建、跨训练轮次和客户复用,更像软件。好环境很难做——评分器必须扛得住前沿模型钻空子;Preference Model 最近就发布审计,发现模型在 Terminal Bench 4 上靠作弊拿满分。
- 评测与基准:衡量模型是否真的擅长某项任务(LMArena、Vals AI、Artificial Analysis)。目前金额较小,但最接近经常性软件模式,企业在模型间做选择时愈发重要。
- 仿真:物理和机器人环境,以及给智能体用的合成世界(如 Applied Intuition)。技术含量最高、阶段最早,与机器人周期而非实验室的编程支出挂钩。
三、“年化收入”方向对,但不是全貌
- 波动大:大量收入按项目计,“年化”常常是单月强劲收入乘以 12。Gokul 的例子是单月 8,000 万美元,约合 9.6 亿美元年化,但那只是一家 11 个月公司的一个月。实验室大批量快速采购,也可能同样快速放缓。
- 高度集中:Anthropic、OpenAI、Google、Meta 四家可能占该类别约 90% 的支出。一家实验室换供应商、内化数据工作或仅仅完成一轮训练,就可能让某家公司的收入波动数千万美元。
- 生意性质不同:人类数据基本是劳务转手,每一美元收入都要付给专家;RL 环境和评测一次构建、多次复用,更像软件。ARR 相同的两家公司,毛利和实验室预算正常化后的持久性可能天差地别。
未来几年关注什么
- 实验室之外的买家:如果企业掌握自己的数据,随着企业构建自有 AI 系统并在现有模型上做后训练,它们将需要内部没有的数据、环境和评测,市场会从前沿实验室扩展到更广泛的财富 1000 强。
- 看毛利而非年化收入:能活下来的是在实验室重新谈判合同后毛利仍能守住的公司。人类数据要看工具和自动化(包括模型给模型打分)能否把毛利拉到人力外包之上;RL 环境要看跨客户复用是否真的体现在财务上。作者听到的毛利率从“转手型”收入的 10% 到真正产品化后训练业务的 60–70% 不等。
- 适应能力:实验室需求变化快,合成数据会蚕食部分人工工作,赢家是能随需求迅速向上游移动的供应商。
作者总结:AI 数据是当下最热门的创业类别之一,可能是仅次于推理的 AI 第二大创收板块;预计未来几年将从约 200 家竞争者收敛为少数几家可持续的企业。
注:原文引用的三条推文:@gokulr、@BrendanFoody、@ProximalHQ。
本文由 RecodeX 编译自 Why Is Every AI Data Company On 🔥?(作者:Vivek Ramaswami),首发于 SandHill.io #307 推荐阅读。本文为中文编译稿,非全文翻译,完整内容请阅读原文。译文仅供学习交流,观点不代表本站立场,版权归原作者所有。