

本文信息来源:FT

世界领先的人工智能团体正在加大力度减少大型语言模型中的“幻觉”数量,试图解决限制这项强大技术应用的一大障碍。
谷歌、亚马逊、Cohere 和 Mistral 等公司正试图通过推出技术修复、提高人工智能模型中数据的质量以及在其生成人工智能产品中构建验证和事实核查系统来降低这些捏造答案的比例。
减少这些所谓幻觉的举措对于增加法律和医疗等需要准确信息的行业对人工智能工具的使用至关重要,并有助于提高人工智能行业的收入。
此前,聊天机器人的错误已经导致代价高昂的错误和诉讼。去年,法庭下令加拿大航空公司兑现其客服聊天机器人编造的折扣,而一些在法庭文件中使用人工智能工具的律师也因编造传票而面临处罚。
但人工智能专家警告说,由于系统的运行方式,从大型语言模型中完全消除幻觉是不可能的。
“幻觉是一个非常难以解决的问题,因为这些模型的运作方式具有概率性,”谷歌前高管、生成式人工智能代理初创公司 Vectara 的创始人 Amr Awadallah 说道。“你永远无法让他们停止产生幻觉。”
出现这些错误的原因是,大型语言模型被设计为根据从训练数据中学习到的统计数据来预测句子中下一个可能的单词。
这些错误可能表现为事实错误,也可能表现为模型与指令不符,例如,总结了错误年份的事件。AI 模型的训练集中的数据至关重要,因为某条信息出现的频率越高,模型重复出现的可能性就越大。
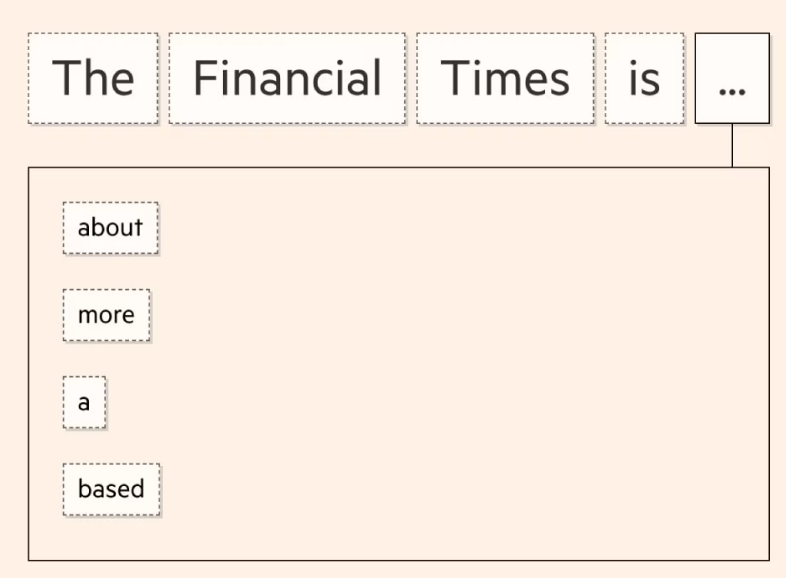
最简单的说,人工智能模型的目标是预测序列中的下一个单词,并重复执行此操作,直到输出完成。
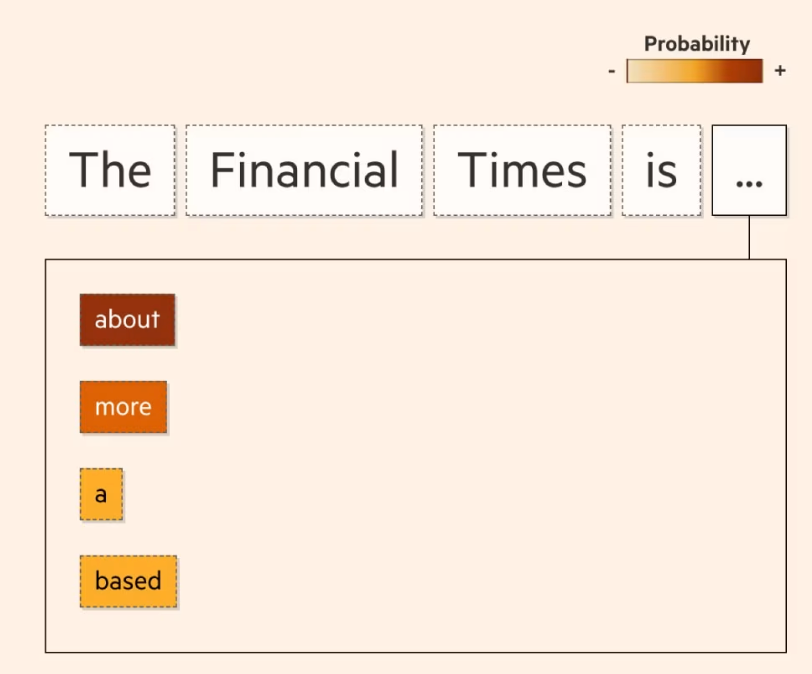
为此,模型为每个标记提供一个 概率分数 ,表示它成为序列中下一个单词的可能性。
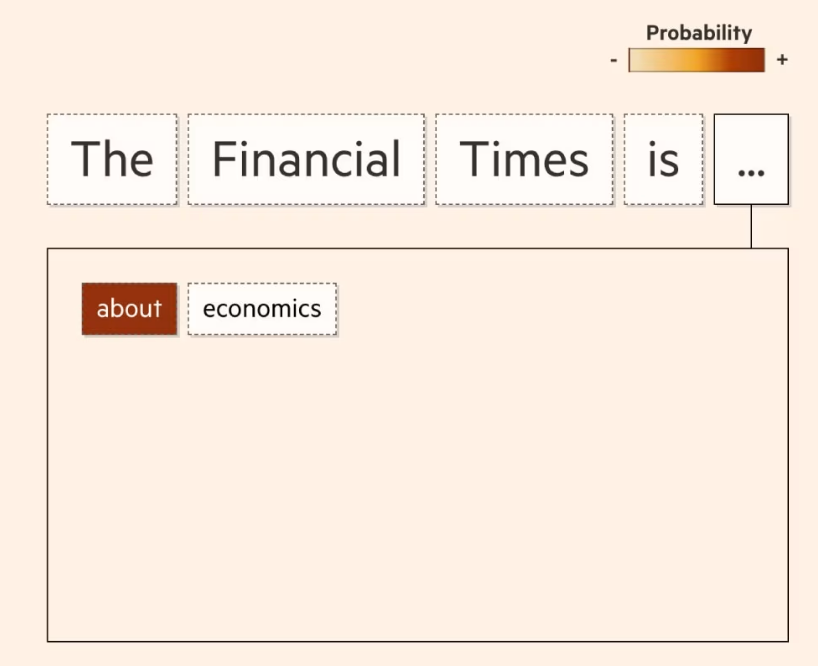
它会持续这样做,直到对生成的文本感到“满意”为止。
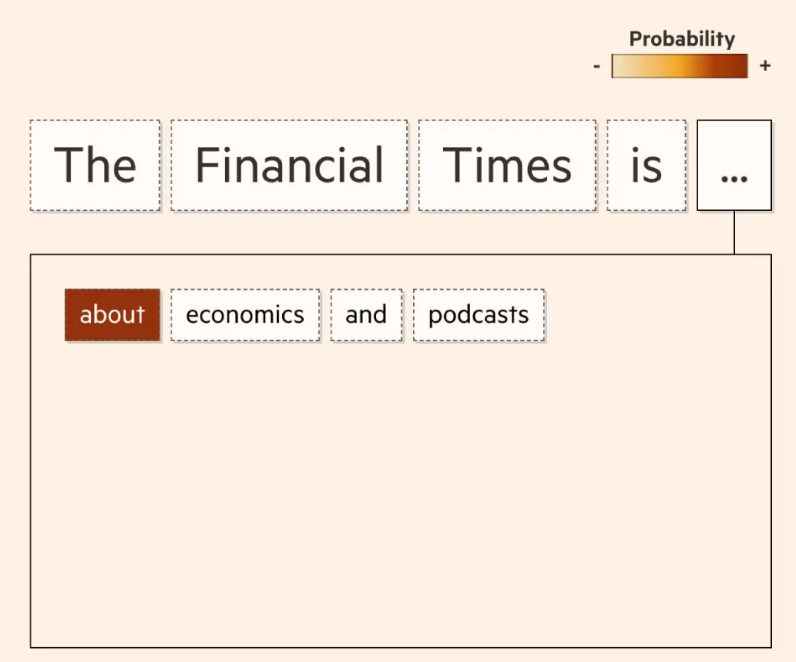
但是,这种单独预测后续单词的方法——也就是所谓的“贪婪搜索”——可能会带来问题。有时,虽然每个单独的标记可能是下一个最佳匹配,但整个短语的相关性可能较低。
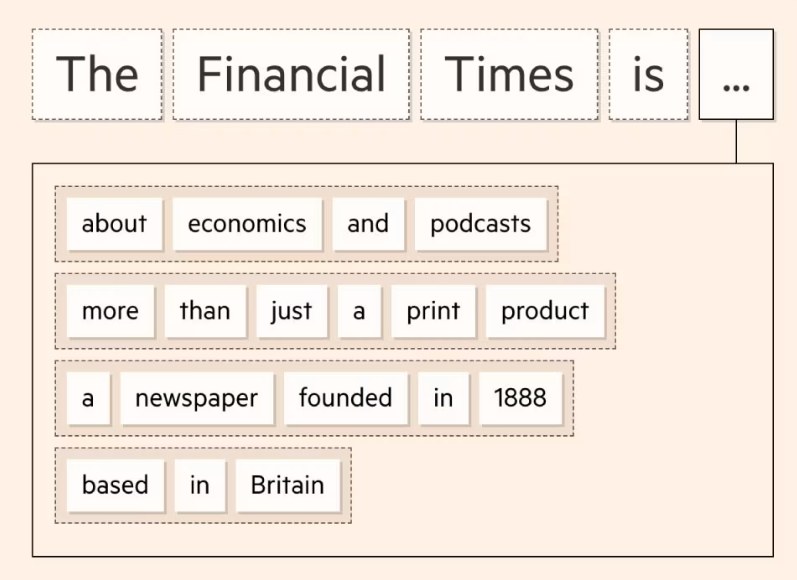
Transformer 是支持大型语言模型的架构,它使用多种方法来解决这个问题并提高其输出质量。其中一个例子就是所谓的 集束搜索 (beam search)。
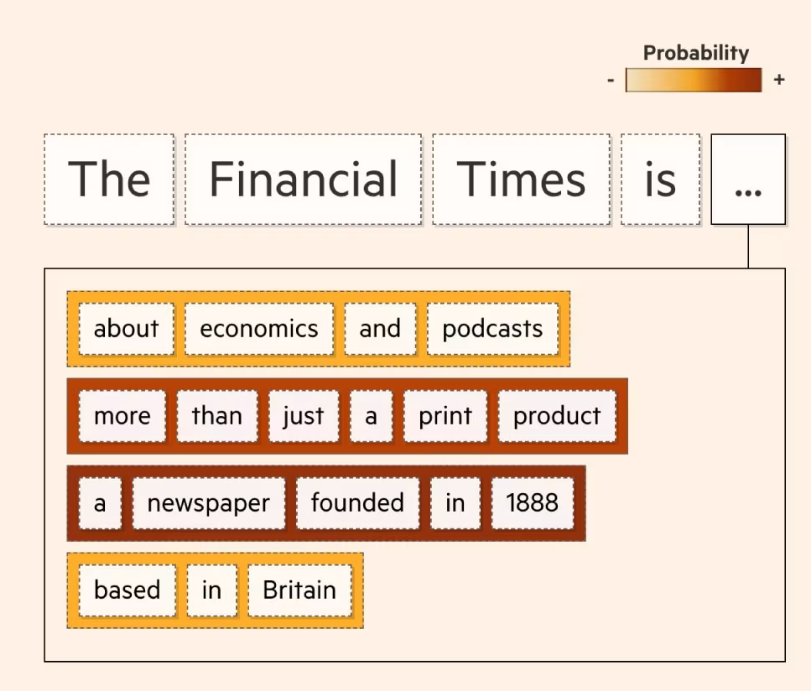
通过束搜索,模型能够考虑多条路线并找到最佳选择。
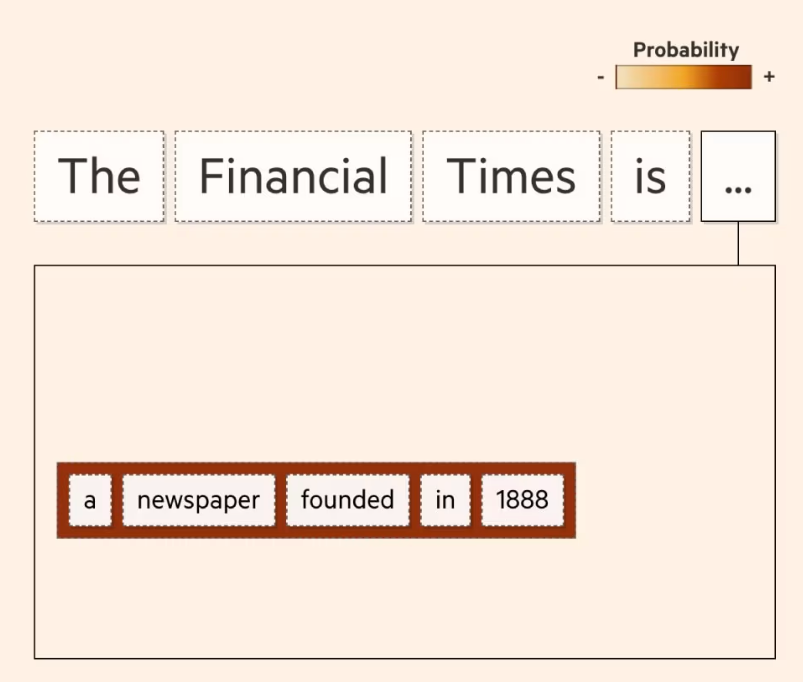
这会产生更好的结果,最终产生更加连贯、更像人类的文本。
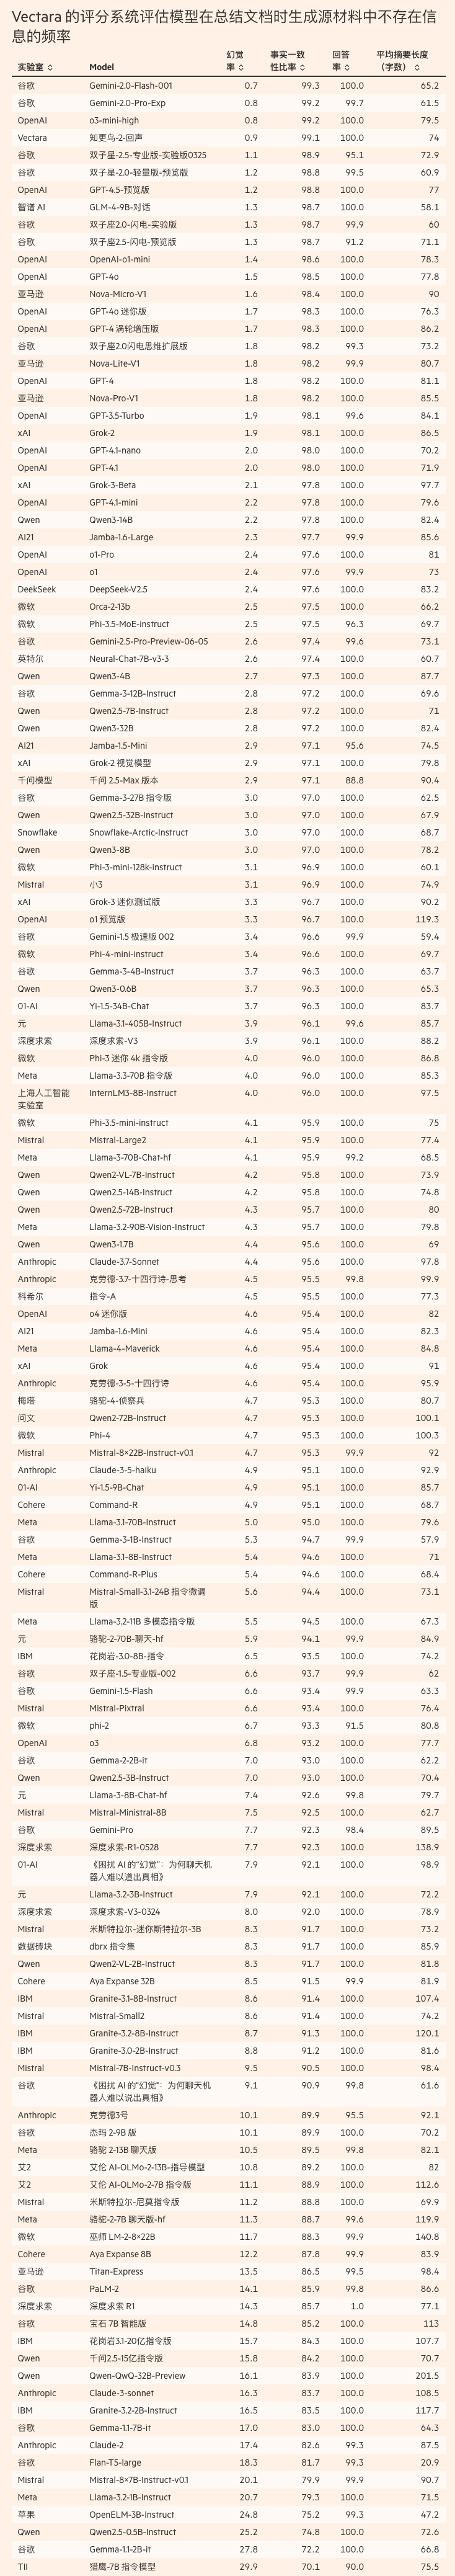
人工智能模型产生幻觉的概率差异很大。Vectara 创建了一个排行榜来追踪这些错误,发现有些模型在被要求总结一份文件时,出现幻觉的概率只有 0.8%,而另一些模型出现幻觉的概率则高达 29.9%。
随着新一代人工智能模型能够“推理”,即逐步解决问题,幻觉的发生率最初有所上升。阿瓦达拉表示,这可能是因为它们需要更长时间地在自身内部迭代,以不同的方式解决问题,这导致犯错的概率更高。然而,他补充道,随着公司学会了如何为这些模型构建更好的保护措施,幻觉的发生率已经下降。
但其研究表明,当人工智能系统“扎根”于其他信息来源,例如在线搜索、新闻文章或公司内部文件——而不是仅仅依赖于其训练数据——时,错误数量会显著减少。
这正是第三方能够将虚假信息植入大型语言模型检索信息之处,比如网站、Reddit 或维基百科。这些信息会导致 AI 模型将虚假内容当作事实呈现,或突破安全限制”行为失常”。
去年谷歌推出新 AI 搜索工具时,由于有人在 Reddit 上玩笑式地发帖,竟导致该工具建议用户往披萨上涂胶水并食用石头。
AI 开发者面临的部分挑战在于,既要验证信息的准确性,又要让模型保持”创造力”之间的平衡。
谷歌 DeepMind 表示:”在模型中构建创造力会让它们更有用,但也可能导致更多富有创意而非基于事实的答案。”
亚马逊网络服务的库克指出,有时用户可能反而”需要”这种幻觉。
“如果你试图用它们写诗,这实际上相当不错。你就是在寻找那些能发现事物间奇妙联系的怪异答案,”库克说,”而这正是 Transformer 模型真正擅长的。”
Cohere 公司的 Frosst 警告说,甚至”幻觉”这个术语也具有误导性。”这听起来太像[模型]以人类大脑的方式运作,但事实并非如此,”他表示,”它的运作方式完全不同。”