中国 AI 力量

深入洞察市场脉搏,精选高价值分析报告

中国 AI 力量
Jan 05, 2026

据称 MiniMax 计划在 AI 热潮推动下将香港 IPO 定价于区间上限

本文信息来源:bloomberg 知情人士表示,MiniMax 计划将其香港首次公开募股定价在推介区间的上限,反映出投资者对中国初创公司的热情。 在需求强劲的情况下,该公司已告知投资者将以每股165港元的价格出售股份,并计划于当地时间周一下午5点停止接受机构投资者的认购订单。 MiniMax 的 IPO 吸引了投资者对多倍于可供股份数量的认购,包括主权财富基金和全球长期投资者,公司预计将于周五开始交易。 知情人士称,MiniMax 计划将其香港首次公开募股的定价定在推介区间的上限,反映出投资者对日益挑战 OpenAI 等美国竞争对手的中国初创公司的热情。 知情人士表示,这家总部位于上海的公司已告知投资者,其将以每股 165 港元出售股份。由于未被授权公开发言,他们要求匿名。知情人士补充称,鉴于需求强劲,MiniMax 计划于周一各地区当地时间下午 5 点停止接受机构投资者的认购,比预期提前一天。 MiniMax 得到了 阿里巴巴集团控股有限公司 和阿布扎比主权财富基金的支持,是中国后 ChatGPT 时代首批上市的生成式 AI 公司之一。公司于上周三开始以每股不低于 151 港元的价格接受认购。按区间上限定价,MiniMax 将至少募资 42 亿港元(5.38 亿美元),并拥有扩大交易规模的选择权。 MiniMax 的一位代表拒绝发表评论。 北京对本土 AI 产业的支持正鼓励企业加速扩张和融资。近期 AI 相关公司的爆款表现也凸显了市场对潜在“国家冠军”、这一具有决定性意义的技术的广泛需求。 知情人士称,MiniMax 的 IPO 获得了数倍于发行股份的投资者认购需求。其中包括主权财富基金和全球只做多的长期投资者——这类投资者通常投资于他们预期会上涨的股票,并避免进行卖空。 该公司预计将于周五开始交易,为香港新年伊始的繁忙局面注入动力。预计到 2026 年,与 AI 相关的企业将填满这一区域金融中心的股票发行管道:据彭博汇编的数据,本月已有约 11 家公司公布了在香港上市的计划,募资规模最高可达 41 亿美元。 MiniMax 的首次亮相安排在与劲敌智谱同一周,两者均被视为美国 Anthropic 等公司的重要对手。它们将成为所谓“中国 AI 龙”中首批上市的企业,来自一个还包括初创公司 […]
DeepSeek 以一篇论文开启 2026 年,释放出以更低成本训练更大模型的信号 中国 AI 力量
Jan 02, 2026

DeepSeek 以一篇论文开启 2026 年,释放出以更低成本训练更大模型的信号

本文信息来源:scmp DeepSeek 发布了一篇由创始人梁文锋共同署名的技术论文,提出对其核心深度学习架构进行重新思考 中国人工智能初创公司 DeepSeek 以一篇新的技术纸开启了 2026 年,该论文由创始人梁文锋共同署名,提出重新思考用于训练基础 AI 模型的基本架构。 这一方法——被称为 Manifold-Constrained Hyper-Connections(mHC)——是这家杭州公司提升模型成本效益的努力的一部分,旨在在计算资源获取更为充足、资金实力更雄厚的美国竞争对手面前保持步伐。 这也反映了中国 AI 公司日益开放、协作的文化,它们将越来越多的研究公开发布。 对行业观察人士而言,DeepSeek 的论文常常提供一个重要的早期信号,揭示将塑造这家初创公司下一次主要模型发布的工程选择。 在这篇于周四发布的论文中,由 19 名 DeepSeek 研究人员组成的团队表示,他们在拥有 30 亿、90 亿和 270 亿参数的模型上测试了 mHC,发现其可以实现扩展而不会增加显著的计算负担。 由谢振达、魏逸轩和曹焕琪领衔的研究人员写道:“实证结果证实,mHC 能够有效地……[实现] 稳定的大规模训练,其可扩展性优于传统的 HC(超连接)。” 梁被列为期末考试作者。 该团队还补充称,“关键在于通过高效的基础设施层级优化”,mHC 在“几乎可以忽略不计的计算开销”下实现了这些提升。 这篇论文还提供了新的证据,表明尽管 DeepSeek 的知名度不断上升、梁文锋本人一直保持低调,但他仍然深度参与了这家中国最受关注的人工智能公司之一的核心研究工作。 超连接最早由字节跳动研究人员于 2024 年 9 月提出,作为对 ResNet(残差网络)的一种改进。ResNet 是一种占主导地位的深度学习架构,于 2015 年由包括传奇中国计算机科学家何恺明在内的 Microsoft Research Asia 科学家提出。 ResNet 通过稳定训练过程,使关键信息或残差在层数增加时得以保留,从而能够训练非常深的神经网络。 这篇论文由 […]

我们重新记起什么才重要的那一年 中国 AI 力量
Jan 02, 2026

我们重新记起什么才重要的那一年

本文信息来源:airsugar 感谢每一位在 2025 年与我们一同阅读、分享并共同建设的人。 “Yippee-ki-yay, motherfucker.” —— John McClane,Die Hard1(1988) 家里再次热闹起来了。Katie 从维克森林回来了,三个女孩终于齐聚一堂,几个月来第一次,收件箱可以先放一边。壁炉已经点燃。索诺玛在十二月一如既往地做着索诺玛该做的事。 此刻正是说一句简单话语的最好时机:谢谢。 五年前,我和 Krista、Will 创立了 Sugar Capital。Lisa 在两年后正式加入,但她一直都是其中的一员。在一起打造 POPSUGAR 二十年后,我们并不确定下一章会是什么样子。我们是否还能产生影响。是否真的有人需要那些试图从运营者转型为投资人的人。 五年之后,我终于感受到了。这真的在奏效。 我们不只是写支票。我们再次在构建属于自己的东西——一个品牌、一种视角、一种看待世界的方式,而这些似乎正好对创始人有用。AirSugar 成为了其中的一部分,一个可以放声思考的地方。结果发现,你们当中有很多人一直渴望不一样的东西。不是炒作。不是博眼球的观点。只是对在一个快速且残酷的世界中,什么意味着构建、投资和引领的真诚思考。 今年,有几个想法一次又一次地浮现。 在消费投资中, 品味才是 alpha,文化洞察力每一次都胜过电子表格的花式操作。那个最后的免费午餐已经消失 ,分发不再是免费的,而最聪明的构建者正在学会掌握水源,而不只是管道 。执行力会在悄然中复利累积,而表演性操作虽一时耀眼,却燃得快、褪得也快。 有些文字变得相当私人。我写到了通过微剂量使用 GLP-1s 减掉 40 磅 ,以及它们不仅仅是一个健康故事,更是在重塑人们与欲望、自律和身份之间关系的转变。这引出了我一整年反复思考的一个更大问题:当化学在重写欲望的同时,AI 又在重写工作的方式,会发生什么?我们正同时经历着两场革命 。大多数人仍然没有意识到这一点。 我们直言不讳地谈到了风险投资。谈到了反复倒腾投资条款清单的纸老虎 。 没有真正挣得自己 Equity 的顾问 。 拖慢公司节奏的自我膨胀 。真正获胜的创始人并不是更喧闹,也不是更走运。他们持续 beat 并 raise,一个季度接一个季度,用结果建立信任。没有捷径,没有表演。 我们写过支撑这一切的根本。 伟大创始人背后的母亲们 。 每个 Maverick 都需要的合伙人 。 旧金山的回归 ,它一贯的方式只有一种——通过建设。我为我的朋友、现任市长 Dan Lurie 正在做的事情感到自豪。这座城市终于由一位建设者来主导。我们在旧金山已经超过 25 年,如果你仔细观察,现在就能看见变化。Waymo 穿行在真实的街道上。AI 实验室填满了真实的办公空间。未来,正再次在悄然建设之中。 我们也写过比市场更宏大的事。关于 10 月 7 日。关于信念。关于拒绝被击垮。 我们再次起舞 。有些事情比估值更重要。 在 Sugar […]

2025 年消费级 AI 现状:成功的产品、失败的案例,以及接下来的发展方向 中国 AI 力量
Jan 01, 2026

2025 年消费级 AI 现状:成功的产品、失败的案例,以及接下来的发展方向

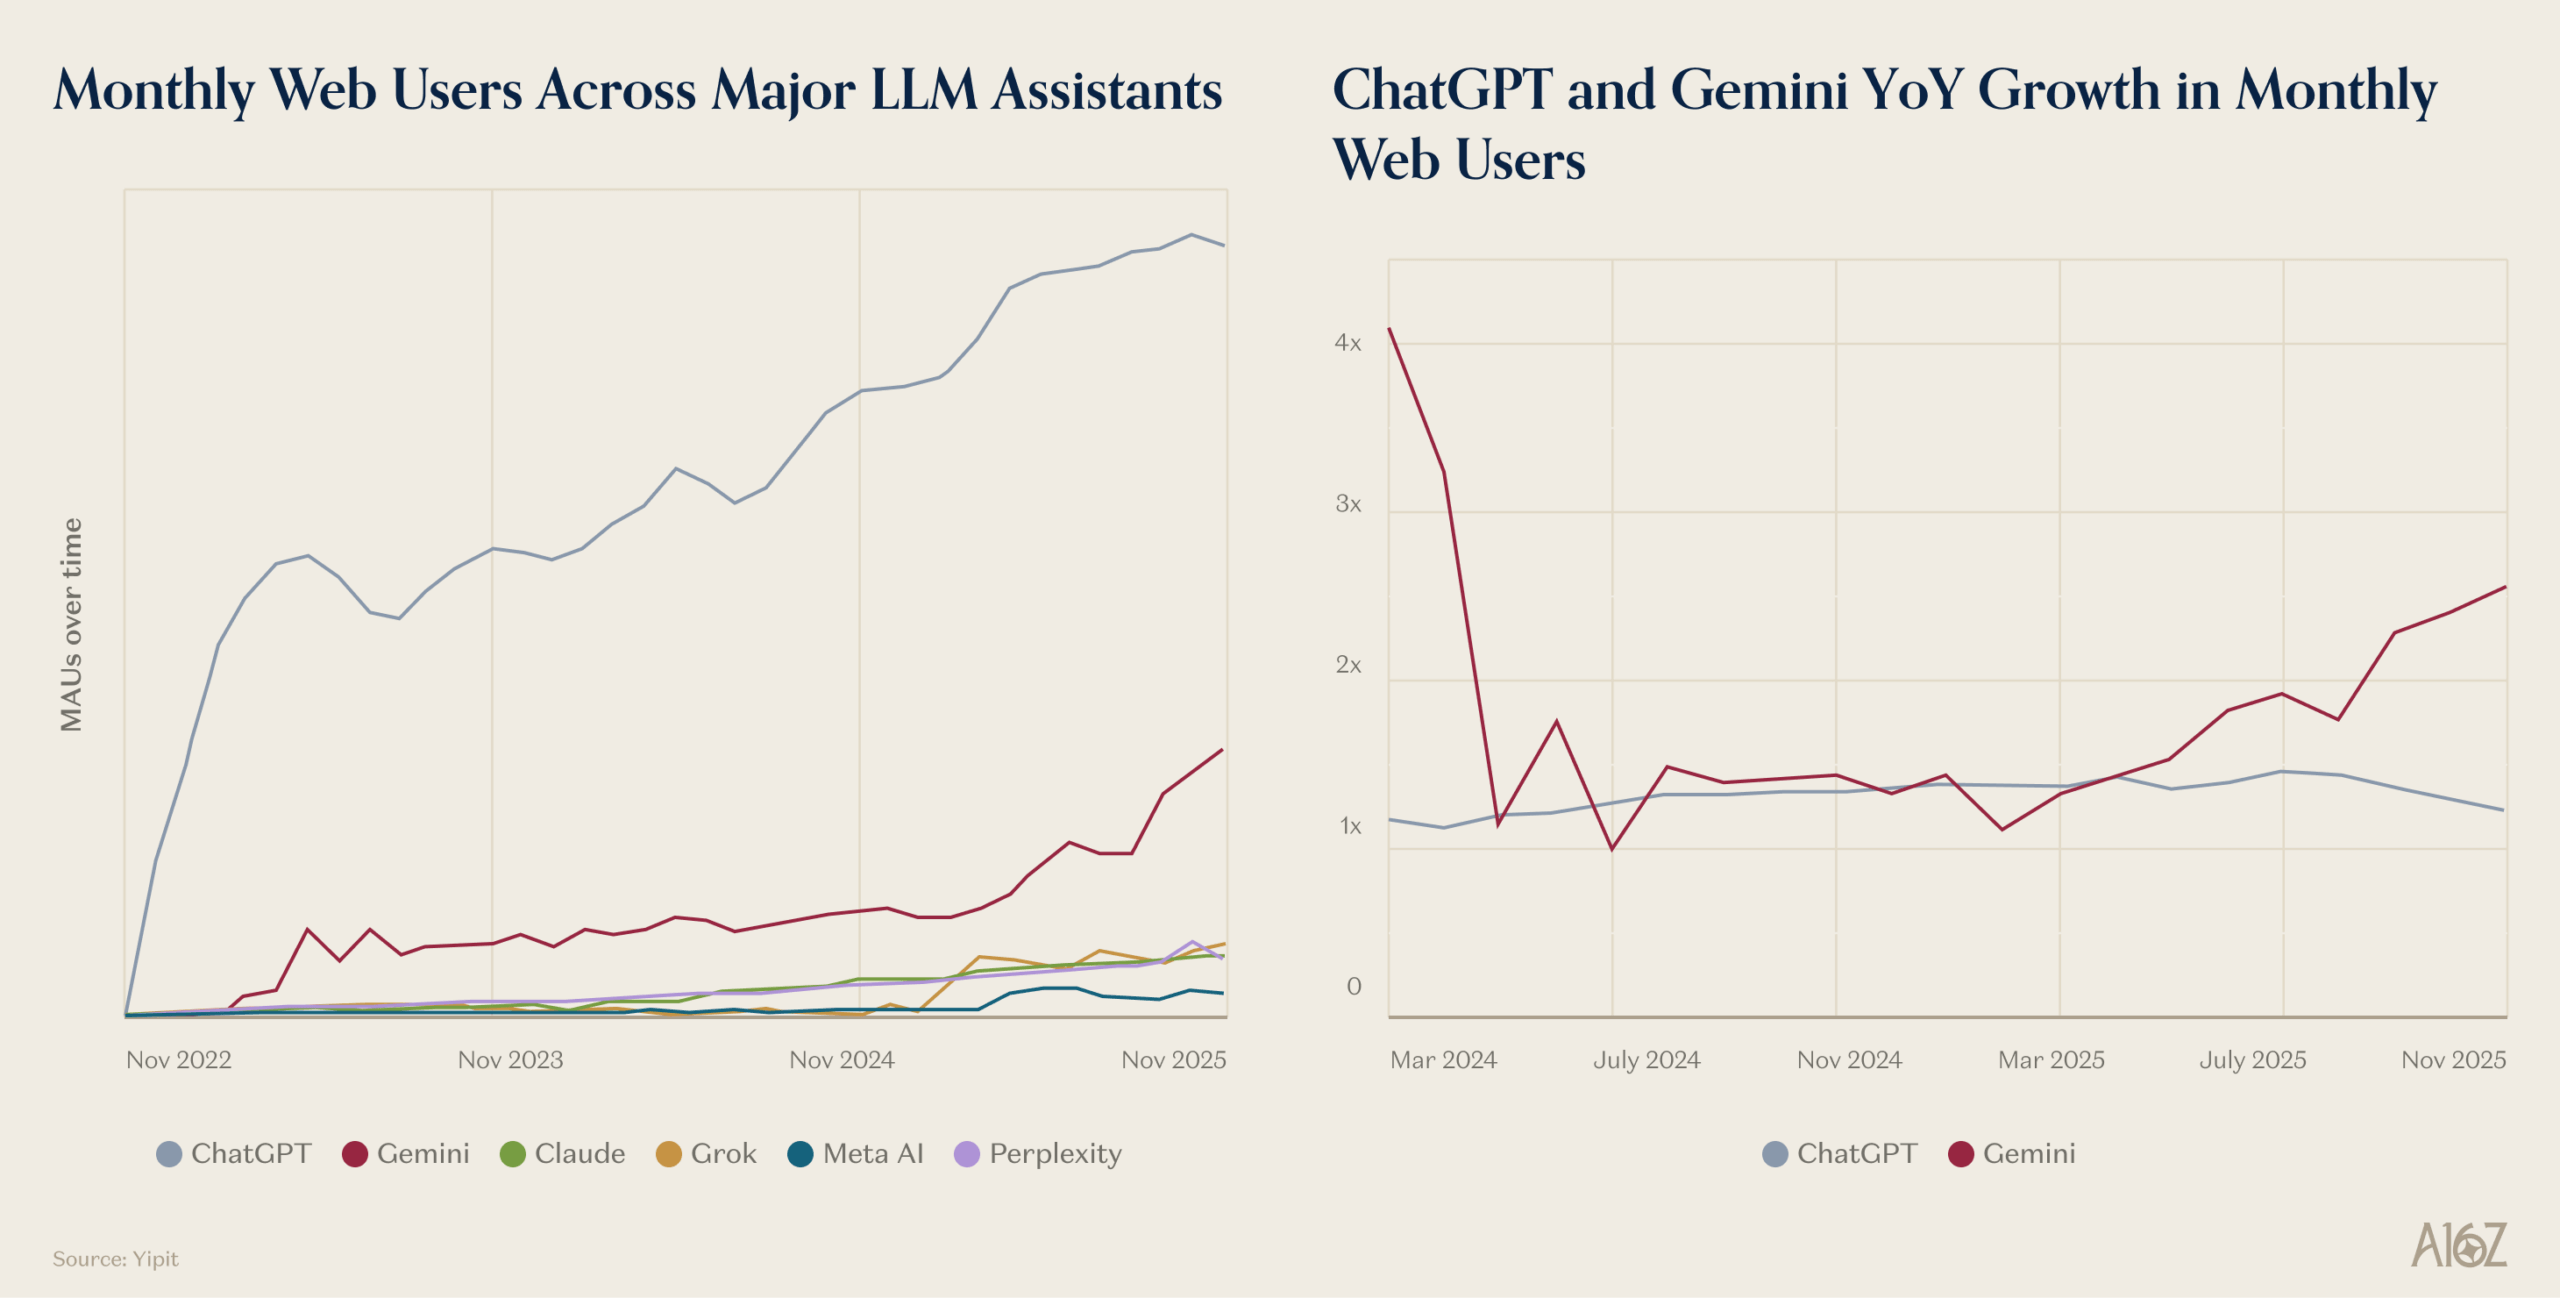
本文信息来源:a16z 对于主要 AI 实验室来说,这是一个面向消费者发布的大年。OpenAI 推出了数十项 AI 功能——包括 GPT-4o Image、独立的 Sora 应用以及群聊。Gemini 发布了多款极度病毒式传播的图像和视频生成模型(Nano Banana 和 Veo)。Anthropic、Perplexity、xAI 和 Meta 等其他实验室也在聊天、编程、搜索、图像生成等方面发布了新的面向消费者的工具。结果如何?可以说是喜忧参半。 总体而言,AI 使用量在上升。但在通用助手方面,绝大多数消费者仍然只使用 一个 。在一年中的大部分时间里,ChatGPT 的每周用户中,甚至不到 10% 访问过 其他大型模型提供商之一。Yipit 的数据显示,支出同样高度集中——在 ChatGPT、Gemini、Claude 和 Cursor 之间,只有 9% 的消费者为不止一个订阅付费。尽管 LLM 助手之争未必是“赢者通吃”,但看起来更像是“赢者通吃大部分”。 在 2023 年成为史上最快达到 1 亿 WAU 的产品后,ChatGPT 继续保持强劲的消费者采用,目前在各个平台上的 WAU 估计达到 8 亿到 9 亿。Gemini 在网页端的规模约为 ChatGPT 的 34%,在移动端为 40%。在用户参与度和留存方面,ChatGPT 也占据主导地位。根据 Yipit 的数据,ChatGPT 的 DAU/MAU […]

Tether 旗下公司将加密货币矿工出售给其创始人经营的公司 中国 AI 力量
Dec 21, 2025

Tether 旗下公司将加密货币矿工出售给其创始人经营的公司

[videopress pzpDfUnx] 本文信息来源:ft 稳定币巨头 Devasini 是从 Northern Data 收购 Peak Mining 的各集团的董事 Tether 的 USDT 币目前流通量约为 1860 亿美元 © Lam Yik/Bloomberg 由 Tether 神秘的创始人控制的公司从这家稳定币巨头自身持有的一家 AI 企业手中收购了一家加密货币矿工,这凸显了这家全球最大的加密公司之一如何管理其复杂的投资网络。 Tether 是德国 AI 数据中心运营商 Northern Data 的大股东。Northern Data 于 11 月宣布,其已以最高 2 亿美元的价格出售了旗下的 Bitcoin 挖矿业务 Peak Mining。随后,一份美国监管文件披露,买方分别为 Highland Group Mining Inc、Appalachian Energy LLC 和 2750418 Alberta ULC。 英属维尔京群岛的一份备案显示,Highland Group 的董事包括 […]

二级市场:第二次的魅力…… 中国 AI 力量
Dec 15, 2025

二级市场:第二次的魅力……

本文信息来源:ontheflyingbridge 根据摩根大通资产管理公司的数据 ,截至 2024 年底,全球另类资产管理规模估计为 19.5 万亿美元,其中约 4 万亿美元为私募股权,而其中一半投资于存续期超过四年的基金。令人有些意外的是,直到过去几年,二级市场活动才出现爆发式增长。然而,尽管领先的二级市场投资公司 Lexington Partners 预计 2025 年将成为二级市场交易量的高水位标志,但 2000 亿美元的交易额也仅占全球资产管理规模的约 1%。 过去十二年间,二级市场的活跃度增长了约 8 倍。在二级市场交易的历史中,80%的活动仅发生在过去十年间。直到大约五年前,二级市场的”干火药”(待投资金)规模至少可以覆盖一到两年的交易量。这种情况在 2025 年发生了变化,二级市场迅速成熟,加之过去几年并购和 IPO 交易量大幅下降,私募投资者对流动性的结构性需求变得十分迫切。 二级市场交易量及可用”干火药”年数 资料来源:莱克星顿合伙公司(Lexington Partners) 二级市场交易通常有两种类型:(i)有限合伙人出售其在基金中的权益(”LP 主导型”);和/或(ii)普通合伙人创建”延续基金(CV)”,将特定投资组合公司出售给新实体,为原始投资者提供流动性或转入延续基金的机会(通常称为”GP 主导型”交易)。 据杰富瑞(Jefferies)统计 ,2025 年上半年二级市场交易量达 1030 亿美元,其中 560 亿美元为 LP 主导型交易,470 亁美元为 GP 主导型交易。这一活跃度较 2024 年上半年的 680 亿美元增长了 51%。 机构投资者对二级市场的兴趣可以从该行业资产管理规模的显著增长中看出。根据 Pitchbook 的数据,2025 年第一季度总资本达到 6870 亿美元,在过去二十年中增长了近 20 倍。据估计,目前流入二级市场基金的资金中约有 10%来自零售投资者,这进一步凸显了市场接受度的扩大。二级市场基金往往是获得 SpaceX 和 […]

H100 与 GB200 NVL72 训练基准对比 中国 AI 力量
Aug 23, 2025

H100 与 GB200 NVL72 训练基准对比

本文信息来源:semianalysis 功耗、总体拥有成本及可靠性分析,软件随时间改进 每令牌焦耳数、百万令牌 TCO、MFU 指标、美国家庭年能耗可处理的令牌数、DeepSeek 670B、GB200 可靠性问题、背板停机时间 前沿模型训练已将 GPU 和 AI 系统推向性能极限,使得成本效益、能源效率、单位总拥有成本(TCO)下的性能表现以及系统可靠性成为高效训练的核心议题。Hopper 与 Blackwell 架构的对比绝非英伟达宣传的那般简单。 本报告将首先展示超过 2000 块 H100 GPU 的基准测试结果,分析模型浮点运算利用率(MFU)、总拥有成本(TCO)及每训练百万 token 成本等数据。我们还将研究能源消耗,通过计算每训练 token 所消耗的实用焦耳能量,并将其与美国普通家庭年用电量进行对比,从社会维度重构能效认知。此外,我们将呈现 GPU 集群从 128 块 H100 扩展到 2048 块 H100 时,以及在不同版本英伟达软件环境下的分析结果。 在本报告后续部分,我们还将分析 GB200 NVL72 在 Llama4 400B MoE 和 DeepSeek 670B MoE 上的基准测试结果,并将这些数据与之前 H100 的测试结果进行对比。我们将探讨:当计入可靠性因素后,GB200 NVL72 的每美元性能优势是否依然成立。 可靠性不足导致的停机与工程时间损耗,是我们计算总体拥有成本(TCO)效能比时考量的主要因素之一。目前由于软件持续完善及可靠性问题尚待解决,GB200 NVL72 尚未进行过大规模训练任务。这意味着英伟达的 H100/H200 […]

Cogito v2 预览 从推理时搜索到自我改进 中国 AI 力量
Aug 19, 2025

Cogito v2 预览 从推理时搜索到自我改进

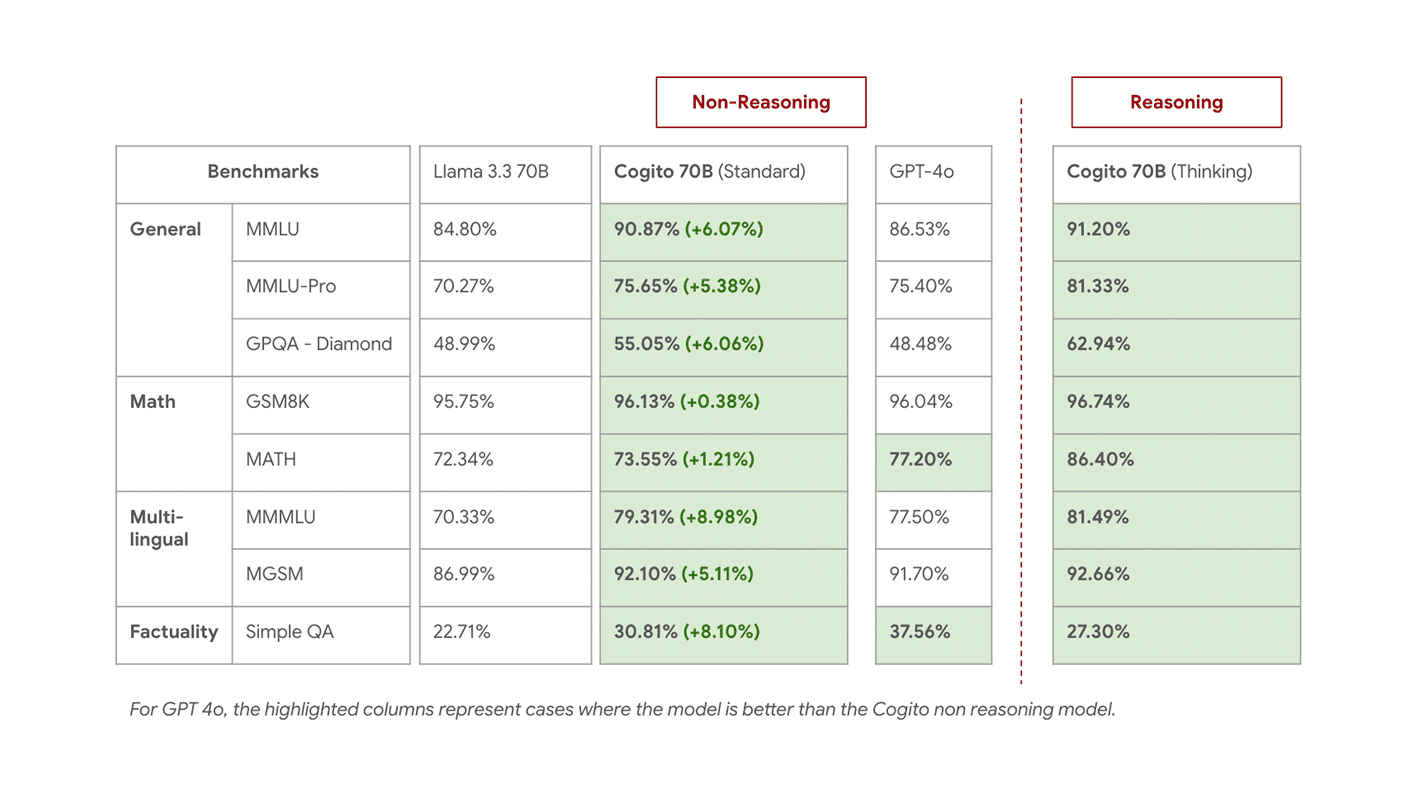
本文信息来源:deepcogito 要点 我们在开放许可下发布了 4 个混合推理模型。 2 个中型模型 – 70B 稠密模型,109B MoE 模型 2 个大型模型 – 405B 稠密模型,671B MoE 模型 最大的 671B MoE 模型是全球最强的开源模型之一 。它在性能上与最新的 DeepSeek v3 和 DeepSeek R1 模型相当或更优,并接近 o3 和 Claude 4 Opus 等封闭前沿模型。 我们通过扩展迭代蒸馏与增强(Iterated Distillation and Amplification,IDA) 的方法,并扩大模型的智能先验 ,来推进我们在构建超级智能方面的工作。具体做法是让模型通过迭代策略改进来内化推理过程,而不是仅仅在推理阶段延长搜索时间。 这是一种全新的扩展范式,使模型能够发展出更多的“直觉”,并且为自我改进 (AI 系统自我提升)提供了有力的概念验证。 由于 Cogito 模型在搜索过程中对应采取的轨迹有了更好的直觉,其推理链比 Deepseek R1 短 60%。 与普遍认为此类技术创新需要资本密集型基础设施的观点相反,这种方法的效率也显著更高(Cogito 模型的总训练成本低于 350 万美元)。 接下来,我们计划在迭代自我改进的成果上不断攀升,以构建超级智能。我们创建的所有模型都将开源。 你可以在 Huggingface 上下载这些模型,或通过 Together AI、Baseten 或 RunPod 的 API 直接使用它们,或者使用 Unsloth 在本地运行。 我们的方式 构建超级智能从根本上来说是一个可解的机器学习问题。 我们构建超级智能的方法如下: 步骤 […]

AI 进展:冷战 2.0 的战场 中国 AI 力量
Aug 11, 2025

AI 进展:冷战 2.0 的战场

本文信息来源:contrary 美中人工智能竞争已从单纯的技术霸权竞赛演变为复杂的生态系统博弈,不同路径可能共存甚至相互补充。至少目前是这样。 当一家鲜为人知的中国初创公司 DeepSeek 于 2025 年 1 月 20 日发布其 R1 模型时,它以性能震惊世界,表现匹敌如 OpenAI 的 o1 等顶级系统,且据称成本仅为 6–7%。仅仅在七天之后,DeepSeek 超过 ChatGPT,成为美国 iOS App Store 下载量最高的免费应用,并在单日内导致美国股市抹去约一万亿美元的市值。 DeepSeek 的成就是在美中之间持续进行的人工智能“军备竞赛”中取得的。美国采取产业主导、以算力为核心的方法,押注通过积累强大算力资源(如 NVIDIA 的 H100 芯片)并在前沿模型开发上投入巨资来赢得这场竞赛。但 DeepSeek 的出现对这一模式提出了挑战,声称用更少的芯片和更小的预算就能取得相同成果。曾经认为中国在 AI 发展上至少落后美国“数年”的美国专家们,被一种迫在眉睫的可能性所震惊:凭借更高效、更具成本效益的生态系统,中国可能正在缩小与美国在 AI 发展上的差距。 然而,事实比“中国的 AI 生态系统正在‘赢’”这一叙述要复杂得多。虽然 DeepSeek 的 R1 模型确实标志着模型开发上的一次重要飞跃,但这一成果为何出现并不像 DeepSeek 希望世界相信的那样清晰。此外,中国更广泛的政治环境和发展基础设施可能会阻碍未来加速进展。 两种不同的方法 美国路径:由资本市场驱动、算力充裕 美国的做法可以概括为一种充满活力、由资本市场驱动的发展模式。私人公司和投资者主导着美国的人工智能资金投入,这促成了资源的灵活配置和基础设施的快速扩张以满足需求。 美国公司用于训练人工智能模型的算力需求远远超出传统预期。但美国的人工智能生态系统能够跟上这种指数级的进展。例如,自 2012 年以来,用于顶级 AI 训练的算力大约增长了 300000 倍(每约 3.4 个月翻一番),远远超过摩尔定律两年翻一番的基准。公开数据证实,OpenAI 的数据中心集群已达 100000 块 […]