闭源与开源:持续不断的模型市场份额之争
模型层堪称“蛮荒之地”——任何使用特定模型的公司都必须明白自己为何选择它……以及为了获得该模型的使用权限而需要放弃什么。
在过去的几周里,企业技术领域最具影响力的两位专家几乎表达了相同的观点:如果一家企业将自己的专有数据输入到封闭式的先进模型中,那无异于在为自己的未来竞争对手提供资金支持。他们认为,另一种选择或许更具吸引力。
那么替代方案是什么呢?在今天的文章中,我将分析开源模式的优缺点,以及为何此刻大家都特别关注它。
向开源方向转变?
作为背景补充,开源模型指的是其底层架构、训练代码以及模型权重都会被公开发布的人工智能模型。与需要支付费用才能使用 API 且数据会存储在外部服务器上的专有模型(如 ChatGPT 或 Claude)不同,开源模型可以下载下来,对其进行修改,然后在自己的硬件上私密运行。
开源模型近期已跃居人工智能领域讨论的焦点。
在 7 月 1 日一次备受关注的 CNBC Squawk Box 节目中,Palantir 的首席执行官亚历克斯·卡普表示,企业客户对那些处于前沿的人工智能公司越来越持怀疑态度,他们担心为了使用封闭式的 AI 模型而不得不放弃自身的知识产权和竞争优势。他说道:“这个国家的企业普遍持有的观点是……‘我何必浪费时间去研究那些代币,反正得不到任何好处,而且他们的还会拿走我的知识产权。’”
确实值得注意的是,卡尔普当时出镜是为了宣传自己的新书。他在讨论帕兰提尔与英伟达之间日益紧密的合作关系——双方正在将英伟达的 Nemotron 模型整合到帕兰提尔的 Sovereign AI 平台中,该平台能够让政府机构和企业在一个安全的环境中运用人工智能,同时仍能掌控自己的数据及模型权重(本质上是一种加入了安全措施的开放源代码方案)。他提出这样一个问题:当国防部向某个实验室提出应用需求时,“是这些实验室能够控制模型权重,还是模型供应商才能控制它们?”市场也对这一观点做出了反应:那天上午帕兰提尔的股价上涨了 9%以上,此后还又上升了几个百分点。
就在上周日,Microsoft 的首席执行官萨提亚·纳德拉也在一篇博客文章中提出了同样的观点——这一点尤其值得关注,因为 Microsoft 不仅是 OpenAI 最大的支持者之一,还通过 Azure 与 Anthropic 保持着密切联系。纳德拉指出,企业实际上“要为智能技术支付两次代价:一次是用金钱,另一次则是用更宝贵的东西——即为了让这些智能技术发挥作用而不得不公开的专有知识”。模型是通过各种“输入数据”来学习的,包括人们输入的提示语、智能体使用的工具,以及当模型出现错误时人们所做的修正,而每一次修正都会被转化为企业的宝贵经验。
萨蒂亚提出的几项应对这些实验室公司的建议早已被客户们牢记在心:(1)掌握自己数据的所有权;(2)引入调度机制,以便能够在不同供应商之间切换,而不必受制于某一家。更关键的是,他还指出了这些实验室公司存在的根本矛盾:它们声称有权使用全球的公共数据来训练模型,但却同时设定诸多限制条款,阻止客户提取这些模型并加以利用。
蒸馏是一种机器学习技术,通过该技术,大型且功能强大的模型(即“教师模型”)能够将其知识传递给规模更小、运行速度更快的模型(即“学生模型”)。本质上,相关团队试图建立一种单向机制:我们可以利用你们的输出来训练模型,但你们却无法用我们的模型来训练。
他从未直接提及“开源”,但在这之前几天接受的一次采访中已透露了相关含义:“世界上的模型数量应该与企业数量相当……我不想被束缚在某一种模型之下。”
那成本方面呢?嗯……从经济性来看,开源方案似乎也更具有优势。8090 的研究表明,在处理实际企业级工作负载时,运行在私有基础设施上的开源模型,其成本仅为 Claude 的 1/16.4。
那些实验室型企业究竟是如何等待着始终处于行业前沿的?
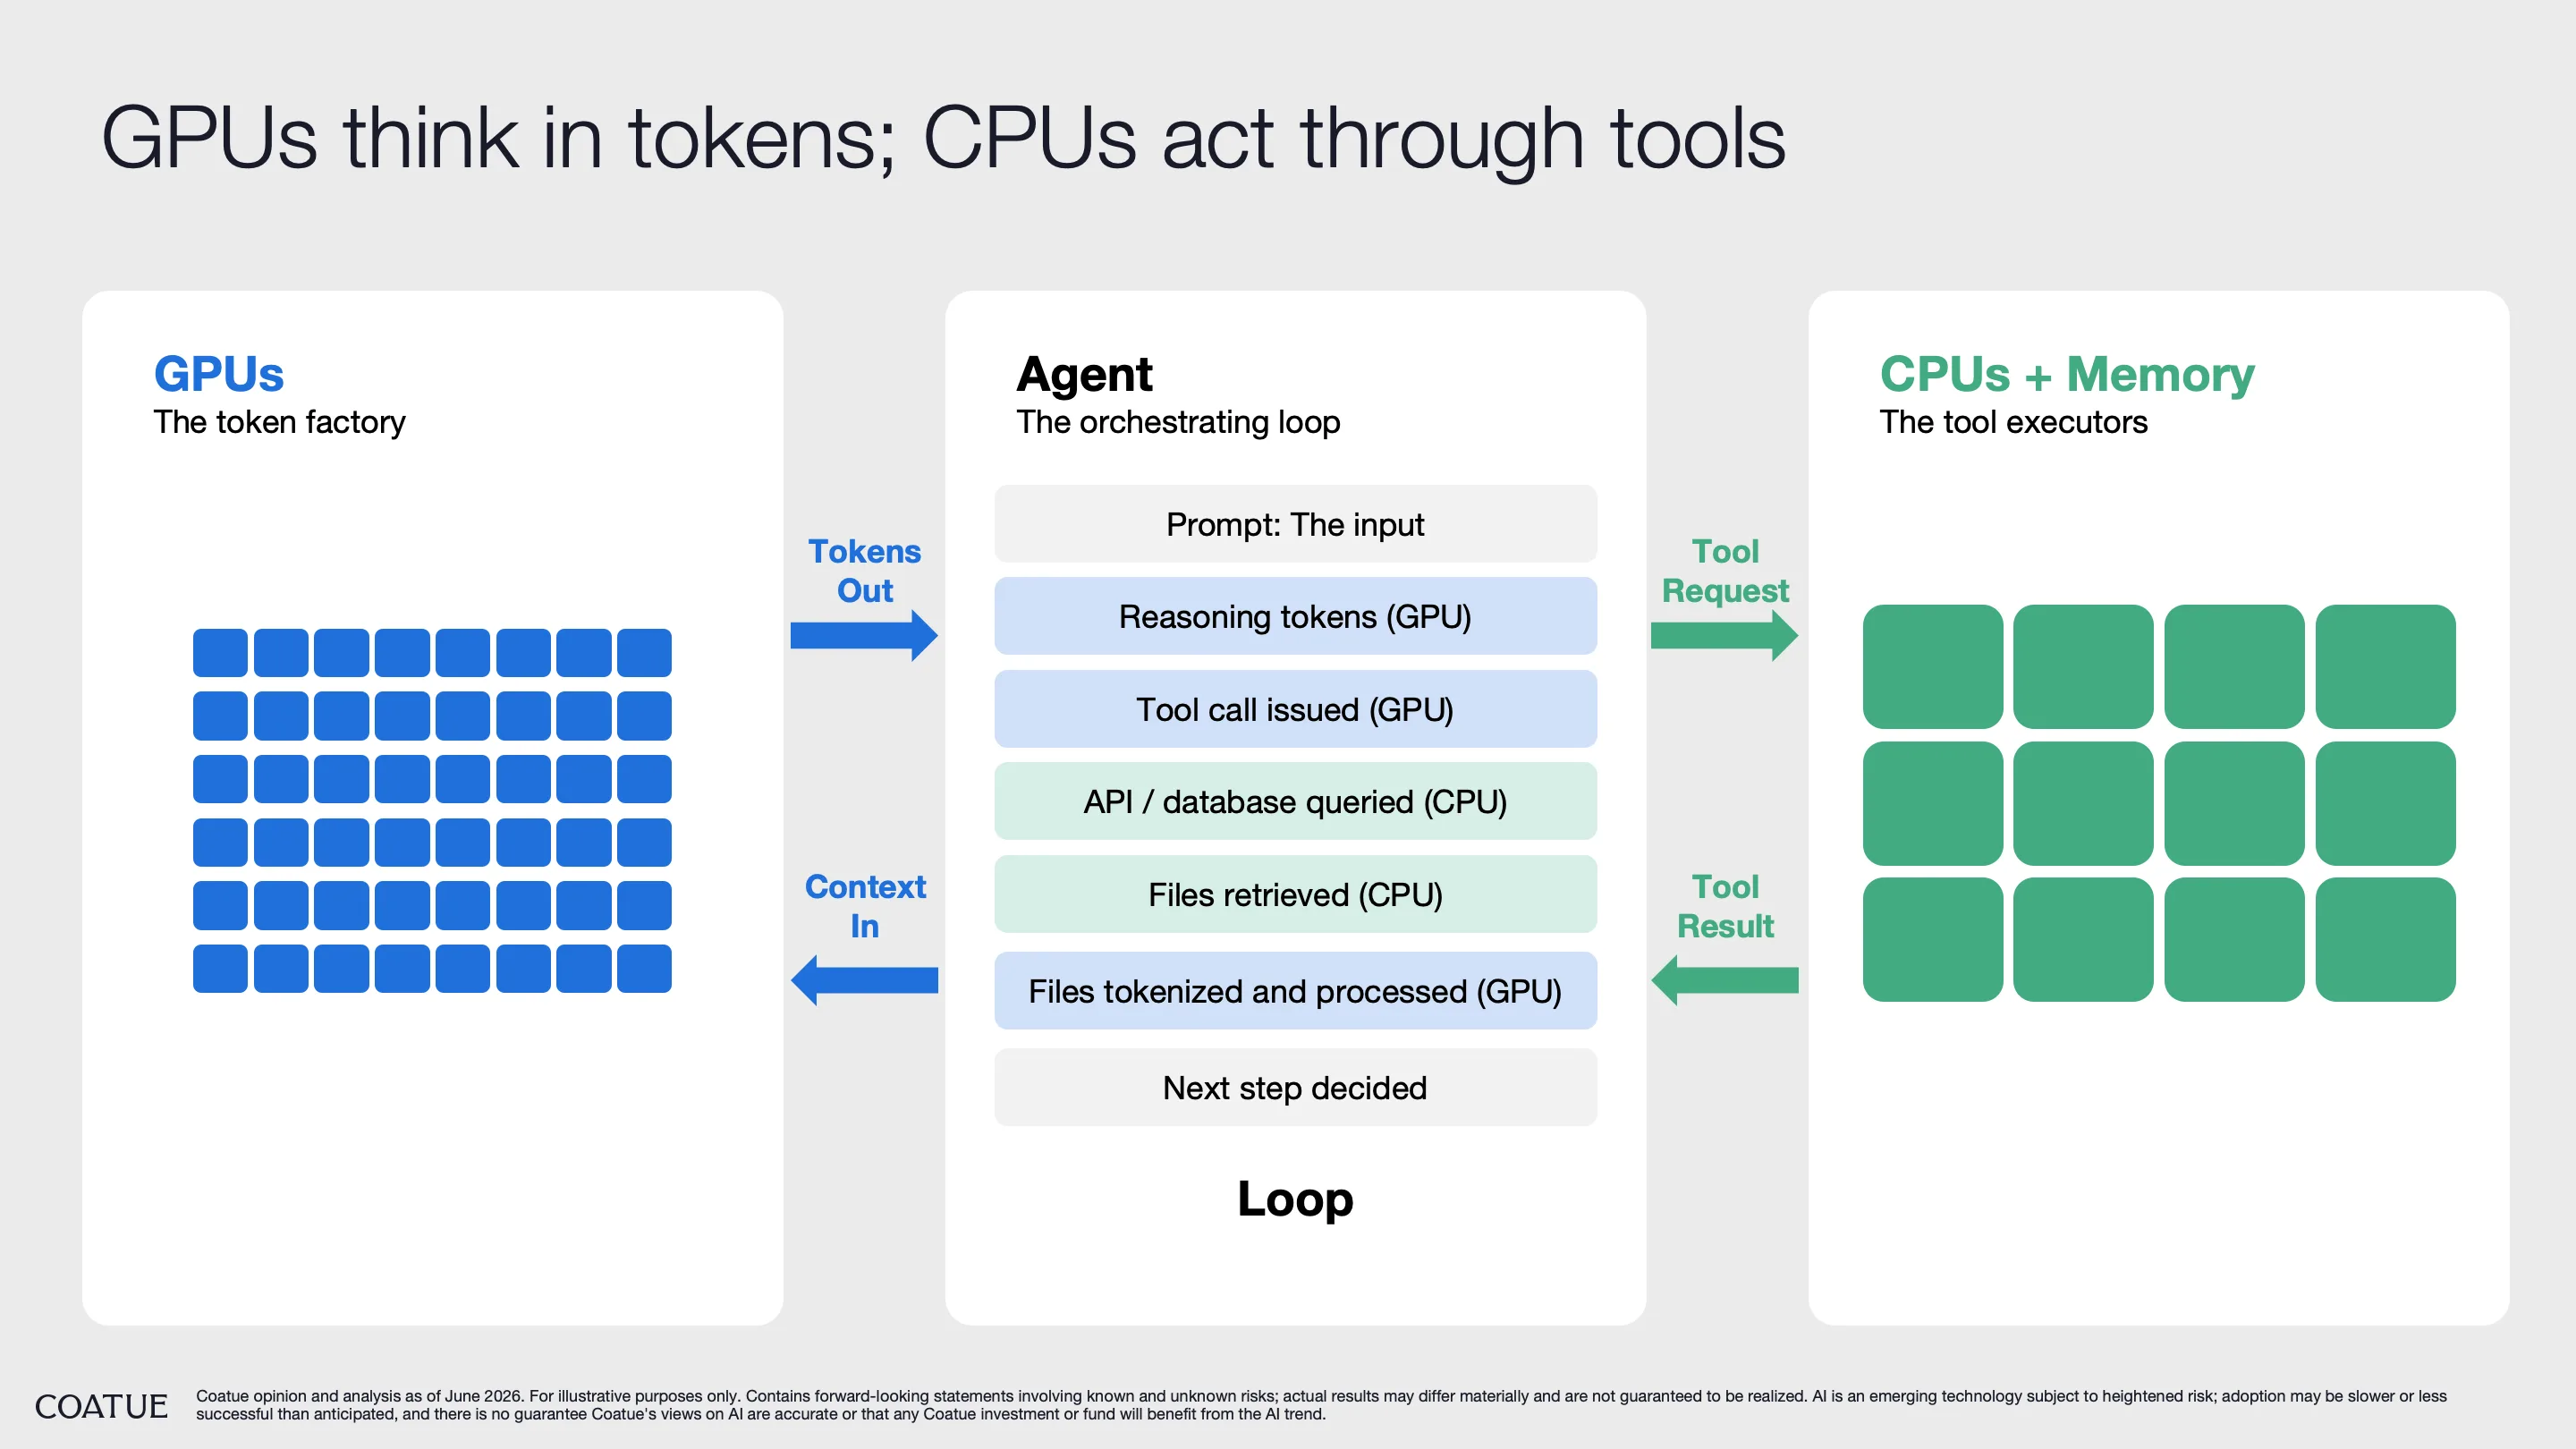
这些科技巨头是否应该为此感到担忧?它们的总市值高达数万亿美元……我绝不是说它们遇到了麻烦。不过它们显然很清楚,不能永远只充当“模型提供商”的角色。5 月时,OpenAI 和 Anthropic 都在旗下成立了价值数十亿美元的服务公司,利用自身的模型为企业客户处理实际业务,而不仅仅是提供模型访问服务而已。
此外,华盛顿方面还存在着持续的游说活动。这些科技企业一直在努力游说,以制定有利于自身的规则:2 月时,Anthropic 指责中国的开源模型向 Claude 发送数百万条提示语,以此来借鉴其功能。他们呼吁美国政府通过出口管制措施加以限制——这种政策立场无疑会对那些企业可能看中的开源替代方案造成不利影响。而这仅仅是他们近期游说行动中的诸多例子之一罢了。
不过,这些企业与政府的关系越密切,就越不得不遵循政府的规则。6 月时,美国商务部禁止外国公民使用 Anthropic 最先进的模型。同样,OpenAI 也主动将 GPT-5.6 的限制范围限定在少数获得政府批准的合作伙伴身上。尽管这些管控措施可能会发生变化,但政府施加限制的能力依然会改变客户的行为——你无法依赖那些可能随时被关闭的服务。而开源模型则不存在这样的问题。
开源方案中的交易权衡
出于我上述提到的原因,许多人会选择开源方案。不过,开源模型虽然能解决一部分问题,却也会带来诸多新的问题。
例如,8090 所声称的“16.4 倍成本差异”仅指推理成本。自建模型需要采购 GPU、配备 MLOps 工程师、进行推理优化,并且还要随着模型的发展持续进行维护。对于那些处理量巨大且任务明确的场景,自建模型确实更具优势:大量的处理量能够分摊自建模型的固定成本,任务性质较为单一,因此使用成本更低的专用模型即可;同时,可预测性也有助于保持高利用率,避免模型性能下降。但对于那些需求波动较大或属于探索性质的用途,按需租用前沿实验室的基础设施往往更为经济。
在这种背景下,“开源与封闭”这一问题的答案显然是“两者皆有”。正因如此,萨蒂亚所强调的编排层的重要性就显得尤为关键。问题不在于你偏好哪种模型,而在于针对不同任务应选择何种模型。由于各类模型提供商的成本结构与功能都在不断变化,因此编排层必须保持动态性——并且需要人工介入,以便根据具体情况判断应优化哪些方面(如成本、速度或性能)。
使用开源模型在本地进行部署虽然能够解决一部分安全问题,但同时也意味着企业需要自行承担其他形式的安全风险。开源模型的用户必须自行建立模型防护机制,并依赖自身的网络安全基础设施。而那些处于技术前沿的公司则会将所有这些功能作为产品的一部分一并提供。
最后,一个不容忽视的客观事实是,目前许多性能最出色的开源模型都来自中国。对于大多数商业应用而言,这并非问题,但在涉及国防、关键基础设施或政治敏感领域的应用中,模型的来源就显得非常重要。这类应用存在实实在在的监管风险,这也是为什么 Palantir 与 Nvidia 的合作会选择基于美国开源框架 Nemotron 的原因。
未来将呈现怎样的图景
要有效运行开源模型,还有一个关键因素:人才。大多数小型企业缺乏内部基础设施,无法自行搭建完整的开源架构。对他们而言,可行的方案是使用托管式开源模型服务——这种方式能够在无需承担庞大基础设施负担的情况下获得大部分数据控制优势,但需要支付更高费用,且又会重新产生对供应商的依赖。
不过,和普通消费者一样,大多数中小企业可能并不介意放弃自己的数据——使用封闭式模型在管理上更为省心,而且 Anthropic/OpenAI 大概也无意与这些小型企业直接竞争。
不过在企业层面,将开源模型纳入其人工智能战略中显然能带来诸多好处——尤其是那些拥有足够内部团队来优化成本结构的企业。
最后,那些拥有自身数据且不会依赖单一模型的应用层企业以及原生人工智能服务企业,将比竞争对手更具优势。