# AI

共 229 篇相关文章

AI 正在取代人们最喜欢的工作 AI
Apr 13, 2026

AI 正在取代人们最喜欢的工作

原文链接: AI is coming for the work people like the most 作者: Jay DiMonte 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 我们花了很多时间讨论 AI 取代工作。但我们几乎没有花时间去问它们是否是应该被取代的工作。 在自动交换机出现之前,有电话接线员,他们把电缆插进或拔出交换台,而主管则对他们去洗手间的时间进行计时。当技术赶上时,没有人为失去那项任务而哀悼。 这是自动化最好的应用:消除最乏味、最繁重和最枯燥的任务。 这是一个令人欣慰的承诺。但根据数据,正在发生的情况未必如此。 PayScale 对 500 多个职业的 270 万名工人进行了调查,问了两个问题: 你的工作让世界变得更好了吗? 你对你的工作满意吗? 大多数美国人回答“是”。 意义和满意度与工资仅呈轻度相关(r=.32,r=.42)。 神职人员(98%,90%)和外科医生(96%,83%)都位列工作成就感最高的人群之列。同时,前者赚 4.6 万美元,后者赚 36.5 万美元。 相比之下,同样位列最高薪酬之列(28.1 万美元)的航空公司飞行员,他们觉得自己的工作成就感(53%,74%)不如收入 3.8 万美元的个人护理和服务人员(83%,81%)。 还有许多低成就感的职业,比如停车场服务员(5%,41%),感觉类似于现代的接线员。这应该是我们重点自动化的工作吗? 2026 年 3 月,Anthropic 发布了《AI 对劳动力市场的影响》(Labor Market Impacts of AI),引入了“观察到的 AI 暴露度”(observed AI […]

推理市场将如何成熟 大模型内核
Apr 13, 2026

推理市场将如何成熟

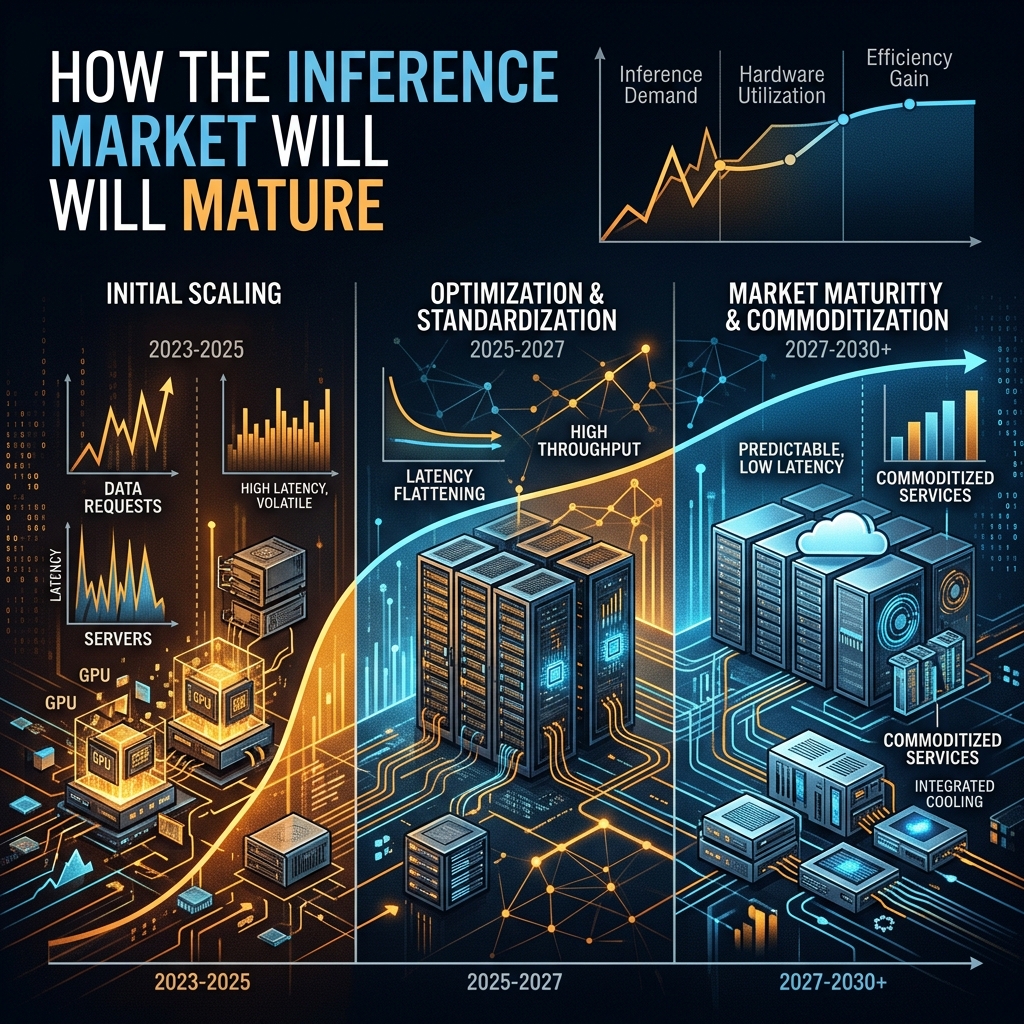
原文链接: How the Inference Market Will Mature 作者: Investing in AI 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 周日快乐,欢迎来到 Investing in AI。请务必收听我们的 AI in NYC 播客,以了解有关 AI 新闻和有趣的的应用 AI 初创公司的最新分析。此外,也请查看 Neurometric 新推出的“小模型市场”(Small Model Marketplace)。100 多个执行特定任务的模型——没有 token 成本,只需统一的月费。 今天我想问一个每位投资者都应该思考的重要问题: 如果推理成本趋于零,阿尔法(超额收益)在哪里? 这个问题目前正在每个专注于 AI 的基金中回荡。而这是一个错误的问题——因为它假设价格下降意味着市场萎缩。历史告诉我们恰恰相反。我们实际看到的是从“投机性建设”阶段(整个投资逻辑是“不惜一切代价购买 H100,然后再想办法”)向“效用效率”阶段的过渡,在后一个阶段,资金从押注最好的大脑转向押注最好的利润率。这是一个根本不同的游戏,而大多数投资者还没有更新他们的剧本。 这篇文章是我试图阐述推理市场如何成熟、防御性头寸在哪里,以及随着 AI 不再是一项科学实验而开始成为一种工业实用工具,资本应该流向何处。 在 19 世纪 60 年代,威廉·斯坦利·杰文斯观察到,随着蒸汽机变得更加省油,煤炭的总消耗量反而增加了。更便宜的能源并没有减少需求——它解锁了以前不经济的用例。同样的动态现在正在推理领域上演。 当推理很昂贵时,AI 是一个聊天机器人。它坐在文本框后面,等待人类输入一些东西,然后返回一个响应。那是一个工具。当推理实际上是免费的时候,AI 就会变成一个后台的自主智能体——持续地监控、决策、行动,而无需人类参与。那不是一个工具。那是一支劳动力队伍。 经济上可行的 AI 用例的表面积扩张速度快于价格下降的速度。推理成本每降低 10 倍,不仅仅是让现有的应用变得更便宜;它使全新类别的应用成为可能。想想物流优化对供应链中的每一个包裹进行推理,或者金融合规性实时检查每一笔交易,或者客户服务智能体不仅仅是回答工单,而是在客户注意到之前就主动解决问题。 对于投资者来说,这意味着问题不是“推理市场会萎缩吗?”而是“这个爆炸性市场的哪些细分领域将获得持久的利润率?”这才是真正分析的开始。 […]

前沿 AI —— 联合嵌入预测架构 大模型内核
Apr 13, 2026

前沿 AI —— 联合嵌入预测架构

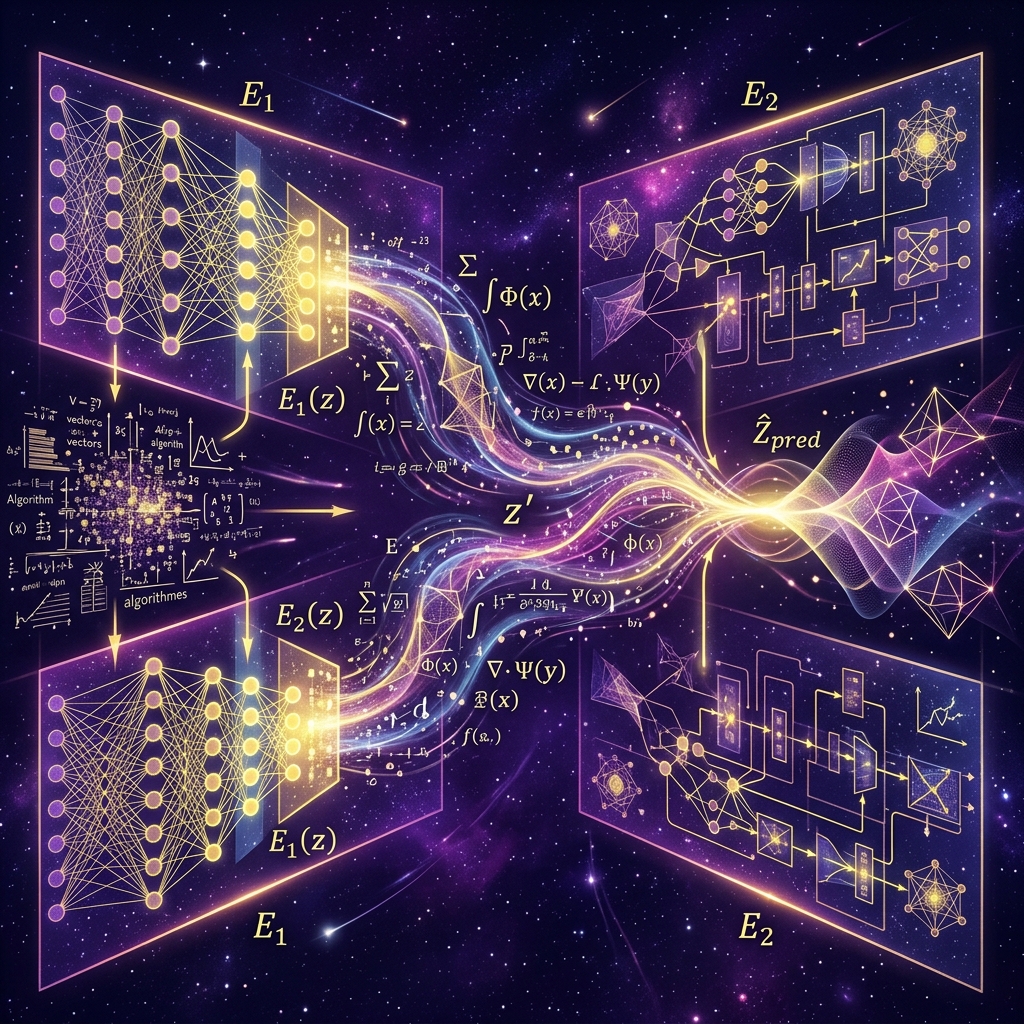
原文链接: Frontier AI — Joint Embedding Predictive Architecture 作者: Nkechi Iregbulem 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 人们要求我解释我在 AI 领域的投资逻辑的次数超出了我的预期。到目前为止,我一直故意保持模糊——将自己描述为机会主义者,在想法出现时支持它们。在实践中依然如此。但我认为有必要更精确地说明我到底在寻找什么。 我把它分成两类。第一类是软件的前沿应用——在那些历史上一直抗拒 AI 的领域中,AI 可以有意义地解锁或加速工作的地方。制造业、建筑业、科学、芯片设计。在这些地方,瓶颈是现实世界的复杂性,而不是计算能力。第二类是我所说的前沿 AI 本身——对可能代表模型构建方式真正阶跃函数变化的更怪异、更早期、更具投机性的想法下注。本质上就是“登月计划”。 JEPA(联合嵌入预测架构)牢牢地属于第二类。而且因为它已经成为一个日益增长的话题,我想值得写下来它到底是什么。 JEPA 是一种通过预测世界的抽象表示而不是重建原始数据来学习的模型架构。要理解为什么这种区别很重要,请花一秒钟想想你的母亲。 脑海中浮现的不是像素级完美的图像。不是她以无损音频呈现的声音。那是一些压缩的、抽象的东西——一种感觉、一种姿态、你的大脑几十年来积累并折叠成一个可检索想法的一组联想。你的大脑不存储原始片段。它存储意义。 大多数模型不是那样工作的。理解为什么——以及理解 JEPA 取而代之做了什么——需要稍微绕道了解一下模型实际上是如何学习的。 每一个现代生成模型都大致遵循相同的结构。 原始数据输入——像素、token、音频波形。编码器处理该数据并将其压缩为潜在表示(latent representation):一个捕获输入基本特征的密集数值向量。这是模型的内部语言。它是抽象的、高维的,存在于人眼无法看到的地方。 从那里开始,解码器接收该潜在表示并重建一些东西——图像、句子、预测。模型通过将其重建结果与原始输入进行比较来学习。预测错了一个稍微不一样的像素?调整。错了一个词?调整。误差信号通过网络向后流动,模型随着时间的推移在重建方面变得越来越好。 这就是循环:原始数据 → 编码器 → 潜在空间 → 解码器 → 重建 → 误差信号 → 重复。 它很有效。GPT、Claude、Gemini、Stable Diffusion——所有这些的核心都是在海量数据上训练的重建机器。学习来自于输出端的预测误差。 这种局限性很微妙但很重要。当模型被训练去重建原始数据时,它必须对所有东西进行建模——包括所有不携带任何语义意义的噪声、纹理和表面变化。预测缺失图像块的模型必须关心光照梯度和胶片颗粒,因为这些细节存在于重建目标中。模型无法区分信号和噪声,因为它会因为弄错任何一个而受到惩罚。 结果就是模型虽然有能力但效率低下——模型必须内化大量的表面细节才能对事物的含义形成有用的理解。 JEPA 代表联合嵌入预测架构 (Joint Embedding Predictive […]

新公司可以作为 MCP 来构建吗? AI
Apr 13, 2026

新公司可以作为 MCP 来构建吗?

原文链接: Can new companies be built as MCPs? 作者: Better Tomorrow Ventures 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 随着我将越来越多的时间和工作流通过 Cowork 路由,我发现自己开始要求我们的软件和 SaaS 提供商提供 MCP(如果他们还没有提供的话)。他们现有的仪表板是可观察的界面,但在他们的 MCP 和我的 Cowork 框架之间,我现在拥有了一个不断发展的可编程界面,我可以根据我的工作流需求对其进行定制,而无需放弃对我们技术栈中关键软件的依赖,也无需自己进行自定义数据编排(我知道这可能会让我很头疼)。在对基础模型蔓延的担忧中,我正实时观察到 Cowork 消耗了我越来越多的工作流注意力,同时也增加了我自己对现有软件栈的依赖(通过 MCP)。 例如,我们使用一款名为 Harmonic 的产品来获取丰富的人脉和网络数据。理论上,我可以在 LinkedIn 上构建一堆爬虫并拼凑出相同的信息,甚至让 Claude 尝试通过使用 Claude code 构建的各种脚本来做到这一点。但这需要时间,而且我们大可以付钱给 Harmonic,让他们来做获取、清理和结构化这些数据的苦力活。我很少访问 Harmonic 的仪表板,但有了他们的 MCP,这些丰富的上下文会直接流入我的 Cowork 框架中,这非常有用。 Concrete 也有类似的情况,这是一个投资组合管理工具,它会筛选我们的电子邮件以获取来自投资组合公司的更新,然后将所有内容打包成结构化的投资组合情报。他们的仪表板提供了观察整个投资组合洞察的价值,但通过 MCP 和 Cowork,我可以查询,例如:“投资组合公司 X 正在寻找哪些客户介绍,在更广泛的 BTV 网络中谁可以帮助促成?”。我的 Cowork 框架将通过 MCP […]

AI原生制造商的承诺 AI
Apr 13, 2026

AI原生制造商的承诺

原文链接: The Promise of the AI-Native Manufacturer 作者: Annelies Gamble 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 制造业中一些最重要的 AI 机会将来自围绕工作流本身构建的 AI 原生工业公司。在许多情况下,这些企业看起来可能不像传统的软件公司,而更像运营商:供应商、服务中心、制造商和物流企业,它们的优势来自于将智能直接嵌入到物理系统中。 在我的上一家公司,我们实际上就是在试图构建这个未来,但我们付出了大量的体力劳动。现在感觉不同的是,技术终于赶上了。我们可能正在达到这样一个临界点:构建产品本身并使用 AI 更好、更快、更智能地生产它,比仅仅向那些生产产品的人销售软件是一个更持久的模式。 本周我和 Nox Metals 的创始人 Zane Hengsperger 坐下来,探讨那个未来可能会是什么样子。Nox 是一家由 AI 驱动的金属供应商和现代金属服务中心。该公司介于钢厂和机加工车间之间,将金属切割成客户需要的尺寸,并正在构建软件来优化定价、库存选择、排料、调度和履行。归根结底,Nox 销售的是金属,但它利用 AI 在整个运营过程中驱动预测和优化。 “软件公司很重要,但垂直整合的工厂要重要十倍,”Zane 告诉我。 在制造业,以及更广泛的工业领域,有机会建立全新形式的产能。 制造业之所以成为 AI 的沃土,原因之一是该行业的大部分仍运行在碎片化的系统和手动工作流上。 制造业的核心是由一系列物理过程组成的。材料进来,零件出去。但两者之间的每一个过程都需要做出数千个决定,这些决定决定了一家工厂能否实现盈利性扩张。 这项工作需要多长时间?我们应该使用哪件库存?这张板材应该如何切割?我们应该报价多少?我们能保证这个交货时间吗?我们应该接这个订单还是拒绝?哪台机器应该运行什么,以什么顺序,以什么利润率,对剩余时间表的下游影响是什么? 这些决定驱动着吞吐量、良率、利用率和营运资金。 “你如何以最便宜的价格和最快的速度获得金属?你如何以最优惠的价格在 24 小时内为美国的每家工厂供应他们所需的任何金属?如果美国制造商要加快发展速度,他们就不能再为金属等那么久了。”Zane 说。“而且他们不能继续被多收费了。” 这关乎构建供应链基础设施,这是一组嵌入在实体业务内部的预测和优化问题。 一些价值最高的问题是预测问题:报价准确性、交货期预测、时间估算和需求预测。其他则是优化问题:排料、切割路径生成、调度、库存分配和作业排序。 “Nox 正在从我们在工厂车间做出的每一个决定中学习。某件事需要多长时间。我们决定如何切割一块金属。我们选择哪件库存。”这些学习对于 Nox 改善自身结果至关重要。 更准确的估算意味着更优的产能规划,这意味着接受更多的工作、更高的利用率、更低的空闲时间、更好的定价和更快的交付。“毕竟,产能决定了制造业的价格,”Zane 说。“如果你安排了一项四小时的工作,但实际上只需要三个小时,你就实际上失去了一个小时的产能。这可能意味着仅仅因为你的时间估算错误,就拒绝了其他工作或让机器闲置。” 如果你真正控制了这些预测和优化发生的流程,它们的收益才会复利。问题是如何做到。关于找到你的切入点——找到技术栈中狭窄但在经济上处于中心地位的一部分来拥有它的价值,已经有很多文章了。在制造业,这可能比几乎任何其他地方都更重要,因为正确的切入点让你控制了工作流本身。在我的上一家公司,我艰难地学到了这一点。 […]

已部署智能公司 AI
Apr 13, 2026

已部署智能公司

原文链接: The Deployed Intelligence Company (TDIC): Request for Builders 作者: nbobba 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 1. 优秀的团队构建新产品变得越来越容易,而各个领域也越来越挤满了同类的产品。 如果核心产品逐渐商品化,部署模式就会成为高杠杆的价值驱动因素。那些能够建立起理解客户工作系统并深思熟虑地将解决方案部署其中的制度化能力的公司将会蓬勃发展。@trybasis 很早就发现了对核心部署模式的需求,并围绕部署智能 (Deployed Intelligence) 设计了一个新的组织框架。 高接触(High-touch)的实施需要高价值客户,这意味着由风投支持的 AI 公司可能希望专注于企业级市场,并建立迎合企业需求的内部部署团队。这可能会导致中端市场和中小型企业(SMBs)在结构上得不到充分服务。他们能通过自助服务进入智能系统吗?我们认为不行。 我们认为这里有一家公司可以建立:一家介于供应端(AI 产品公司)和需求端(服务不足的中端市场及中小企业买家)之间的部署智能公司(deployed intelligence company)。它发现客户,映射他们工作流和数据的本体论,将一流的 AI 产品编排到他们的环境中,并持续管理这些部署。一家对部署结果负责、承担实施责任并与客户建立深厚关系的公司,在结构上拥有漫长的最后一英里。Aaron Levie 在这里简短地谈到了系统集成商的机会。 采用 AI 的瓶颈不在于能力。模型已经足够好了。瓶颈在于上下文和协调:分散在遗留系统中的碎片化数据、未记录的流程、老化的基础设施。部署智能公司可以通过定制的内部产品和以人为导向的工作,了解每个客户的运营现实并将智能部署其中,从而解决上下文问题。 每一次重大的技术浪潮都在部署端创造了庞大的业务。Salesforce 催生了埃森哲(Accenture)的云业务。ERP 创造了整个系统集成商生态系统。伟大的技术能力总是需要一种向经济长尾扩散的机制。 现在可能正是时候。基础模型公司已经开始进入部署阶段。OpenAI 和 Anthropic 正在向私募股权公司推销,以在其投资组合公司中部署 AI。用于捕获和操作企业知识/智能的工具层,如 Edra 和 Applied Compute 正在涌现。建立这家公司的基础设施今天已经存在,而 12 个月前并非如此,对于一个独立玩家在现有企业锁定该位置之前确立地位的窗口期并不是无限的。 切入点可以有多种形式。我们将私募股权(PE)投资组合公司视为一个引人注目的切入点,特别是在中低端市场,这些公司在运营上很成熟,但在技术上并不深入,并且收购后的 100 天计划创造了一个自然的干预时机。但还有其他的:寻求发展其服务模式的业务流程外包(BPO)公司、转向托管智能的托管服务提供商、拥有现有客户关系的特定行业渠道合作伙伴。合适的创始团队将对从哪里开始有敏锐的观点。 扩展模式是先窄而深,然后向外扩展。一个垂直领域,一些可重复的工作流,一个渠道。有一些有趣的扩展角度,比如特许经营模式,这与伟大的系统集成商的扩展方式没有太大不同,但从第一天起就是 AI 原生的。

AI要解决的最后一个问题是健康 AI + 生命科学
Apr 13, 2026

AI要解决的最后一个问题是健康

原文链接: The Last Problem For AI to Solve is Health 作者: NFX 免责声明: 本翻译仅供个人阅读和学习参考,不得用于任何商业用途或进行随意转载发布。 只有一种力量曾经永久性地提高了人类的生活水平并做大了经济蛋糕:科学和技术。 其他一切都是重新分配、债务周期或向未来借贷。唯有技术能做到不可能的事:它创造新事物,并让我们能够用更少的资源做更多的事。 想想这在历史上究竟意味着什么。几千年前,几乎每一个活着的人都把他们醒着的大部分时间花在生产食物上。今天,一小部分人口养活了比有史以来任何时候都多的人。而我们过去在田野里失去的时间已经被转化了。它们变成了医学、工程、艺术和休闲。 每一波有意义的技术浪潮都是这样运作的:它吸收了繁重的工作并创造了新的可能性。丰饶(Abundance)。那才是真正的魔法。 AI 也是同样模式的一部分。它让我们能够事半功倍,并具有创造丰饶的巨大潜力。在某些方面,它已经做到了:例如,它正在为每个人创造丰富的软件编码能力。但是,随着 AI 在许多领域(智能、软件)创造丰饶,它将使哪些领域严重缺乏丰饶变得非常明显。最大、最紧迫的领域是什么?健康。 在许多方面,健康和长寿的世界已经落后于创新曲线的其他部分。是的,我们取得了很大进展,但对大多数人来说,健康长寿还远未达到丰饶的程度。它仍然需要被解锁。 AI 的主要影响之一将是使健康和长寿成为经济中更大的部门。随着其他一切问题得到解决,剩下要解决的最大问题将越来越集中在生物/健康问题上。 这是一个宏大的想法,但以下是我的思考方式。 技术创造丰饶 技术的力量在于它使我们能够事半功倍——经济学家称之为生产力增长。这实际上不仅仅是从现有系统中榨取效率。它还解锁了以前无法想象的全新能力。结果就是,世界变得(大部分时候)更好了。 人们满怀深情地回顾过去。但凭心而论,过去是可怕的。下面的图表说明了真相。在预期寿命、生活水平和财富方面,几千年来基本没有任何变化——然后一切都爆发了。它始于工业革命,但在信息革命期间才真正腾飞。 创新的力量在于它随着时间的推移提高了生活水平。 为什么会发生这种情况?这是因为技术解锁的远不止简单的效率。把它想象成Mammoth Biosciences——一个用于识别和开发基于CRISPR的精准基因编辑的平台——因为我们相信这是一种总有一天会变得丰富的疗法。 这三种具备了可扩展性的模式代表了一些非凡的东西:实际消除许多缩短人类寿命的疾病。这些都是我们看到科学家们现在正在采取的非常真实的方向。 人才、资金和创新将涌向难题 软件和技术市场现在处于一种眩晕状态,因为随着他们可以支配的快速增长的智能,真的很难弄清楚什么值得去做。简单的问题正在被快速解决。 创始人和投资者担心软件和其他行业正在被去货币化。(但这不仅对消费者有利,而且很棒)。 随着经济的很大一部分被 AI“解决”,治愈疾病以及活得更长寿、更健康的问题将显得越来越重要。将有比以往任何时候都多的人才涌向生物学。它将成为新的前沿。寻求在创造财富的同时产生影响的人可以并且应该在那里测试他们的才能。 在某种程度上,这在 AI 领域已经发生了。如果你今天与大学生交谈,那些对技术感兴趣的人正在专注于“硬科技”——太空、基础设施、硬件和机器人技术。最有野心的人——我们作为投资者应该资助的人——总是寻找那些重大、困难、改变生活的问题。他们天生就被这些问题所吸引。 生物学今天是巨大的目标——但随着这些其他部门被“解决”,它在未来将变得更加巨大。 许多人已经认识到了这一点(我们正在资助他们!)。但我们相信很快会有更多的人意识到这一点。这只会变得显而易见。 借助 AI 理解生物学、分析数据、降低风险和加速发现的能力,真正的大规模解决方案正在成为可能。 我们想让健康变得丰饶 真正的财富是健康。而技术真正的魔法是丰饶。在接下来的十年里,我们作为一个社会所面临的最大问题是,如何用我们掌握的新工具让健康的生活变得丰富起来。 随着 AI 降低解决困难生物学问题的成本,大部分人类的生活水平可能会提高。过去曾经是高端的东西——高技能医疗保健、早期疾病检测、治愈性疗法——可能会变得越来越容易获得。 如果你像我们一样,相信健康的生活应该成为一种丰饶的常态,请与我们合作。

AI 应用与垂直整合 AI
Apr 13, 2026

AI 应用与垂直整合

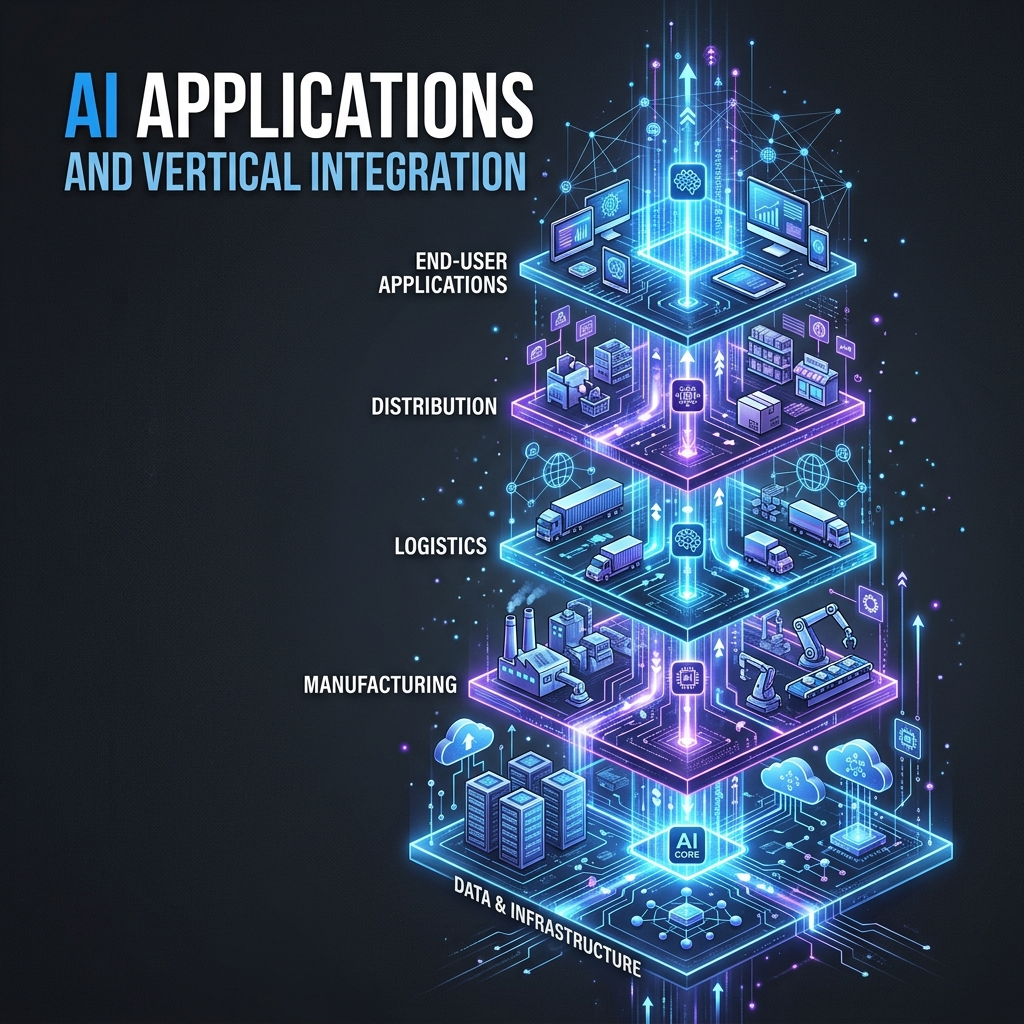
原文链接: AI Applications and Vertical Integration 作者: Tanay Jaipuria 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 两种“全栈式” AI 应用公司 我是 Tanay Jaipuria,Wing 的合伙人,这是一份关于科技行业商业的每周新闻通讯。 朋友们好, 我一直在思考一个我们越来越频繁地在 AI 应用公司中看到的模式。随着时间的推移,我认为它们中的大多数都会变成“全栈式(full-stack)”。 从高层次来看,您可以将实现结果的 AI 产品视为具有三个层级: 在底层,模型(model) 在中间,包含数据/上下文等的应用程序(application)或智能体(agent) 在顶层,为了实际获得结果而需要进行审查/提示/完成最后一英里的人工(human)或服务层(service layer) 这显然是一种描述世界的简化方式。模型建立在芯片等之上,在构建智能体时有很多基础设施、数据系统、编排和评估。但我仍然认为这种简化是有用的。 传统的应用层公司只会位于中间层。但这些公司正越来越多地开始(或从一开始就)在两个方向之一进行垂直整合。一些向下进入模型层。另一些则开始或向上进入人工或服务层。两者最终看起来都是“全栈式的 [^1]”,只是方式截然不同。 1. 向下全栈 (Full stack down) 第一种全栈版本是当应用公司向下整合进入模型层时。 这是我们在编程、客户服务和少数其他类别中看到的模式,在这些类别中,公司有足够的使用量、足够的专有轨迹数据(traces),以及足够的经济动力来开始将智能(intelligence)引入内部。 Cursor 是一个非常近期的例子。上周它推出了 Composer 2,将其定位为前沿级别的编程模型,其基准性能有了显著提高,并且价格低于许多替代方案。在其技术报告中,Cursor 表示 Composer 2 使用 Kimi K2.5 作为基础模型,然后通过持续预训练加上在长视距编程任务上的强化学习来扩展它。 Intercom 本周也采取了类似的举措,推出了 Fin Apex。Intercom 首席执行官 […]

从层级制走向智能 AI
Apr 13, 2026

从层级制走向智能

原文链接: From Hierarchy to Intelligence 作者: Sequoia Capital 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 在红杉资本(Sequoia),我们看到速度是预测初创企业成功与否的最佳指标。大多数公司将 AI 视为一种生产力提升工具。很少有公司关注 AI 改变我们协作方式的潜力。Block 正在展示从根本上重新思考组织设计是什么样子的,最终利用 AI 来提高速度,将其作为一种复合的竞争优势。 在第一张公司组织结构图出现的两千年前,罗马军队解决了一个每个大型组织至今仍面临的问题:如何在有限的通信条件下协调相隔遥远的数千人? 他们的答案是一个嵌套的层级结构,每一层都有统一的控制跨度。最小的单位是“同帐班(contubernium)”,由八名士兵组成,他们共享一个帐篷、装备和一头骡子,由一名“十夫长(decanus)”领导。十个同帐班组成一个八十人的“百人队(century)”,由一名“百夫长(centurion)”指挥。六个百人队组成一个“大队(cohort)”。十个大队组成一个大约 5000 人的“军团(legion)”。在每一层,一名被任命的指挥官拥有明确的权威,汇总来自下层的信息,并传达来自上层的决策。这种结构(8 → 80 → 480 → 5000)是一个围绕一个简单的人类限制而建立的信息路由协议:一个领导者可以有效地管理三到八个人。罗马人通过几个世纪的战争发现了这一点。即使在今天,美国陆军的等级链也遵循类似的模式。我们现在称之为“控制跨度(span of control)”,它仍然是地球上每个大型组织的治理约束。 下一个重大变化来自普鲁士。1806 年拿破仑军队在耶拿战役中摧毁了普鲁士军队后,由沙恩霍斯特(Scharnhorst)和格奈森瑙(Gneisenau)领导的一群改革者围绕一个令人不安的真相重建了军队:你不能依赖顶层的个人天才。你需要一个系统。他们创建了总参谋部,这是一个受过训练的军官阶层,他们的工作不是战斗,而是规划行动、处理信息并在各单位之间进行协调。沙恩霍斯特打算让这些参谋军官“支持无能的将军,提供领导者和指挥官可能缺乏的才能。”这就是“中层管理”,甚至在出现这个词之前。他们的目的是在复杂的组织中路由信息、预先计算决策并保持一致性。军方还正式区分了“直线(line)”和“参谋(staff)”职能。直线部门推进核心任务。参谋部门提供专业支持。今天,每家公司仍在使用这套词汇。 军事层级结构在 1840 年代和 1850 年代通过美国铁路进入商业世界。美国陆军将西点军校培养的工程师借给私营铁路公司,这些军官带来了军事组织思维。参谋和直线层级结构、部门结构、官僚的报告和控制系统:所有这些都是在军方发展起来的,然后才被铁路采用。在 1850 年代中期,纽约和伊利铁路公司(New York and Erie Railroad)的丹尼尔·麦卡勒姆(Daniel McCallum)创建了世界上第一张组织结构图,以管理一个绵延 500 多英里、拥有数千名工人的系统。适用于较小铁路的非正式管理方式正在失效。火车相撞正在导致人员死亡。麦卡勒姆的图表将罗马人使用过的相同层级逻辑正式化:权力层级、定义的报告路线、结构化的信息流。它成为了现代公司的蓝图。 弗雷德里克·泰勒(Frederick Taylor,1856-1915),常被称为“科学管理之父”,优化了该层级结构内发生的事情。泰勒将工作分解为专业任务,将它们分配给受过训练的专家,并通过衡量而不是直觉进行管理。这产生了职能金字塔组织——一种在军方开创、铁路商业化的信息路由系统内为效率而优化的结构。 对职能层级结构的第一次真正压力测试发生在第二次世界大战期间。曼哈顿计划要求物理学家、化学家、工程师、冶金学家和军官在极端保密和时间压力下,跨越学科界限,朝着一个单一目标努力。罗伯特·奥本海默(Robert Oppenheimer)将洛斯阿拉莫斯(Los Alamos)组织成职能部门,但坚持在部门之间进行公开协作,抵制了军方划分界限的本能。当 1944 年内爆问题变得严重时,他围绕这个问题重组了实验室,创建了当时美国企业界前所未有的跨职能团队。它奏效了,但这是由一位杰出人物领导的战时特例。战后商业世界面临的问题是,这种跨职能协调能否成为常态。 随着二战后公司的成长和全球化,职能设计的规模限制变得严重。1959 年,麦肯锡的吉尔伯特·克利(Gilbert […]

如何用 AI 构建营销归因报告 AI
Apr 13, 2026

如何用 AI 构建营销归因报告

原文链接: How to Build a Marketing Attribution Report with AI 作者: Stage 2 Capital 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 使用 Claude + HubSpot 进行的 10 分钟实操,以及为想要了解全貌的团队准备的周末开发项目。 初级实操:如何使用 Claude + HubSpot(或你的 CRM)在 10 分钟内构建营销归因报告 营销归因(Marketing attribution)一直是每个人都想要但却很难生成的东西。你了解这种对话——“我们需要了解是什么在驱动销售管道(pipeline)”——但这可能需要几周的时间来提取、清理和分析数据,才能得到一个方向上正确的答案。 关键在于:如果你的数据在 HubSpot(或任何与 Claude 有连接器的 CRM)中,你今天就可以获得一份有效的归因报告,告诉你哪些营销活动实际上与成单收入相关。 在你开始之前 启用了 HubSpot 连接器的 Claude 帐户(这是关键——没有连接器,Claude 无法读取你的数据)。如果你使用的是不同的 CRM,只需确保它也连接到了你的 Claude 帐户,并遵循相同的说明)。 具有已成单/赢得(closed/won)交易数据以及至少跟踪了联系人部分营销活动的 HubSpot 访问权限 你想要分析的时间窗口的大致概念(过去 6-9 个月是一个很好的起点) 交易应关联有联系人——Claude 读取的是联系人级别的属性,而不仅仅是交易记录 […]

AI 原生服务打法手册 AI
Apr 13, 2026

AI 原生服务打法手册

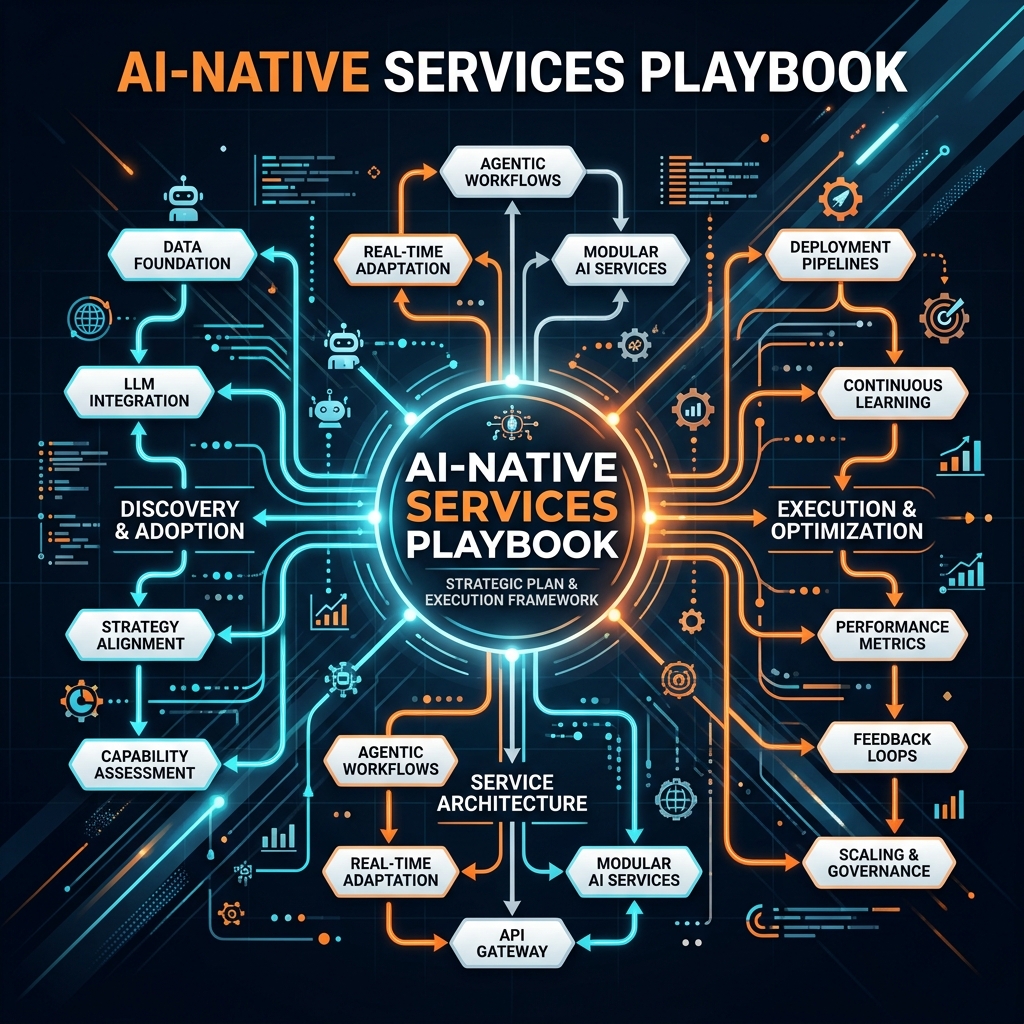
原文链接: The AI-Native Services Playbook 作者: Emergence Capital 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 ##### 2026 年春季版 在 Emergence,我们相信 AI 原生服务(AI-Native Services,简称 AINS)将成为 AI 时代的定义性商业模式(在这里阅读原因)。但目前还没有针对它的剧本(playbook)。直到 2023 年,销售主要由 AI 驱动的服务这个想法才成为可能。在这个领域进行建设的创始人正在边做边摸索这种新商业模式的基础元素。 我们的目标是成为这种新兴商业模式最勤奋的学生。我们正在与该类别的早期先驱者(无论是在我们的投资组合内还是外部)合作,记录关于如何建设的经验教训。其中许多教训看起来与如何建立一家成功的软件公司截然不同。有些是违反直觉的。所有这些都还在不断演变中。 本剧本是为正在建立(或考虑建立)AI 原生服务公司的创始人和运营者准备的。我们将每六个月更新一次,以捕捉 AINS 建设的最新动态。如果你正在这里进行建设并有经验教训可以分享,我们希望听到你的声音。 I. 团队 (Team) 领域专业知识(Domain expertise)是必须具备的。 在传统的 SaaS 中,你销售的是产品。在 AI 原生服务中,你销售的是你自己。领域的信誉不仅重要;它事关生死存亡。 早期客户需要相信你交付结果的能力,而建立的信誉对建立这种信任大有帮助。他们通过提供服务的人员/团队的声誉或感知的信誉和专业知识来评估服务。过去的表现是未来表现的可靠预测指标。 行业经验对面向客户的团队成员尤其有帮助; 因为这很大程度上关乎信任。你希望买家认可你团队工作过的地方,理想情况下是来自传统服务提供商的受信任品牌。 这种领域专业知识不必来自联合创始人;它可以随着你在早期建立团队而出现。 Mechanical Orchard: 首席执行官 Rob Mee(曾管理 Pivotal)带来了企业买家的即时信誉以及访问 Pivotal Labs 人才网络的渠道。 Harper 和 […]

生成式 AI 的经济学:两年之后 大模型内核
Apr 13, 2026

生成式 AI 的经济学:两年之后

原文链接: The Economics of Generative AI: Two Years Later 作者: Apoorv Agrawal 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 半导体是一个人的游戏。应用程序是两个人的游戏。基础设施是唯一具有竞争力的层级。 我很高兴能更新我 2024 年的初步分析:生成式 AI 的经济学 (The Economics of Generative AI)。这是我回顾得最多的一篇分析文章,因为它提醒着我 AI 行业的“物理学”。 两年前,我发现生成式 AI 的价值链是倒置的:计算层占据了约 83% 的总收入和约 87% 的总毛利。应用层尽管最接近最终客户,却几乎赚不到钱。我预测这种情况会随着时间的推移而逆转,遵循每一次先前平台转移的模式。两年前,我说过: 两年过去了,AI 生态系统增长了大约 5 倍,年化收入从约 900 亿美元增长到约 4350 亿美元。但引人注目的是,经济学的形态几乎没有发生变化。 先说底线:半导体是一个人的游戏。应用程序是两个人的游戏。基础设施是唯一具有竞争力的层级。AI 领域最赚钱的策略仍然是“卖铲子”。:) 让我们深入探讨! #1 价值链依然是倒置的 以下是每个层级的细分情况: 半导体(约 3000 亿美元): 这绝大部分是英伟达(NVIDIA)。他们的数据中心业务上个季度营收 620 亿美元,年化收入约为 2500 […]