 算力基建
内存三巨头 | Wing Venture Capital
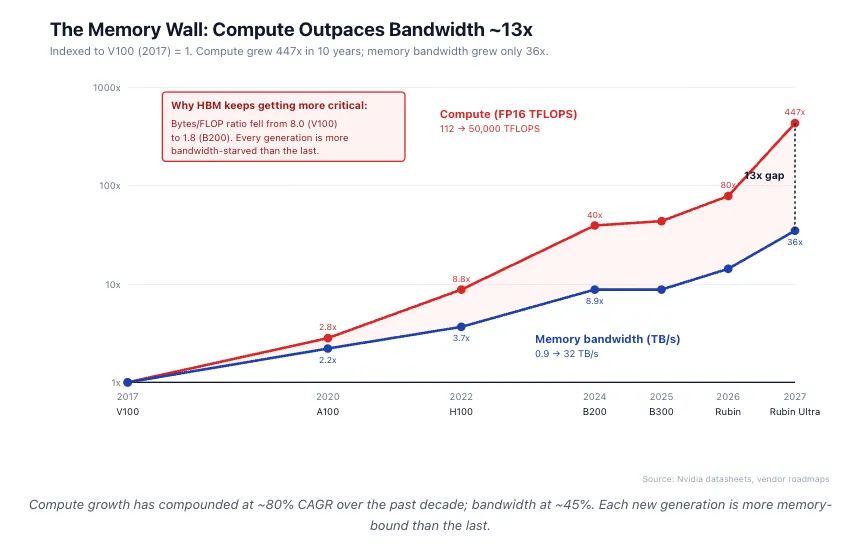
SK海力士、三星和美光如何成为AI领域最集中的控制节点——以及为何HBM占每块英伟达GPU销售成本的50%以上。 来源: https://www.wing.vc/content/the-memory-triopoly 观点 我们最近一直在谈论内存——从跨Prefill和Decode阶段的KV Cache动态,到内存本身作为AI计算的结构性瓶颈。约束条件不再是原始FLOPS。而是能否足够快地将字节移入和移出这些FLOPS,以保持日益庞大的模型得到持续供给。 三家公司——SK海力士、三星和美光——掌控着这个瓶颈。它们控制着约96%的DRAM市场,以及实际上100%的高带宽内存(HBM)。HBM现在是英伟达加速器内部最具经济关键性的单一组件,占Blackwell Ultra(B300)物料清单的50%以上,并且在Rubin平台上占比更高。 在HBM经济周期的顶峰,SK海力士的盈利能力开始超过像Meta这样购买其产品的超大规模企业。综合来看,内存三巨头在2026年的预计净利润将是Meta的2-3倍。 计算能力增长快于内存 每一代英伟达产品都遇到了同样的障碍:内存。在11年间,每块GPU的内存容量从P100到Rubin Ultra增长了约18倍。同期,FP计算能力增长了约500倍。 其结构性含义是:每一代AI产品都变得更加受带宽限制。内存已从GPU BOM(A100)的约20%上升到约55%(B200)。对于Rubin,HBM的成本可能超过逻辑芯片本身。我们正开始接近在处理器上放置HBM的物理极限。GPU的 shoreline 由芯片周长决定,而HBM堆叠只能沿着四个边缘中的两个放置——这就是为什么Rubin Ultra通过增加高度而非宽度来扩展到16个堆叠。 HBM物料清单与利润捕获 一块B200有8个HBM3E堆叠,每个24 GB(总共192 GB)。HBM在B200 GPU BOM中的占比约为52%,在B300(Blackwell Ultra,288 GB HBM3E 12-Hi)中约为58%,根据早期ASP指引,在Rubin(HBM4)中预计约为62%。 英伟达B200的标价在30,000至40,000美元之间。每增加一美元B200收入,大约有0.10至0.15美元作为毛利润贡献流向HBM供应商。SK海力士捕获其中的约45-50%。三星约30%。美光约22%。 内存供应商现在与英伟达的收入轨迹紧密相连,其紧密程度可能超过了现代半导体历史上任何供应商-客户关系。 每GB成本:残酷的层级结构 内存不是一个单一市场。它是一个分层的堆叠,成本差异高达六个数量级。 HBM3E每GB成本约为DDR5的6倍,但每个堆叠的带宽是其25倍。在每(GB·带宽)成本的基础上,对于超过一定计算密度的AI工作负载,HBM是唯一经济合理的选择。 SRAM每GB的成本比HBM高出两到三个数量级。而且SRAM的扩展已经停滞。从台积电N7到N5,SRAM密度仅提升了5%。从N5到N3,提升再次不到5%。历史上关于片上缓存能与逻辑性能同步提升的假设已经失败。 这就是SRAM扩展的悬崖。任何依赖大型片上缓存的AI架构(如Cerebras、Groq风格的方法)都面临着日益严峻的成本曲线。HBM仍然是唯一结合了大容量、高带宽和可接受成本的内存技术。 内存墙,量化分析 AI的核心架构问题不再是计算稀缺。而是内存饥渴。 AI工作负载受三个物理约束限制,而非FLOPS: 现代GPU每字节所需的计算量远高于Transformer工作负载自然产生的计算量。每个GPU都有一个平衡点——即每获取一字节内存可以执行多少次数学运算。对于V100(2017年),平衡点约为每字节125 FLOPS。对于今天的B200,约为每字节560 FLOPS。要让GPU满负荷运行,软件需要对其接触的每个字节执行那么多次运算。Transformer解码工作负载远低于这个阈值。典型的解码工作负载每获取一字节仅执行1-10次运算——它们大部分时间都在等待内存。结果是:AI芯片在推理过程中通常只能达到峰值FLOPS的15-35%。每增加1 TB/s的HBM带宽,都会直接转化为利用率恢复和更低的每Token成本。 KV缓存现在主导着推理内存。在推理过程中,每个先前Token的“键”和“值”表示必须保留在内存中,以便下一个Token可以关注它们。这就是KV缓存,它随着上下文长度×批次大小而增长。在128K上下文、批次大小为32的情况下,Llama 3 70B仅KV缓存就需要约80 GB——比模型权重本身还多。在1M上下文时,每个请求的KV缓存超过600 GB。这就是为什么H200的141 GB和B200的192 GB相对于H100的80 GB是一个阶跃变化:不是因为权重变大了,而是因为缓存变大了。 移动数据比计算数据消耗更多能量。通过HBM移动一个比特大约需要7皮焦耳。通过封装外的DDR5:80皮焦耳。来自片上SRAM:0.1皮焦耳。在4纳米节点上执行一次8位乘法:0.05皮焦耳。在万亿次运算规模的推理中,数据移动的能量消耗超过计算能量的3-10倍。这就是为什么每一种架构响应——带有逻辑基础芯片的HBM4、堆叠SRAM、存内处理——从根本上都是为了减少每移动一字节所消耗的焦耳数。 经济层面的转化:HBM带宽是AI基础设施中杠杆率最高的资本支出决策。对于现代Transformer工作负载,额外HBM带宽的边际价值通常超过其边际成本。 HBM堆叠究竟是什么 来源:高带宽内存,Semi Engineering 高带宽内存,Semi […]