 大模型内核
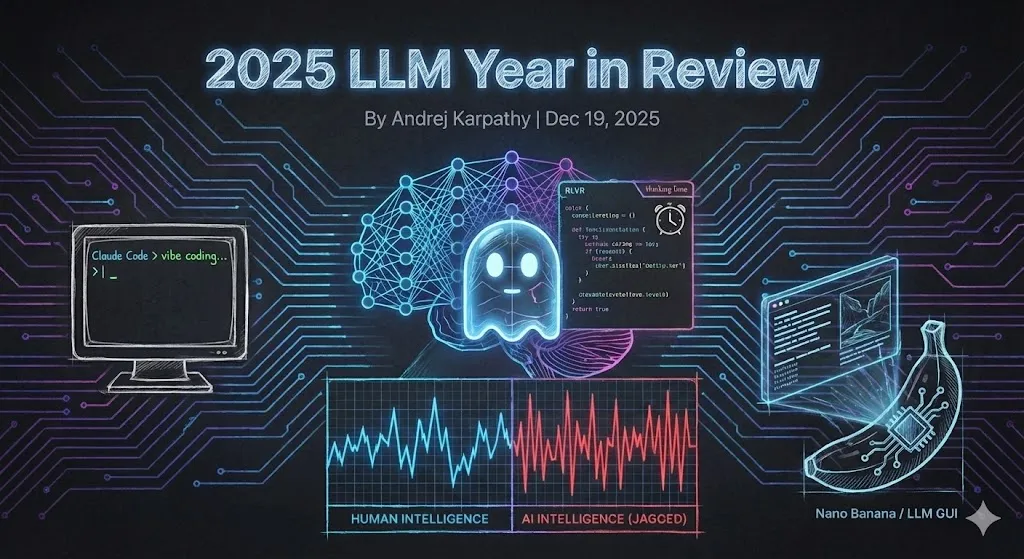
2025 LLM 年度回顾
[videopress nYd8ElIc] 本文信息来源:bearblog.dev 2025 年是 LLMs 取得重大且充满事件性进展的一年。以下是一份我个人认为值得注意且略感意外的“范式转变”清单——这些变化改变了整体格局,并在概念层面给我留下了深刻印象。 1. 来自可验证奖励的强化学习(RLVR) 在 2025 年初,所有实验室中的 LLM 生产技术栈大致如下: 预训练(约 2020 年的 GPT-2/3) 监督微调(InstructGPT,约 2022 年)以及 来自人类反馈的强化学习(RLHF ~2022) 这曾在一段时间内是训练生产级 LLM 的稳定且经过验证的食谱。到 2025 年,来自可验证奖励的强化学习(RLVR)成为加入这一组合中的事实上的新主要阶段。通过在多个环境中(例如数学/代码谜题)针对可自动验证的奖励来训练 LLM,LLMs 会自发地发展出在人类看来像是在“推理”的策略——它们学会将问题解决分解为中间计算,并学习多种来回推敲以弄清问题的解题策略(示例可参考 DeepSeek R1 paper)。在以往的范式中,这些策略很难实现,因为并不清楚对于 LLM 而言最优的推理轨迹和恢复方式应当是什么样子——它必须通过针对奖励进行优化,自己找到对其有效的方法。 与 SFT 和 RLHF 阶段不同,后者都是相对较薄/较短的阶段(在计算上只是轻量的微调),RLVR 涉及针对客观(不可被博弈化)的奖励函数进行训练,这使得可以进行更长时间的优化。实践表明,运行 RLVR 具有很高的能力/美元性价比,这吞噬了原本计划用于预训练的算力。因此,2025 年的大部分能力进展,都是由 LLM 实验室消化这一新阶段的算力积压所定义的;总体来看,我们看到的是规模大致相近的 LLM,但伴随着更长时间的 RL 训练。这个新阶段还带来了一个独特之处:我们获得了一个全新的旋钮(及其相关的尺度律),可以通过在测试时生成更长的推理轨迹、增加“思考时间”,来将能力作为测试时算力的函数加以控制。OpenAI o1(2024 年末)是第一个展示 RLVR 模型的例子,但 o3 的发布(2025 […]