大模型内核

深入洞察市场脉搏,精选高价值分析报告

生成式 AI 的经济学:两年之后 大模型内核
Apr 13, 2026

生成式 AI 的经济学:两年之后

原文链接: The Economics of Generative AI: Two Years Later 作者: Apoorv Agrawal 免责声明: 本翻译好的文章仅限于我自己阅读,不是转载和发布。 半导体是一个人的游戏。应用程序是两个人的游戏。基础设施是唯一具有竞争力的层级。 我很高兴能更新我 2024 年的初步分析:生成式 AI 的经济学 (The Economics of Generative AI)。这是我回顾得最多的一篇分析文章,因为它提醒着我 AI 行业的“物理学”。 两年前,我发现生成式 AI 的价值链是倒置的:计算层占据了约 83% 的总收入和约 87% 的总毛利。应用层尽管最接近最终客户,却几乎赚不到钱。我预测这种情况会随着时间的推移而逆转,遵循每一次先前平台转移的模式。两年前,我说过: 两年过去了,AI 生态系统增长了大约 5 倍,年化收入从约 900 亿美元增长到约 4350 亿美元。但引人注目的是,经济学的形态几乎没有发生变化。 先说底线:半导体是一个人的游戏。应用程序是两个人的游戏。基础设施是唯一具有竞争力的层级。AI 领域最赚钱的策略仍然是“卖铲子”。:) 让我们深入探讨! #1 价值链依然是倒置的 以下是每个层级的细分情况: 半导体(约 3000 亿美元): 这绝大部分是英伟达(NVIDIA)。他们的数据中心业务上个季度营收 620 亿美元,年化收入约为 2500 […]

心灵自行车 – Rex Woodbury – Digital Native 大模型内核
Mar 30, 2026

心灵自行车 – Rex Woodbury – Digital Native

每周撰写有关技术与人如何交叉的文章。白天,我正在构建 Daybreak 来与早期创始人合作。晚上,我正在撰写有关市场趋势和创业机会的 Digital Native。 如果您还没有,请在此处,加入每周 70,000 多名读者的行列: 大家好👋, 我们正在黎明招聘! 我们正在寻找一名 EA/办公室经理来维持公司的列车运行。 这是 LinkedIn 上的招聘信息。如果您有兴趣或有任何线索,请告诉我或让他们填写 LinkedIn 申请表。这个角色没有“合适”的背景,但我们正在寻找两个主要的东西:(1) 一个善于交际的人,因为这个角色意味着成为 Daybreak 的代言人并与我们的创始人和有限合伙人互动,以及 (2) 一个能够完成工作而不出错的执行机器。我们将提供有竞争力的现金补偿以及结转资金。另外,你会和我和贾里德一起工作,我们觉得在一起很有趣:) 话不多说,继续本周的文章…… 心灵自行车 史蒂夫·乔布斯因称个人电脑为思维自行车而闻名。 这句话通常与 80 年代中期 Macintosh 的推出联系在一起,但有证据表明乔布斯早在 1980 年就使用了这个比喻,当时苹果公司才只有三年。这个比喻很好:显然,计算机一直是增强人类智力和好奇心的工具。 ![观看史蒂夫·乔布斯首次向公众展示 Macintosh | The Verge] 人工智能是比喻的自然进化。人工智能可以帮助您的思维更快、更远;很少有人会不同意这一点。但人工智能是利用“其他人”的智力来做到这一点的。克劳德是我最好的新朋友——没有克劳德,黎明几乎无法运作——但克劳德不是我。我认为克劳德是一位高效的员工,而不是我自己。从你的自己的头脑中获得更多里程怎么样?这是乔布斯比喻的更字面的解释:你如何才能为自己特定的、个人的、独特的头脑获得一辆自行车? 数字克隆,也称为数字孪生,是人工智能领域最伟大的想法之一。我们如何复制一个人的智力、意识、知觉?最后一个词是我们 Daybreak 公司之一的名称。 Sentience 今天秘密 出现。 Sentience 构建了您的数字版本,它可以理解您的知识、反映您的声音并可以根据您的环境进行操作。 ChatGPT 和 Claude 是令人难以置信的工具,但它们是在海量通用数据集上进行训练的。它们针对统计上可能的响应进行了优化,这意味着随着时间的推移,输出会趋同,情报会越来越集中在少数平台中。 相比之下,感知创建了一个个人模型,随着时间的推移,个人塑造并拥有这个模型。你成为你自己的模型,你的知觉对你来说变得独特。 我如何使用感知 过去几个月我一直在使用 Sentience,它已成为我运作方式的核心。该产品的工作原理是首先摄取数据:我导入了我的电子邮件、日历历史记录、Slack 线程、笔记和 […]

大模型内核
Mar 30, 2026

盒装业务的兴起 – 作者:David Talpalar

我之前曾提到过,自新冠疫情以来,小型企业应用程序的数量激增,这是多种因素共同作用的结果,其中包括对自治的渴望增加和劳动力市场动态。但这一演变的最关键组成部分之一是,成功启动和建立小型企业所需的基础设施工具从未如此容易获得。社交媒体降低了直接接触消费者的障碍。 Zoom 等远程工具、Replit 等网站构建器以及 Ramp 等财务工具有助于抽象出小企业主在前几代中必须应对的许多后台任务。 然而,在过去几年中,我们看到了一种更加全面的基础设施工具的兴起,它使专业人士能够独立开展工作:即插即用业务。一体化业务公司创建全栈支持套件,消除了运营独立业务的运营复杂性,使熟练的专业人员能够专注于他们接受过培训的高价值工作。 至少从我的角度来看,最初的“盒中业务”是 Shopify:Shopify 的创立故事是“盒中业务”概念的有力示例。 Tobi Lutke、Daniel Weinand 和 Scott Lake 最初于 2004 年推出了 Snowdevil,这是一家在线滑雪板商店。他们在与运营电子商务网站相关的运营任务上花费了大量时间,以至于他们意识到构建电子商务平台运行的基础设施有更大的机会。 Shopify 正是基于这种洞察力于 2006 年诞生。 Shopify 成为电子商务品牌的一体化业务平台,特别是在生产商品的小型企业中取得了最大的成功。但新一波的一体化业务公司正在为提供服务的小型企业打造——特别是在监管严格的领域,中小企业所有者不仅必须在所提供的核心服务上证明其卓越性,而且还必须在这些领域中证明自己的卓越性。他们还必须掌握后台、监管和合规性的运营复杂性。 为什么一体式业务公司存在 一体化业务背后的基本见解是,运营复杂性是专业独立性的主要障碍,而不是技能、需求和资本。在大多数获得许可的职业中,供需动态都非常有利于独立从业者。私人诊所的心理健康治疗师的收入是受薪员工的两到三倍。专业执业领域的单独律师的收费标准通常远远超过其受雇薪酬。 但只有当中小企业运营顺利时,其经济效益才具有吸引力。考虑一下想要在私人诊所接受保险的治疗师。他们需要分别对每个付款人进行认证——每个小组需要三到六个月的时间,涉及三十多页的申请,并且需要不断地重新认证。他们需要学习 CPT 编码、索赔提交、拒绝管理和事先授权工作流程。他们需要 HIPAA 合规基础设施、医疗事故保险、调度系统、计费系统以及寻找患者的方法。这些都与成为一名优秀的治疗师无关。 结果,那些本来可以为自己、客户和更广泛的系统创造更多价值的才华横溢的专业人士,作为独立从业者,却被转移到机构就业,他们的收入更少,自主权也更少,而且在许多记录在案的案例中,由于雇主强加的官僚管理费用,他们提供的护理质量较低。 对于那些经营自己的私人诊所的人来说,运营开销可能会严重阻碍其业务的效率。我经常与小企业主(尤其是医疗保健行业的小企业主)交谈,他们每五个工作日就会抽出一个时间来专注于这些管理任务,这实际上使他们的收入机会减少了 20%。 一体化业务公司通过将运营负担转移到平台上来解决这个问题。专业人士拥有自己的执业权,会见客户,并在其许可范围内进行执业。该平台处理其他一切。 人工智能如何改变单位经济效益 盒装业务并不是一个新概念。心理健康领域的 Headway 和 Alma 以及美容服务领域的 GlossGenius 等公司已经建立了支持独立从业者的规模化平台。第一代公司受到服务每个提供商的成本的限制。运营工作——计费、认证、合规——仍然需要大量的人力。这迫使平台收取高额费用(通常为系列的 20-25%),并专门专注于拥有足够数量的垂直行业来吸收这些成本。 但是——如果你以前见过我写过这篇文章,请阻止我——人工智能从根本上改变了这种微积分。堆栈中每个功能提供实践支持服务的边际成本正在崩溃。人工智能代理可以以人类劳动力成本的一小部分来执行许多此类操作任务。在整个支持堆栈中,AI 原生操作可以将服务成本降低 70-85%。 这种成本压缩有两个复合效应。首先,它允许平台收取较低的费用,同时保持与人工智能之前的前辈相当或更好的毛利率。与收取 25% 传统员工费用的平台相比,收取 12% – 15% […]

你的数据智能体需要上下文 大模型内核
Mar 23, 2026

你的数据智能体需要上下文

作者:Jason Cui & Jennifer Li | 来源:SandHill.io 你的数据智能体需要上下文 URL: https://www.a16z.news/p/your-data-agents-need-context 是时候开始构建了。 超过 220,000 名订阅者 你的数据智能体需要上下文 市场已经意识到,没有合适的上下文,数据和分析智能体基本上是无用的 关于上下文的上下文 最近,在数据和 AI 智能体的世界里,上下文层和图已经成为一个有趣的讨论话题。事实上,如今与一个处理数据和 AI 的组织进行对话,很难不谈及上下文这个话题。 这是有充分理由的。在过去的一年里,市场已经意识到,没有合适的上下文,数据和分析智能体基本上是无用的——它们无法理清模糊的问题、解读业务定义,以及有效地跨不同数据进行推理。 当然,这不是它们的错。现代数据栈经历了十多年的转变,从分散的数据源到整合的数据和清晰的定义(这是好事),但即便如此,整合也从未完美,并且引入了大量的混乱。市场的总体演变如下: 1) 现代数据栈的兴起 – 我们过去曾与 dbt 的 Tristan Handy 以及在我们自己的参考架构中探讨过现代数据栈的变革性崛起。过去十年的总体演变已经改变了数据架构,涵盖了数据摄取、转换、仓储和存储,以集中化数据并使其能够快速便捷地访问。其理念是,有了清晰组织的数据,团队就可以简单地编写 SQL 从他们的数据仓库中派生数据,驱动图表/仪表盘,并在整个组织内实现商业智能。 2) 智能体狂潮 – 随着 LLM 能力在 2024 年至 2025 年间的增强,几乎每个组织都希望在他们现有的数据栈之上构建和部署智能体。我们之前已经讨论过我们如何定义智能体,但从组织的角度来看,以更高效率和更少时间完成更多工作的天然吸引力,自然而然地导致了向智能体工作流的倾斜。公司试图构建“与你的数据聊天”的聊天机器人、支持智能体等。这场狂潮既是自下而上的,也是自上而下的——开发者希望利用最新、最炫的 LLM 功能,而领导层则施加 AI 采用的压力,以增加自动化并降低成本。 3) 撞上南墙 – 尽管最初很乐观,但很快就清楚了,这些努力大多都失败了。组织试图部署他们的智能体,但却撞了南墙。麻省理工学院(MIT)著名地发布了他们的《2025 年商业 AI […]

别信你的代理。信任你的边界:用于 LLM 工具调用的运行时授权层。 大模型内核
Jan 28, 2026

别信你的代理。信任你的边界:用于 LLM 工具调用的运行时授权层。

如果你的“代理”能做任何真实的事情,比如发放退款、修改生产数据、更新基础设施或给客户发电子邮件,你就越过了一条界限。困难之处不再是模型是否能建议正确的操作。困难之处是你是否能证明在高风险操作执行之前该操作已被授权。代码:https://github.com/lemnk/Sudo-agent 这就是有代理系统中的信任缺口: 模型的推理是概率性的。 副作用是确定性的且不可逆的。 大多数团队试图通过提示约束、临时允许列表或在代理需要执行多项任务时就会被过度授权的 IAM 角色来弥合这一差距。这些工具有帮助,但它们无法为“意图”和“执行”之间提供一个单一、严格且可审计的边界。 SudoAgent 的使命刻意设定得很窄:为工具和函数调用提供一个运行时授权层,采用确定性控制和可证明的可问责性,通过执行以下规则: 除非能够证明合规性,否则不得执行此动作。 Press enter or click to view image in full size 为什么“记录日志”还不够 安全团队已经在记录日志。但大多数日志是可变的操作性工件,而非证据。 如果你依赖普通的应用日志或数据库审计表,你就隐式地信任了写入它们的机器。如果主机被攻破,有决心的攻击者通常可以在事后更改或删除这些记录。 安全研究几十年来一直把这视为核心问题:如何在不受信任的机器上保存审计记录,同时使对过去条目的篡改在不被发现的情况下变得困难。Schneier 和 Kelsey 关于安全审计日志的经典工作直接阐明了这一点:一旦写入,应该使先前的日志条目不可能被未被发现地修改或销毁。(schneier.com) 所以 SudoAgent 将证据视为一等工件: 在执行之前写入决策记录(失败则封闭) 在执行之后写入结果记录(尽力而为) 使分类账抗篡改(哈希链 + 规范化) 可选择添加签名以证明真实性 这也在方向上与监管与治理的发展保持一致。欧盟人工智能法明确要求高风险人工智能系统支持事件的自动记录(日志),并在适当期限内保存日志(第 19 条的摘要至少为六个月)。(ai-act-service-desk.ec.europa.eu) NIST 的 AI 风险管理框架是自愿性的,但它为可信 AI 风险管理和在治理职能中的操作化建立了共同语言。(nist.gov) 核心思想:确定性的边界 SudoAgent 不是一个代理框架。它不会编排多步骤计划、对工具进行排序或“让代理更聪明”。它围绕着最后一个关键步骤设定边界:会导致副作用的调用。 在运行时,对于每个工具/函数调用,SudoAgent 会执行: 首先进行脱敏处理 从脱敏后的 args/kwargs 构建上下文(以避免秘密泄露并保持可共享的证据安全)。 2 […]

构建可靠的 LLM 批处理系统 大模型内核
Jan 28, 2026

构建可靠的 LLM 批处理系统

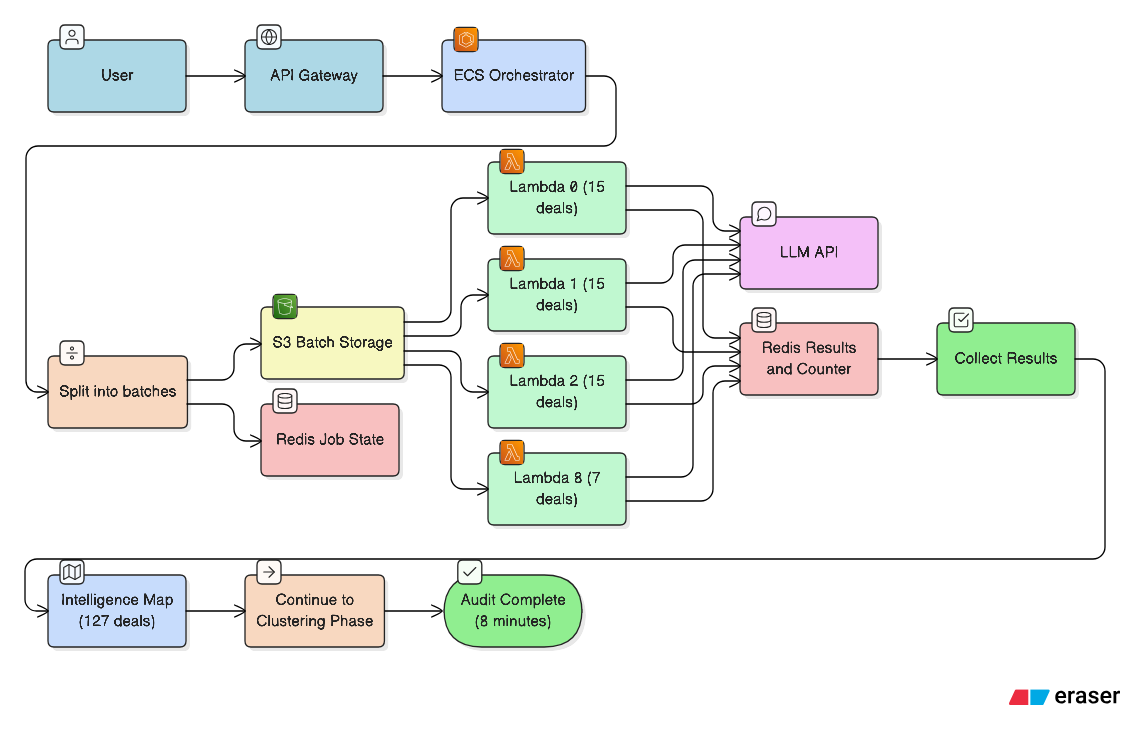
面向长时运行工作负载的实用扇出架构 今天,我们有一篇由独一无二的 来宾作者 Alexandru Vesa 撰写的文章。Alex 是一名 ML / AI 工程师、创始人,也是 Hyperplane 出版物的创始人。 Alex 把时间花在真实世界的 AI 系统一线,在那里问题不是理论上会失败……而是在凌晨 3 点没有日志、半数数据丢失时才暴露出来! 在这篇文章中,他将带我们学习如何构建可靠的 LLM 批处理处理系统 ,并以一个真实的生产用例为基础。 祝阅读愉快! Miguel 用于 LLM 批处理系统的分发模式 🙋 在构建任何分布式系统之前,花一分钟问自己: 当它出故障时会发生什么? 如果你正在用 LLMs 处理批量工作负载,你很可能碰到过这个难题: 文档处理 :需要分析 500 份合同,每份约 20 秒。Lambda 在第 45 份合同时超时。 数据丰富 :需要调研 200 家公司资料,每家需调用 3 次 API。任务在 14:58 终止。 报告生成 :80 份月度报告,每份需要 LLM 生成摘要。完成一半,另一半丢失。 图片处理流程 :300 张产品图片需添加图注。进度条停在 23%。 模式总是一样:你的工作负载能处理 10 个条目。然后一个顾客发送了 100 个条目,一切就崩溃了。 👉 […]

揭秘 Apple 的 AI 大变革及其两款新版 Siri 的计划 大模型内核
Jan 26, 2026

揭秘 Apple 的 AI 大变革及其两款新版 Siri 的计划

Apple 正在通过与 Google 的合作、管理层变动以及两个新版本的 Siri 来重塑其 AI 业务。此外:该公司正准备启动 2026 年的 Mac 发布活动,并让首席执行官候选人 John Ternus 负责设计工作 。 阵容 Tim Cook、John Giannandrea 和 Craig Federighi 在 2024 年讨论 Apple Intelligence。 摄影师:David Paul Morris/Bloomberg 2025 年 6 月,我报道了 Apple 公司内部的一个重大转折点 。在 Apple Intelligence 平台发布表现平平以及新版 Siri 数字助理推迟之后,软件主管 Craig Federighi 和其他高管曾认真考虑搁置公司的内部 AI 模型,转而采用第三方供应商。 这篇报道在 Apple 负责构建底层 AI 技术的基础模型团队中引起了巨大震动。除了声誉受损,该报告还引发了关于该团队未来以及员工生计的存亡问题。在 6 月 30 日该报道发布后的几小时内,Apple 的 AI 高层便采取行动以控制负面影响。 […]

上下文是让系统不可替代的关键 大模型内核
Jan 26, 2026

上下文是让系统不可替代的关键

本文信息来源:anneliesgamble 对话 Glean 创始工程师 Chaitanya Asawa 上下文不仅仅是一个组织拥有的文档,它还涵盖了这些文档与组织成员之间互动的一切。谁做决策?谁负责审批流程?如何处理异常情况?谁是直接责任人(DRI)?Foundation 最近发表了一篇精彩的文章 ,将其定义为一个组织的“上下文图谱”。我们也看到开发者生态系统中出现了大量努力,因为团队正在努力解决在构建大型、快速迭代的代码库代理时,如何保留上下文的问题。 弥补上下文鸿沟是构建企业级 AI 产品的关键环节。这是产品学习定制化工作流的方式,并最终以此赢得代理执行动作所需的信任。 Glean 是从第一天起就将上下文置于首位的最佳公司案例之一,这也有助于解释它为何能成为当今企业级 AI 领域的领导者之一。Chaitanya (Chai) Asawa 是我的挚友,也是 Glean 的创始工程师之一。在经历了 6 年多的历程后,他最近离职并加入 Abridge,负责临床决策支持的工程领导工作。但在他离开之前,我们见了一面,聊了聊他在 Glean 的时光、他在公司建设过程中的所学,以及为什么上下文在他们的故事中如此重要。 从企业搜索到工作助手 2021 年,当我第一次问 Chai 为什么会押注一家一无所有的微型初创公司时,我记得他告诉我,在我们的个人生活中,获取信息感觉是毫不费力的。你几乎可以向 Google 询问任何事情并立即得到答案。但在工作中,情况并非如此。信息碎片化地分布在电子邮件、文档、Slack、CRM、内部工具以及没人相信其时效性的维基百科中。Glean 的使命就是解决这个问题,而 Chai 深信这一使命。快进到今天,在很大程度上,他们已经实现了这一使命。 “Glean 认为搜索是有史以来最强大的技术之一,而职场搜索却已经失效了,”Chai 说道。在早期,Glean 看起来像是一个经典的搜索产品。用户可以输入查询并获得相关的链接。 在构建这款早期搜索产品的过程中,Glean 整合了一个组织的所有数据。它连接了公司内部几乎所有的系统,并构建了一张信息在组织中流动的动态地图。 随着 AI 的成熟和 2022 年 ChatGPT 时刻的到来,这一基础被证明是至关重要的。Glean 现在拥有了通过构建企业搜索所积累的全部上下文,并可以开始向更像工作助手的方向迈进。它能直接回答问题,以公司数据为依据,并支持工作流中的执行。 上下文胜过模型能力 由于 Glean 并不构建自己的基础模型,其优势并不在于拥有更好的模型,而在于它对组织行为有着更深刻的理解。它不仅拥有内容,还拥有围绕这些内容的所有上下文。“最难的部分不仅仅是匹配关键词。用户输入的查询只有两三个词,信息量很少,”Chai 告诉我,“关键在于理解所有的信号,从而洞察该组织内部问题背后的意图 。” 在大型组织中,同样的请求根据角色、地点、团队等因素可能意味着不同的事情。“正确”的答案可能因地点而异,例如旧金山办公室的政策与纽约办公室的政策就有所不同。同一行业的两家公司可能会以完全不同的方式运行“相同”的工作流。 […]

大模型内核
Jan 19, 2026

软件工程师再也不能忽视软技能

本文信息来源:qu8n 从2026年起,沟通能力已成为软件工程师最重要的技能。 这不再是写代码、做系统设计,或掌握某种编程语言(如 Rust)的晦涩知识。 AI 编程代理已经变得非常、非常强大 。一年前,我还会谨慎地找 Cursor 来做 MVP 或快速修补。如今,我几乎把所有非琐碎的编程任务都交给 Claude Code,仅去年 12 月就在它身上花了 500 多美元。 线上关于 AI 的讨论很大程度上仍围绕硬技能展开:一开始是用提示技巧完成 X,然后是做 Y 最好的 MCP,如此等等。但随着 Opus 4.5 的到来,只用原生的 Claude Code 就能完成 80% 的工作。即便在 AI 时代,二八法则依然适用。那么,工程师究竟该把精力放在哪里? 使用编码代理时,有一点很重要:规格说明越完善,它们就越能贴合技术和业务需求。但要拿到一份好的规格说明并不容易。 在现实中,工单很少包含所有需求。要做到这一点,你可能需要: 提出问题,揭示人们自己都未意识到的隐含假设 推动并促进取舍权衡的讨论 在不烧毁人际关系的情况下,对工作范围提出反对意见 对那些没人想到要明确说明的事情作出判断 过去,把这些事情做好对一线贡献者来说曾是可有可无的。有些团队可以让工程师即便沟通能力平平、但编码能力出色,也能表现出色。如今,非编码部分正变得不可妥协。 软件工程师是问题解决者。我们相信每个问题都有解决方案,都存在一种“最佳实践”。但与人打交道却充满混乱。 不幸的是,我们无法依靠 AI 走捷径来获得更好的沟通技能。良好的沟通需要同理心,而在当今的环境中,我们都需要多一点这样的能力。